TL;DR: I servizi di sviluppo di software di riconoscimento delle emozioni su misura costruiscono modelli che deducono stati emotivi da volto, voce, testo o segnali fisiologici e li integrano nel vostro prodotto. Prevedete 25.000–60.000 $ per un proof of concept e 80.000–450.000 $ e oltre per la produzione. Nell'UE l'inferenza delle emozioni da dati biometrici è vietata nei luoghi di lavoro e nelle scuole, salvo per motivi medici o di sicurezza.
I servizi di sviluppo di software di riconoscimento delle emozioni su misura trasformano modelli che leggono segnali emotivi su volti, voci, testi o sensori corporei in una funzionalità operativa e conforme all'interno del vostro prodotto. I committenti raramente sono laboratori di ricerca. Sono piattaforme di contact center che vogliono individuare presto un chiamante frustrato, team healthtech che creano strumenti per il monitoraggio dell'umore e il supporto terapeutico, case automobilistiche che aggiungono avvisi di sonnolenza e gruppi media che testano come il pubblico reagisce a uno spot o a un trailer.
Nella pratica, una funzionalità di rilevamento delle emozioni raramente è un modello isolato. Si colloca tra una telecamera o un microfono, un'app esistente, un CRM o uno stack video e una serie di vincoli legali, e la maggior parte del lavoro di ingegneria riguarda questi punti di raccordo. Per questo impostiamo questi progetti come parte dei nostri servizi di integrazione dell'IA generativa e non come pura ricerca: il modello è un componente, e integrazione, flusso di consenso e monitoraggio decidono se sopravvive in produzione.
Il momento conta nel 2026. Le stime di mercato variano molto, ma MarketsandMarkets valuta il mercato del rilevamento e riconoscimento delle emozioni a 29,14 miliardi di dollari nel 2026. Allo stesso tempo, l'AI Act vieta il riconoscimento delle emozioni nei luoghi di lavoro e nelle scuole da febbraio 2025, e il Digital Omnibus ha ridefinito il calendario dell'alto rischio. Questa guida spiega cosa comporta uno sviluppo su misura, quanto può essere accurato, dove passano i confini legali, cosa conviene comprare e cosa costruire, e quanto costa.
Che cos'è lo sviluppo di software di rilevamento delle emozioni su misura?
Lo sviluppo di software di rilevamento delle emozioni su misura è la progettazione, l'addestramento e l'integrazione di modelli di IA che stimano lo stato emotivo di una persona da segnali osservabili, calibrati sui dati, sui dispositivi e sul contesto legale di un'azienda. Il risultato non è un punteggio da lettura del pensiero. È la probabilità che un insieme di segnali, ad esempio un aggrottare delle sopracciglia insieme a un tono di voce che sale, corrisponda a un'etichetta come «frustrato», accompagnata da un valore di confidenza su cui il prodotto può agire.
Tre termini vengono spesso confusi, e la differenza conta sia per l'ingegneria sia per il diritto:
- Il rilevamento delle emozioni segnala che è presente uno stato emotivo o un suo cambiamento, ad esempio «il livello di stress del chiamante sta salendo».
- Il riconoscimento delle emozioni classifica quale emozione sia, spesso in categorie come rabbia, gioia o sorpresa. L'AI Act usa «sistema di riconoscimento delle emozioni» come termine giuridico.
- La sentiment analysis valuta un testo come positivo, negativo o neutro. È un compito affine ma più ristretto, e l'analisi del solo testo è trattata diversamente dal diritto UE.
I modelli differiscono anche per l'output. I modelli categoriali prevedono una tra sei o sette emozioni di base (rabbia, disgusto, paura, gioia, tristezza, sorpresa, spesso più neutro o disprezzo). I modelli dimensionali prevedono valori continui, di solito la valenza (quanto positivo o negativo) e l'arousal (quanto calmo o attivato). Gli output dimensionali sono spesso più utili nei prodotti, perché «arousal crescente con valenza negativa» si traduce in una regola di business in modo più pulito di una singola etichetta.
«Su misura» è la parola chiave. Le API standard sono addestrate su dati generici, spesso volti in posa o parlato recitato. Uno sviluppo su misura adatta i modelli al vostro dominio (un abitacolo di notte, una televisita con una webcam economica, una linea di call center molto compressa), ai limiti hardware come l'inferenza on-device e alle regole di conformità dei mercati in cui vendete.
Come funziona un software di riconoscimento delle emozioni?
Un software di riconoscimento delle emozioni funziona come una pipeline: acquisisce un segnale, ne isola la parte rilevante, estrae caratteristiche correlate alle emozioni, le classifica e trasforma il risultato in un evento di business. Le fasi sono simili per tutte le modalità, per questo i team che già si occupano di sviluppo di computer vision o di elaborazione del parlato possono riutilizzare buona parte del loro stack.
- Acquisizione. Fotogrammi video da una telecamera o da uno stream WebRTC, audio da un microfono o dalla registrazione di una chiamata, testo da chat o trascrizioni, oppure dati da un sensore indossabile.
- Rilevamento e punti di riferimento. Individuare il volto e i suoi punti chiave (occhi, sopracciglia, angoli della bocca), rilevare l'attività vocale e separare i parlanti, oppure segmentare il testo in enunciati.
- Pre-elaborazione e normalizzazione. Allineare e ritagliare i volti, correggere la luce, ricampionare e ripulire l'audio e normalizzare rispetto alla baseline del singolo utente quando il consenso lo consente.
- Estrazione delle caratteristiche. Per il volto, le action unit del Facial Action Coding System (FACS) o embedding appresi; per la voce, caratteristiche prosodiche come intonazione, energia e velocità di eloquio, o embedding auto-supervisionati di modelli come wav2vec 2.0 e HuBERT; per il testo, embedding da transformer.
- Classificazione o regressione. Un modello associa le caratteristiche a categorie di emozioni o a punteggi di valenza e arousal, con uno smoothing temporale su una finestra di fotogrammi o secondi.
- Fusione, confidenza e regole di business. Combinare le modalità, aggiungere un punteggio di confidenza calibrato e applicare regole come «avvisare un supervisore solo se la valenza negativa persiste per 20 secondi sopra 0,8 di confidenza». Il risultato esce tramite un'API, un evento SDK o una dashboard.
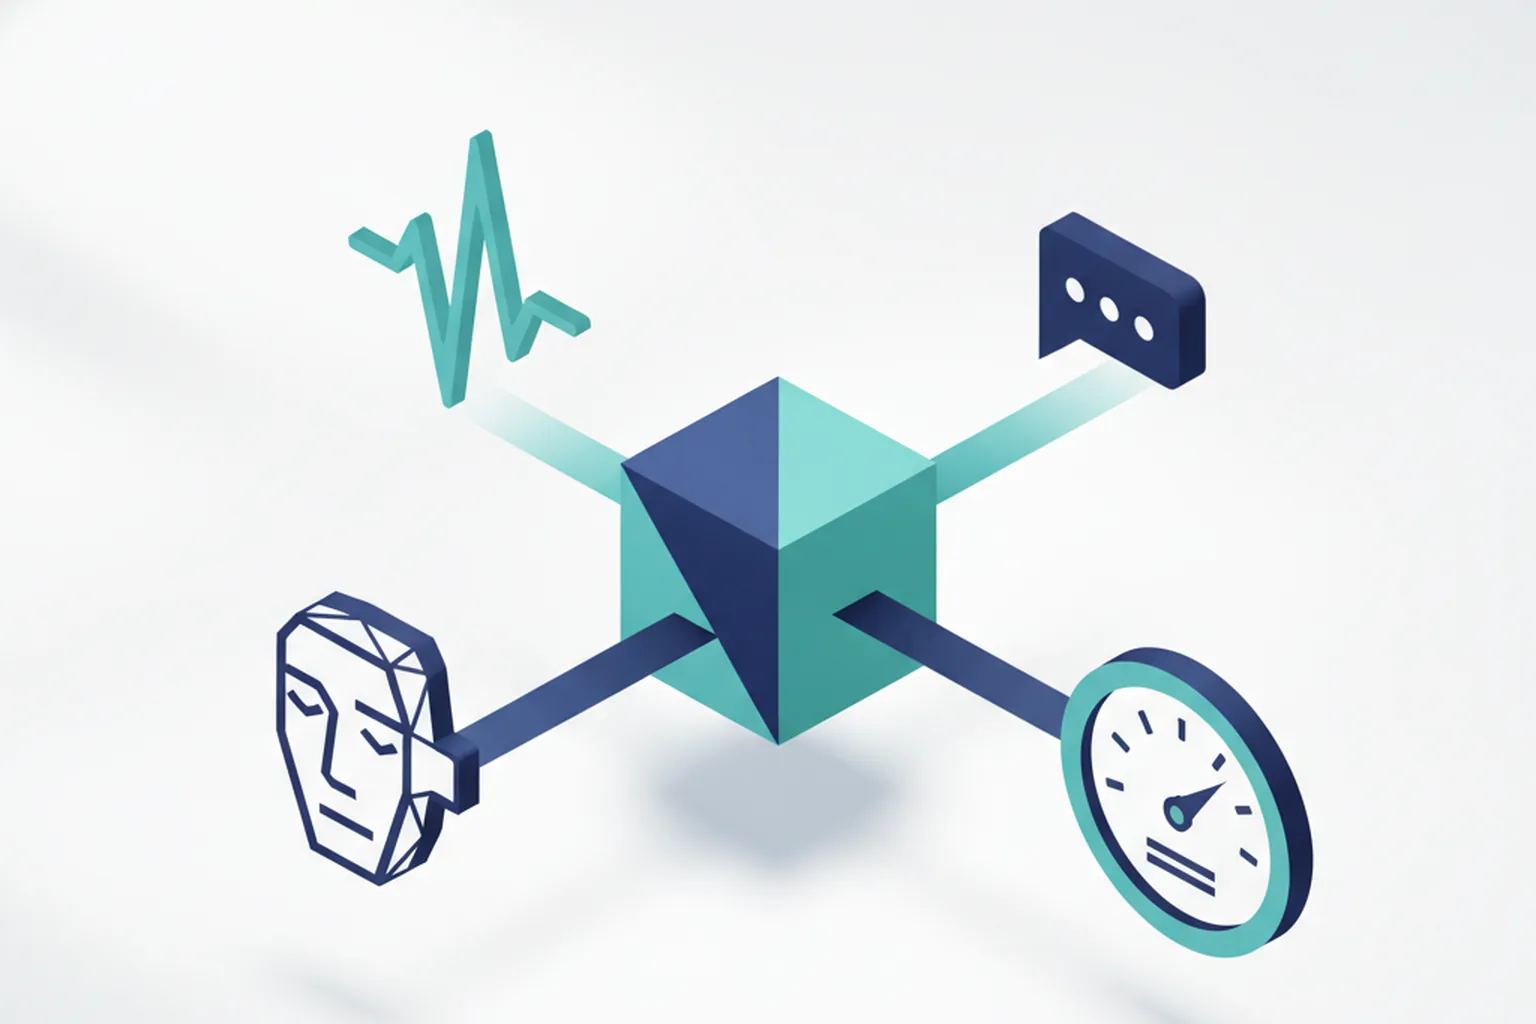
Perché la fusione multimodale batte i modelli a segnale singolo
La fusione multimodale di solito batte i modelli a segnale singolo perché ogni segnale fallisce in condizioni diverse e la loro combinazione copre le lacune. Un modello facciale va in difficoltà se l'utente distoglie lo sguardo o la stanza è buia; un modello vocale nel silenzio o nel rumore; il testo non coglie l'ironia trasmessa dal tono. Con la fusione il sistema può appoggiarsi al segnale affidabile in quel momento.
Due architetture sono comuni. La early fusion unisce le caratteristiche di tutte le modalità in un solo modello, cogliendo le interazioni ma richiedendo dati di addestramento allineati per ogni modalità. La late fusion esegue modelli separati e ne combina gli output pesandoli per confidenza. È più semplice da costruire, testare e spiegare e degrada in modo controllato se un ingresso viene meno: per questo è la nostra scelta predefinita per un primo rilascio in produzione.
Quali segnali può analizzare un software di rilevamento delle emozioni?
Un software di rilevamento delle emozioni può analizzare espressioni facciali, voce, testo, segnali fisiologici e comportamento, e ogni modalità offre un diverso equilibrio tra accuratezza, costo e rischio legale. La tabella riassume le opzioni che valutiamo in ogni progetto.
| Modalità | Input tipici | Famiglie di modelli | Punto di forza | Rischio principale |
|---|---|---|---|---|
| Volto (FER) | Webcam, fotocamera dello smartphone, telecamera di bordo | Classificatori CNN e vision transformer, rilevatori di action unit | Segnale ricco e continuo; strumenti maturi | Dati biometrici; bias legati a luce, posa e demografia |
| Voce (SER) | Chiamate, assistenti vocali, riunioni | Caratteristiche prosodiche (openSMILE), embedding wav2vec 2.0 / HuBERT | Funziona senza video; buona per l'arousal | Dati biometrici; accenti, codec e rumore |
| Testo | Chat, email, recensioni, trascrizioni | Transformer ottimizzati, classificatori LLM | Economico, scalabile, non biometrico | Non coglie tono e ironia; copertura linguistica |
| Fisiologico | Variabilità della frequenza cardiaca (HRV), attività elettrodermica (EDA), EEG | Modelli per serie temporali, gradient boosting su caratteristiche | Difficile da simulare; forte per stress e arousal | Richiede hardware; norme sui dati sanitari |
| Comportamentale | Ritmo di digitazione, movimenti del mouse, sguardo, postura | Modelli sequenziali, rilevamento di anomalie | Passivo, nessuna telecamera | Segnale debole; può comunque essere biometrico |
| Multimodale | Due o più degli input precedenti | Late o early fusion, transformer cross-modali | Il più robusto in condizioni reali | Costo maggiore; più difficile da annotare e spiegare |
Una regola pratica: partite dal segnale più economico che risponde alla vostra domanda di business. Se volete solo sapere se le chat di assistenza stanno andando male, l'analisi del testo può bastare ed evita gran parte delle norme biometriche. Aggiungete volto o voce solo se il caso d'uso richiede segnali non verbali in tempo reale e la valutazione legale descritta più avanti lo consente.
Cosa includono i servizi di sviluppo di riconoscimento delle emozioni su misura?
I servizi di sviluppo di software di riconoscimento delle emozioni su misura coprono l'intero percorso da una domanda legale e di business fino a un modello monitorato in produzione, non solo l'addestramento. Un incarico completo comprende in genere sette filoni di lavoro:
- Discovery e valutazione legale preliminare. Chi viene analizzato, in quali Paesi e per quale decisione; se l'uso è vietato, ad alto rischio o a basso rischio; quali consensi e informative servono.
- Strategia dei dati e annotazione. Scegliere dataset pubblici per il pre-addestramento, raccogliere registrazioni proprie con consenso, scrivere linee guida di annotazione e coordinare più annotatori. Di solito se ne occupa il nostro team di IA, ML e data engineering.
- Scelta e fine-tuning dei modelli. Confrontare baseline open source e commerciali, poi ottimizzare la migliore sui dati del vostro dominio.
- Valutazione di bias e accuratezza. Misurare le prestazioni per gruppo demografico, dispositivo, condizione di luce e lingua, e documentare i risultati.
- Deployment edge o cloud. Impacchettare i modelli con ONNX Runtime o TensorRT per smartphone, browser, dispositivi NVIDIA Jetson o server GPU, entro un budget di latenza.
- Integrazione. SDK per iOS e Android, hook WebRTC per le videochiamate, API REST o streaming e connettori verso CRM, piattaforme di contact center e analytics.
- MLOps e documentazione di conformità. Monitoraggio del drift, cicli di riaddestramento, log di audit, model card e valutazioni d'impatto sulla protezione dei dati (DPIA).
Quando confrontate le offerte, verificate che ci siano tutti e sette i filoni. Un preventivo che copre solo lo «sviluppo del modello» di solito vi lascia scoprire più tardi le parti più costose: UX del consenso, test dei bias e documentazione.
Dove si usa il rilevamento delle emozioni nel 2026?
Nel 2026 il rilevamento delle emozioni si usa soprattutto nella customer experience, nelle ricerche di mercato, nella sanità, nella sicurezza automobilistica e nei media, mentre gli usi sul lavoro e nell'istruzione sono vietati nell'UE. Lo status legale dipende meno dal settore che da chi viene analizzato e perché, quindi la tabella abbina ogni caso d'uso alla sua posizione nell'UE.
| Settore | Caso d'uso | Status legale nell'UE |
|---|---|---|
| Assistenza clienti e contact center | Rilevare la frustrazione di chi chiama, instradare verso un operatore senior, valutare l'esito delle chiamate | Lato cliente consentito come alto rischio; analisi delle emozioni degli operatori vietata |
| Ricerche di mercato e test pubblicitari | Misurare le reazioni a spot, trailer e concept di prodotto | Consentito con panel consenzienti; si applicano gli obblighi di alto rischio |
| Healthtech e salute mentale | Monitoraggio dell'umore, supporto terapeutico, segnali precoci di depressione o dolore | Possibile eccezione medica; può essere anche un dispositivo medico ai sensi dell'MDR |
| Automotive | Monitoraggio del conducente per sonnolenza, distrazione e attenzione | Finalità di sicurezza; il rilevamento della stanchezza in genere esula dalla definizione di emozione |
| Gaming e media | Difficoltà adattiva, contenuti personalizzati, analisi delle reazioni | Consentito con opt-in; si applicano obblighi di trasparenza |
| E-learning | Valutazione del coinvolgimento o dell'attenzione degli studenti | Vietato negli istituti di istruzione dell'UE |
| HR e selezione | Punteggi emotivi nei colloqui video, monitoraggio dell'umore dei dipendenti | Vietato nell'UE (luogo di lavoro, selezione inclusa) |
La sanità è il settore in cui il potenziale è più chiaro e le regole più stratificate. Se state sviluppando un prodotto per il monitoraggio dell'umore o il supporto terapeutico, il nostro team di sviluppo software healthtech tratta i segnali emotivi come dati clinici fin dal primo giorno e verifica la classificazione come dispositivo medico prima del primo sprint. Nell'automotive, le linee guida sull'AI Act distinguono gli stati fisici come stanchezza o dolore dalle emozioni, quindi un rilevatore di sonnolenza è di norma un sistema di sicurezza e non un sistema di riconoscimento delle emozioni. Gli usi video non legati alle emozioni, come il monitoraggio della sicurezza in fabbrica, sono trattati nella nostra guida allo sviluppo software di video analisi con IA.
Quanto è accurato davvero il riconoscimento delle emozioni?
Il riconoscimento delle emozioni è molto meno accurato in condizioni reali che in laboratorio. I benchmark pratici pubblicati da Fora Soft nel 2026 indicano per i modelli facciali circa il 90% di accuratezza su dataset in posa come CK+ e RAF-DB, ma solo il 63–70% circa su dati categoriali reali come AffectNet. I vostri risultati in produzione dipenderanno da telecamere, utenti ed etichette.
Tre fattori spiegano il divario:
- Espressioni in posa o spontanee. I dataset di laboratorio usano attori con espressioni chiare ed esagerate. Gli utenti reali mostrano espressioni sottili, miste o represse, spesso per meno di un secondo.
- Le espressioni non sono sentimenti. Gli psicologi discutono ancora su quanto i movimenti del volto riflettano in modo affidabile gli stati interiori. Un sorriso può essere cortesia, un cipiglio concentrazione. Un modello rileva l'espressione, non l'emozione provata.
- Contesto, cultura e demografia. Le regole di espressione variano tra culture e i dati di addestramento sono spesso sbilanciati per età, carnagione e genere. I modelli addestrati su dati sbilanciati funzionano peggio sui gruppi sottorappresentati.
L'impostazione corretta per qualsiasi prodotto è: dedurre segnali, non la verità. In pratica significa punteggi di confidenza calibrati, soglie tarate sui vostri dati di validazione, aggregazione nel tempo invece che su singoli fotogrammi e una persona nel ciclo per ogni decisione che riguarda qualcuno. Riportate l'F1 macro per classe per le categorie, o la correlazione di concordanza per valenza e arousal, invece di un unico numero di accuratezza. La stessa disciplina di valutazione vale per qualsiasi progetto di sviluppo software di machine learning, ma i modelli di emozione sono particolarmente inclini a brillare in demo e fallire in silenzio sul campo.
Il riconoscimento delle emozioni è legale? AI Act, GDPR e norme USA
Il riconoscimento delle emozioni è lecito in molti contesti, ma nell'UE è vietato nei luoghi di lavoro e negli istituti di istruzione ed è considerato ad alto rischio quasi ovunque altrove. Fuori dall'UE, leggi sulla privacy biometrica come il BIPA dell'Illinois impongono propri obblighi di consenso. L'analisi legale determina l'architettura, quindi va fatta all'inizio del progetto, non prima del lancio.
Cosa vieta l'AI Act
L'articolo 5, paragrafo 1, lettera f, dell'AI Act vieta i sistemi di IA che deducono le emozioni di una persona nel luogo di lavoro o negli istituti di istruzione, salvo quando il sistema è usato per motivi medici o di sicurezza. Il divieto si applica dal 2 febbraio 2025. Le violazioni possono essere sanzionate fino a 35 milioni di euro o al 7% del fatturato mondiale annuo, se superiore.
Diversi dettagli determinano cosa potete costruire:
- Il divieto riguarda l'inferenza biometrica. L'articolo 3, punto 39, definisce un sistema di riconoscimento delle emozioni come un sistema finalizzato a identificare o dedurre emozioni o intenzioni di persone «sulla base dei loro dati biometrici», come volto o voce. Dedurre emozioni dal solo testo scritto esula dal divieto, secondo l'analisi delle linee guida della Commissione del Future of Privacy Forum.
- Le eccezioni sono strette. I motivi medici e di sicurezza sono interpretati in modo restrittivo. Benessere generale, monitoraggio dello stress o programmi di «felicità dei dipendenti» non rientrano.
- I clienti non sono dipendenti. Dedurre le emozioni dei clienti non è vietato. Ma un sistema che cattura anche il personale, come la voce di un operatore in una chiamata registrata, ha bisogno di tutele per non dedurre le emozioni dei dipendenti.
- La selezione rientra nel luogo di lavoro. Dare punteggi emotivi ai candidati nei colloqui video ricade nel divieto.
Dove il riconoscimento delle emozioni resta lecito ma ad alto rischio
Il riconoscimento delle emozioni non vietato è classificato ad alto rischio ai sensi dell'allegato III, punto 1, lettera c, dell'AI Act, con obblighi di gestione del rischio, governance dei dati, documentazione tecnica, registrazione dei log, sorveglianza umana e test di accuratezza. Il Digital Omnibus sull'IA, adottato il 29 giugno 2026 e in vigore dal 27 luglio 2026, ha spostato l'applicazione degli obblighi per i sistemi ad alto rischio autonomi dell'allegato III al 2 dicembre 2027, e al 2 agosto 2028 per l'IA integrata in prodotti coperti dall'allegato I.
Due cose non sono cambiate. I divieti dell'articolo 5 non sono stati allentati. E gli obblighi di trasparenza dell'articolo 50 si applicano comunque dal 2 agosto 2026: ai sensi dell'articolo 50, paragrafo 3, i deployer di un sistema di riconoscimento delle emozioni devono informare le persone esposte. Un prodotto che oggi raggiunge utenti UE ha quindi bisogno di informative chiare già adesso, anche se il regime completo dell'alto rischio arriverà a fine 2027.
GDPR e leggi biometriche statunitensi
Il GDPR si applica ogni volta che il rilevamento delle emozioni tratta dati personali, e i dati del volto o della voce diventano dati biometrici di categoria particolare ai sensi dell'articolo 9 quando servono a identificare una persona o rivelano informazioni sulla salute. In pratica, la maggior parte dei progetti sulle emozioni nell'UE richiede una DPIA, una base giuridica chiara (spesso il consenso esplicito), minimizzazione dei dati e conservazione breve. Il nostro team di consulenza sulla conformità al GDPR raccomanda di solito di elaborare i fotogrammi sul dispositivo e di conservare solo punteggi aggregati, mai i volti grezzi.
Negli Stati Uniti non esiste un equivalente federale, ma le leggi statali pesano. Il Biometric Information Privacy Act (BIPA) dell'Illinois richiede un consenso scritto prima di raccogliere la geometria del volto o impronte vocali e riconosce alle persone un diritto di azione privato, il che lo ha reso una fonte frequente di class action. Il CCPA californiano, modificato dal CPRA, tratta i dati biometrici usati per identificare un consumatore come informazioni personali sensibili, con diritti aggiuntivi di informativa e limitazione. Texas e Washington hanno proprie leggi biometriche. Se vendete a clienti UE dagli Stati Uniti, la nostra guida sul GDPR per i founder statunitensi che vendono nell'UE copre le basi transfrontaliere.
Per un programma di conformità completo su tutto il vostro portafoglio di IA, vedete la nostra consulenza sulla conformità all'AI Act e la pratica checklist sull'AI Act per i team SaaS. Questa sezione è un'informazione generale e non una consulenza legale; verificate il vostro caso specifico con un legale.
Sviluppare un software di rilevamento delle emozioni su misura: 7 fasi
Sviluppare un software di rilevamento delle emozioni su misura richiede sette fasi, e le prime due, valutazione legale e metriche di successo, decidono se le altre cinque valgono la pena. Questo è il processo che seguiamo nei progetti per i clienti.
- Valutazione legale e definizione del caso d'uso. Rispondete alle tre domande precedenti, poi mettete per iscritto l'unica decisione che il segnale emotivo deve supportare, ad esempio «passare una chat a una persona quando la frustrazione è probabile». Se non sapete nominare la decisione, il modello non vi serve ancora.
- Metriche di successo e piano dei dati. Concordate gli obiettivi (F1 macro, correlazione di concordanza, latenza, tasso di falsi allarmi) e la baseline da superare. Pianificate quali dati raccogliere, da chi, con quale consenso e per quanto tempo.
- Raccogliere e annotare i dati con consenso. Dataset pubblici come AffectNet e RAF-DB aiutano nel pre-addestramento, ma verificatene le licenze, spesso limitate alla ricerca non commerciale. Raccogliete registrazioni rappresentative del vostro contesto reale e fate annotare ogni campione da almeno due o tre annotatori per contenere il rumore delle etichette.
- Costruire una baseline con modelli esistenti. Confrontate componenti open source (MediaPipe per i punti di riferimento del volto, OpenFace per le action unit, DeepFace per baseline facciali rapide, openSMILE per le caratteristiche vocali, wav2vec 2.0 per gli embedding del parlato) e una o due API commerciali sul vostro test set. Spesso è questo il perimetro di un proof of concept.
- Ottimizzare, fondere e calibrare. Eseguite il fine-tuning delle baseline migliori sui vostri dati, aggiungete la fusione solo dove aiuta in modo misurabile e calibrate i punteggi in modo che «0,8» corrisponda davvero a circa l'80% di precisione sui vostri dati.
- Testare bias e robustezza. Misurate l'accuratezza per fascia d'età, carnagione, genere, accento, luce e dispositivo. Colmate le lacune prima del rilascio con più dati o ripesatura e registrate i risultati.
- Rilasciare, monitorare e documentare. Rilasciate in edge o in cloud, monitorate drift, tassi di consenso e volumi di allarmi e mantenete model card, DPIA e log di audit. Pianificate un nuovo test dei bias annuale e un budget per nuove annotazioni.
Stack tecnologico consigliato per il 2026
Nel 2026 uno stack per il rilevamento delle emozioni è fatto soprattutto di strumenti ML standard, più alcuni specialisti di affective computing. Questo è lo stack da cui partiamo e che adattiamo a ogni progetto:
| Livello | Opzioni |
|---|---|
| Rilevamento del volto e punti di riferimento | MediaPipe Face Landmarker, OpenFace (action unit), RetinaFace |
| Caratteristiche vocali | openSMILE, wav2vec 2.0, HuBERT, rilevamento dell'attività vocale |
| Testo | Classificatori transformer ottimizzati, annotazione assistita da LLM per l'avvio |
| Addestramento | PyTorch, Hugging Face, tracciamento degli esperimenti (MLflow o Weights & Biases) |
| Inferenza | ONNX Runtime, TensorRT, Core ML / TensorFlow Lite su mobile, NVIDIA Jetson in edge |
| Streaming e integrazione | WebRTC, stream gRPC o WebSocket, API REST, connettori CRM e contact center |
| MLOps e governance | Monitoraggio del drift, model registry, log di audit, model card, registri dei consensi |
Build o buy: API di emotion AI, open source o modello su misura?
Comprate un'API o un SDK di emotion AI per dimostrare il caso d'uso, assemblate uno stack open source quando vi serve controllo a basso costo e costruite od ottimizzate un modello su misura quando volume, accuratezza sui vostri dati o conformità lo rendono conveniente. La maggior parte dei progetti di successo attraversa nel tempo tutte e tre le fasi.
| Approccio | Ideale per | Tempo al valore | Profilo di costo | Controllo e conformità |
|---|---|---|---|---|
| API o SDK del fornitore | Validare la domanda, panel di ricerca, volumi bassi | Da giorni a settimane | Licenza o costi per chiamata che crescono con l'uso | Basso; i dati possono uscire dalla vostra infrastruttura; il fornitore può modificare o ritirare funzioni |
| Stack open source | Team con competenze ML, esigenze on-device, budget ridotti | Settimane | Tempo di ingegneria; nessun costo per chiamata | Alto, ma verificate le licenze di dataset e modelli per l'uso commerciale |
| Modello su misura o ottimizzato | Volumi alti, domini specifici, deployment regolamentati | Mesi | Investimento iniziale maggiore, costo unitario più basso su larga scala | Il più alto; documentazione completa, inferenza on-device, proprietà intellettuale |
I benchmark pratici di Fora Soft (2026) collocano il punto di pareggio tra comprare e costruire intorno a 40.000–60.000 sessioni al mese e citano prezzi d'ingresso di SDK commerciali come quello di Affectiva da circa 5.000 $ l'anno. Sotto quel volume un fornitore costa di solito meno; sopra, i costi per chiamata superano quelli di gestione di modelli propri.
La dipendenza dal fornitore è un rischio concreto in questo campo. Nel 2022 Microsoft ha ritirato gli attributi emotivi dalla sua Azure Face API nell'ambito del proprio Responsible AI Standard, costringendo i prodotti basati su quella funzione a cercare un'alternativa. Qualunque cosa compriate, mantenete un livello di astrazione tra prodotto e fornitore e conservate un vostro test set annotato, così da poter cambiare o costruire senza ripartire da zero.
Quanto costa lo sviluppo di un software di rilevamento delle emozioni su misura?
Lo sviluppo di un software di rilevamento delle emozioni su misura costa 25.000–60.000 $ per un proof of concept, 80.000–180.000 $ per un MVP di produzione e 200.000–450.000 $ o più per una piattaforma enterprise multimodale, secondo le fasce di progetto YuSMP per il 2026. La differenza dipende dal numero di segnali, da dove gira l'inferenza e da quanto lavoro di conformità richiede il caso d'uso.
| Perimetro | Durata tipica | Budget |
|---|---|---|
| PoC su una sola modalità (API/SDK del fornitore o FER open source), un caso d'uso | 4–8 settimane | 25.000–60.000 $ |
| MVP di produzione: una o due modalità, fine-tuning su misura, UX del consenso, dashboard | 3–5 mesi | 80.000–180.000 $ |
| Piattaforma enterprise multimodale: edge + cloud, audit dei bias, documentazione AI Act e GDPR, integrazioni | 6–12 mesi | 200.000–450.000 $+ |
I principali fattori di costo sono:
- Numero di modalità. Ogni segnale in più aggiunge raccolta dati, annotazione, un modello e lavoro di fusione.
- Edge o cloud. L'inferenza on-device protegge la privacy ma richiede compressione dei modelli e test su ogni dispositivo di destinazione.
- Volume dei dati e annotazione. Raccogliere dati con consenso e più annotatori nel vostro contesto reale è spesso la voce di costo più grande.
- Lingue e demografia. Ogni lingua, gruppo di accenti o mercato aggiunge valutazione e spesso dati.
- Livello di conformità. Gli usi ad alto rischio richiedono documentazione, log, progettazione della sorveglianza umana e report sui bias.
- Integrazioni. Piattaforme di contact center, CRM, stack video e analytics aggiungono ciascuno lavoro su connettori e test.
Le nostre fasce sono in linea con i benchmark esterni: Fora Soft (2026) stima 800–2.000 ore senior, ovvero circa 120.000–300.000 $, per aggiungere una funzionalità emotiva conforme a un'app video esistente, e osserva che gran parte di questo costo va a UX del consenso, test dei bias, log di audit e documentazione più che al ML in sé. Mettete a budget a parte i costi ricorrenti: hardware GPU o edge, nuove annotazioni periodiche, monitoraggio del drift e un test dei bias annuale.
Come scegliere un'azienda di sviluppo di software di riconoscimento delle emozioni
Scegliete un'azienda di sviluppo di software di riconoscimento delle emozioni che parta dalla valutazione legale, dimostri l'accuratezza sui vostri dati anziché sui benchmark e vi consegni tutto il necessario per gestire il sistema senza di lei. Una checklist in sette punti:
- Valutazione legale dal primo giorno. Il team chiede chi viene analizzato e dove prima di parlare di modelli.
- Metriche reali sui vostri dati. Si impegna a misurare l'accuratezza su un set riservato proveniente dal vostro ambiente, non su CK+ o su un video demo.
- Report sui bias per gruppo. Mostra i risultati per gruppo demografico e spiega come colmerà le lacune.
- Privacy by design. Propone elaborazione on-device, aggregazione e conservazione breve, non solo «cifriamo tutto».
- Trasferimento di IP e modelli. Sono vostri i pesi addestrati, le linee guida di annotazione, il codice di addestramento e i test set.
- MLOps e piano per il drift. Definisce come il modello verrà monitorato e riaddestrato dopo il lancio e chi ne sostiene i costi.
- Referenze in settori regolamentati. Ha rilasciato IA in sanità, finanza o altri settori regolamentati e può mostrare la documentazione prodotta.
Campanelli d'allarme per cui conviene lasciar perdere:
- Promesse che il sistema legga i «veri sentimenti» o rilevi le bugie.
- Accuratezza dichiarata oltre il 95% senza indicare dataset o condizioni.
- Nessun accenno a DPIA, consenso o AI Act per un deployment nell'UE.
- Una proposta per monitorare le emozioni di dipendenti o studenti nell'UE.
La stessa logica di valutazione vale per qualsiasi azienda di sviluppo di software di rilevamento delle emozioni, che sia una boutique specializzata o un partner IA generalista. Chiedete un esempio di model card e un esempio di DPIA da un progetto precedente; la rapidità con cui arrivano versioni anonimizzate dice molto.
Errori comuni in produzione
La maggior parte dei progetti di rilevamento delle emozioni che falliscono in produzione fallisce per motivi operativi, non per un'architettura del modello sbagliata. I cinque errori che vediamo più spesso:
- Luce e occlusioni. Controluce, mascherine, occhiali e mani sul volto fanno crollare l'accuratezza dei modelli facciali. Testate nelle peggiori condizioni reali, non in ufficio.
- Rumore delle etichette. Gli annotatori concordano sulle emozioni molto meno che sugli oggetti. Senza più etichette per campione e metriche di accordo, addestrate sul rumore.
- Bias culturale. Un modello tarato su un mercato legge male le norme di espressione e prosodia di un altro. Valutate per mercato prima del lancio.
- Budget di latenza. Le funzioni in tempo reale richiedono risultati entro poche centinaia di millisecondi. Modelli pesanti che superano i test offline possono risultare inutilizzabili dal vivo.
- Rifiuto del consenso. Se molti utenti negano l'accesso a fotocamera o microfono, la funzione riceve meno input del previsto. Progettate fin dall'inizio un'alternativa utile, come l'analisi del solo testo.
FAQ
Cosa includono i servizi di sviluppo di software di rilevamento delle emozioni su misura?
Questi servizi progettano, addestrano e integrano modelli che deducono segnali emotivi come frustrazione, coinvolgimento o affaticamento da volto, voce, testo o dati fisiologici. Un incarico tipico comprende la valutazione legale preliminare, raccolta e annotazione dei dati, scelta e fine-tuning dei modelli, test di bias e accuratezza, deployment edge o cloud, integrazione tramite SDK o API, monitoraggio del drift e documentazione di conformità.
Quanto costa sviluppare un software di riconoscimento delle emozioni?
Secondo le fasce di progetto YuSMP per il 2026, un proof of concept su una sola modalità costa 25.000–60.000 $ in 4–8 settimane. Un MVP di produzione con una o due modalità, fine-tuning, UX del consenso e dashboard costa 80.000–180.000 $ in 3–5 mesi. Una piattaforma enterprise multimodale con inferenza edge e cloud, audit dei bias e documentazione AI Act e GDPR costa 200.000–450.000 $ o più in 6–12 mesi. Hardware, nuova annotazione e monitoraggio del drift sono costi ricorrenti aggiuntivi.
Il riconoscimento delle emozioni è vietato dall'AI Act?
In parte. L'articolo 5, paragrafo 1, lettera f, dell'AI Act vieta i sistemi di IA che deducono le emozioni sulla base di dati biometrici nei luoghi di lavoro e negli istituti di istruzione, salvo per motivi medici o di sicurezza, interpretati in modo restrittivo. Il divieto si applica dal 2 febbraio 2025, con sanzioni fino a 35 milioni di euro o al 7% del fatturato mondiale annuo. In altri contesti, ad esempio con clienti che danno il consenso, il riconoscimento delle emozioni resta lecito ma è classificato ad alto rischio ai sensi dell'allegato III.
Si può usare il rilevamento delle emozioni sui clienti di un call center?
Sì. L'analisi delle emozioni dei clienti in un contact center non è vietata dall'AI Act, ma è un uso ad alto rischio che richiede informative di trasparenza, tutele per la protezione dei dati e documentazione. Analizzare le emozioni degli operatori a partire dalla loro voce è vietato nell'UE, perché si tratta di riconoscimento delle emozioni sul luogo di lavoro. Il sistema deve quindi separare il canale cliente dal canale operatore e non conservare inferenze lato operatore.
Quanto è accurato il riconoscimento delle emozioni facciali nel 2026?
Il riconoscimento delle emozioni facciali raggiunge circa il 90% di accuratezza su dataset di laboratorio con espressioni posate come CK+ e RAF-DB, ma solo il 63–70% circa su dati reali come AffectNet, secondo i benchmark pratici pubblicati da Fora Soft nel 2026. L'accuratezza varia anche con luce, posa della testa, cultura e demografia. Un'espressione facciale è un segnale, non la prova di un'emozione provata, quindi i sistemi in produzione devono usare soglie di confidenza e revisione umana.
La sentiment analysis sul testo conta come riconoscimento delle emozioni ai sensi dell'AI Act?
Da sola no. L'AI Act definisce un sistema di riconoscimento delle emozioni come un sistema che deduce emozioni o intenzioni sulla base di dati biometrici, come immagini del volto o la voce. Dedurre emozioni dal solo testo scritto esula da questa definizione e dal divieto dell'articolo 5, paragrafo 1, lettera f. L'analisi del testo può comunque riguardare dati personali, quindi gli obblighi del GDPR, di trasparenza e di equità continuano ad applicarsi.
Quanto tempo serve per sviluppare un sistema di riconoscimento delle emozioni su misura?
Un proof of concept mirato su un solo segnale, come espressioni facciali o voce, richiede 4–8 settimane. Un MVP di produzione con modelli ottimizzati, flussi di consenso e integrazione in un'app esistente richiede di norma 3–5 mesi. Una piattaforma enterprise multimodale con deployment edge, audit dei bias e documentazione normativa completa richiede 6–12 mesi. Raccolta e annotazione dei dati con un consenso corretto sono di solito la parte più lunga.
Meglio costruire un modello su misura o usare un'API di emotion AI?
Usate un'API o un SDK di un fornitore per validare rapidamente il caso d'uso e passate a un modello su misura o ottimizzato quando volume, accuratezza sui vostri dati o conformità lo richiedono. I benchmark pratici di Fora Soft (2026) collocano il punto di pareggio dei costi intorno a 40.000–60.000 sessioni al mese. Un modello su misura consente anche l'inferenza on-device, tiene i dati biometrici fuori dai cloud di terzi ed evita il ritiro di funzionalità da parte dei fornitori.
Ultimo aggiornamento: 3 ottobre 2026. Fonti: Future of Privacy Forum, Red Lines under the EU AI Act; Covington Inside Privacy, linee guida della Commissione sulle pratiche di IA vietate; William Fry, i sistemi di riconoscimento delle emozioni nell'AI Act; Gibson Dunn, accordo sull'Omnibus dell'AI Act; MarketsandMarkets tramite Aspen Daily News, mercato del riconoscimento delle emozioni; Grand View Research, report sul mercato del riconoscimento delle emozioni (con una diversa definizione di mercato e cifre più alte); Fora Soft, Emotion Recognition Software: Best Tools in 2026; Softweb Solutions, What is emotion recognition?. Le fasce di costo sono valori di progetto YuSMP. Non costituisce consulenza legale.