
Ein Biotech-Softwareentwicklungsunternehmen entwirft, baut und betreut die Software, auf der forschungsgetriebene Biotech-Firmen arbeiten: Systeme, die Proben verfolgen, Experimente erfassen, Sequenzierungsdaten verarbeiten, Laborroboter steuern und Terabytes biologischer Daten in Entscheidungen verwandeln. 2026 liegt diese Arbeit an der Schnittstelle von drei Disziplinen – Softwareentwicklung, Data Engineering und Laborwissenschaft –, und die besten Partner beherrschen alle drei.
Biotech-Teams suchen meist dann einen externen Entwickler, wenn Standardplattformen nicht mehr zu ihrer Wissenschaft passen: ein neuer Assay, den das LIMS nicht abbilden kann, eine Sequenzierungs-Pipeline, die nicht mehr skaliert, oder ein KI-Modell, das saubere, verknüpfte Trainingsdaten braucht. Da Biotech-Software häufig mit Proben von Patienten, regulierter Herstellung oder diagnostischen Aussagen zu tun hat, muss sie dieselbe Datenintegrität erfüllen wie klinische Systeme. Deshalb behandeln wir sie als Teil unserer Softwareentwicklung für HealthTech und Life Sciences und nicht als gewöhnliche Webentwicklung.
Dieser Leitfaden erklärt, was Biotech-Softwareentwicklung umfasst, worin sie sich von Pharma-Software unterscheidet, welche Arten von Biotech-Software heute entstehen, welche Funktionen und Compliance-Regeln zählen, den Technologie-Stack, einen schrittweisen Entwicklungsprozess, realistische Kosten 2026 und wie Sie ein Biotech-Softwareentwicklungsunternehmen auswählen. Liegt Ihr Schwerpunkt eher bei Arzneimittelherstellung und klinischen Studien, beginnen Sie mit unserem Leitfaden zur Pharma-Softwareentwicklung.
Was macht ein Biotech-Softwareentwicklungsunternehmen?
Ein Biotech-Softwareentwicklungsunternehmen baut individuelle Software für biologische Forschung, Entwicklung und Produktion: Erfassung von Labordaten, Proben- und Bestandsverwaltung, Verarbeitung wissenschaftlicher Daten, Geräteintegration, Analytik und KI. Anders als ein Produktanbieter, der eine einzige Plattform verkauft, entwirft es Systeme rund um die Wissenschaft, die Daten und die Abläufe einer bestimmten Organisation.
In der Praxis umfassen „Biotech-Softwareentwicklungsdienstleistungen“ sehr unterschiedliche Aufträge – vom dreimonatigen Neubau einer Bioinformatik-Pipeline bis zur mehrjährigen Forschungsdatenplattform. Wer ein Softwareentwicklungsunternehmen für Biotechnologie sucht, trifft meist auf vier Arten von Anbietern:
| Anbietertyp | Was er liefert | Geeignet für | Grenze |
|---|---|---|---|
| Plattformanbieter (LIMS-/ELN-Produkte) | Lizenzierte Software, auf Ihr Labor konfiguriert | Standardabläufe, schneller Start, Herstellersupport | Starre Datenmodelle, Kosten pro Nutzer, Roadmap außerhalb Ihrer Kontrolle |
| Individuelle Biotech-Softwareentwickler | Maßgeschneiderte Anwendungen, Integrationen, Datenplattformen | Einzigartige Wissenschaft, proprietäre Abläufe, integrationsintensive Landschaften | Erfordert klare Produktverantwortung auf Ihrer Seite |
| Bioinformatik-Beratungen | Analyse-Pipelines, Statistik, wissenschaftliche Interpretation | Einmalige Analysen, Methodenentwicklung | Oft schwächer bei Produktionsreife und langfristigem Support |
| Systemintegratoren und Validierungsfirmen | Plattform-Rollout, CSV/CSA-Validierung, IT-Betrieb | Regulierte (GxP-)Einführungen bestehender Produkte | Wenig individuelle Produktentwicklung |
Die meisten reifen Biotech-Organisationen kombinieren diese Anbieter: ein kommerzielles ELN oder LIMS für die Standardarbeit, einen individuellen Entwicklungspartner für die Datenplattform und die Integrationen darum herum und Validierungsspezialisten für die regulierten Teile.
Worin unterscheidet sich Biotech-Software von Pharma-Software?
Biotech-Software entsteht vor allem für Forschung und Entdeckung – Experimente, biologische Daten und sich schnell ändernde Methoden –, Pharma-Software dagegen vor allem für die regulierten späteren Phasen des Arzneimittellebenszyklus: klinische Studien, GMP-Herstellung, Qualität und Pharmakovigilanz. Beide überschneiden sich, setzen aber andere Prioritäten.
| Dimension | Biotech (forschungsgetrieben) | Pharma (lebenszyklusgetrieben) |
|---|---|---|
| Hauptnutzer | Laborwissenschaftler, Bioinformatiker, Data Scientists, Automatisierungsingenieure | Klinischer Betrieb, QA/QC, Herstellung, Regulatory Affairs |
| Typische Systeme | ELN, Forschungs-LIMS, NGS-Pipelines, Multi-Omics-Plattformen, KI-Modelle | EDC, CTMS, QMS, MES, Pharmakovigilanz |
| Daten | Sehr groß und heterogen: Sequenzen, Bilder, Plattenmessungen, Spektren | Strukturierte Studien-, Chargen- und Qualitätsdaten |
| Änderungstempo | Hoch – Assays und Methoden ändern sich monatlich | Niedrig – Änderungen durchlaufen eine formale Änderungskontrolle |
| Regulierung | Datenintegrität und FAIR-Prinzipien; GLP/GMP, sobald Arbeiten in regulierte Studien oder die Produktion gehen | GxP, 21 CFR Part 11 und Computersystemvalidierung vom ersten Tag an |
| Größte technische Herausforderung | Rechenleistung skalieren und sich entwickelnde Wissenschaft modellieren | Validierung, Audit-Trails und kontrollierte Releases |
Die praktische Folge: Ein Biotech-Softwareentwicklungsunternehmen muss in der Forschung schnell liefern und zugleich einen sauberen Weg zur Validierung offenhalten, denn ein Forschungswerkzeug kann in dem Moment zum regulierten System werden, in dem seine Daten einen IND-Antrag, eine diagnostische Aussage oder eine Chargenfreigabe stützen.
Welche Organisationen brauchen individuelle Biotech-Software?
Individuelle Biotech-Software lohnt sich für Organisationen, deren Wissenschaft, Datenmengen oder Partnerschaften Standardwerkzeuge übersteigen: wagniskapitalfinanzierte Biotech-Start-ups, Plattform-Biotechs, CROs und CDMOs, akademische Core Facilities, Diagnostiklabore sowie industrielle oder landwirtschaftliche Biotech-Firmen. Jede dieser Gruppen braucht ein anderes erstes System.
- Biotech-Start-ups in der Frühphase. Beginnen meist mit einem kommerziellen ELN und ergänzen ein schlankes Register, einen Data Lake und ein bis zwei automatisierte Pipelines, sobald Sequenzierungs- oder Screening-Volumen wachsen.
- Plattform-Biotechs. Unternehmen, deren Plattform das Produkt ist – Antikörperentdeckung, Zelltherapie, synthetische Biologie –, investieren früh in eine eigene Datenplattform, weil ihr Datenmodell ihr Wettbewerbsvorteil ist.
- CROs und CDMOs. Brauchen Datentrennung zwischen Mandanten, Auftraggeberportale, Studienverfolgung und validierte Systeme, die den Audits jedes Kunden standhalten.
- Akademische und institutionelle Core Facilities. Brauchen Probenannahme, Abrechnung, Gerätebuchung und Ergebnisauslieferung für Hunderte interne Nutzer.
- Diagnostik- und klinische Genomiklabore. Brauchen Testanforderung, Probeneingang, Befundungs-Workflows und EHR-Integration nach CLIA oder IVDR.
- Industrielle, Lebensmittel- und Agrar-Biotech. Brauchen Stammbibliotheken, Fermentations- und Bioprozessdaten sowie Scale-up-Analytik eher als klinische Funktionen.
Welche Arten von Biotech-Software entstehen 2026?
Die häufigsten Arten individueller Biotech-Software sind 2026 Laborinformations- und Managementsysteme (LIMS), elektronische Laborbücher, Bioinformatik- und Sequenzierungs-Pipelines, Multi-Omics-Datenplattformen, Laborautomatisierung und Geräteintegration, KI-Werkzeuge für die Forschung, Bioprozess- und Bioproduktionssoftware sowie Diagnostikanwendungen.
| Softwaretyp | Was sie leistet | Typische Integrationen |
|---|---|---|
| LIMS | Probenregistrierung, Chain of Custody, Tests, Ergebnisse, Bestand | Geräte, ELN, ERP, Tiefkühl- und Barcode-Systeme |
| Elektronisches Laborbuch (ELN) | Protokolle, Beobachtungen, Berechnungen, experimenteller Kontext | LIMS, Register, Dateiablagen, Analysewerkzeuge |
| Bioinformatik- und NGS-Pipelines | Alignment, Variantenbestimmung, Expressionsanalyse, QC | Sequenzierer, HPC- oder Cloud-Rechenleistung, Referenzdatenbanken |
| Multi-Omics-Datenplattform | Einheitliche Speicherung, Metadaten, Suche und Analytik über Datentypen hinweg | Pipelines, ELN/LIMS, Notebooks, BI- und ML-Werkzeuge |
| Laborautomatisierung und Planung | Roboter-Orchestrierung, Plattenbelegung, Laufplanung, Gerätesteuerung | Pipettierroboter, Reader, Inkubatoren über SiLA 2 oder Hersteller-APIs |
| KI-Werkzeuge für die Forschung | Target-Identifikation, Protein- und Antikörperdesign, Hit-Triage | Assay-Daten, Strukturdatenbanken, GPU-Rechenleistung |
| Bioprozess und Bioproduktion | Chargenprotokolle, Prozessanalytik, Scale-up-Daten, MES-Anbindung | Bioreaktoren, Historians, QMS, ERP |
| Diagnostik und klinische Genomik | Testanforderung, Befundübermittlung, Patientenportale | EHR über HL7/FHIR, Kostenträger, Laborgeräte |
LIMS und elektronische Laborbücher
LIMS und ELN sind in den meisten Biotech-Laboren das führende System: Ein LIMS verwaltet strukturierte Abläufe wie Proben, Tests und Bestand, ein ELN erfasst den wissenschaftlichen Kontext – Protokolle, Beobachtungen und Begründungen. Individuelle Entwicklung lohnt sich meist dann, wenn die Entitäten eines Labors (Konstrukte, Zelllinien, Antikörper, Stämme) oder seine Abläufe nicht in ein kommerzielles Datenmodell passen oder wenn beide Systeme ein gemeinsames Register nutzen sollen, statt Daten von Hand doppelt zu erfassen.
Bioinformatik- und Sequenzierungs-Pipelines
Bioinformatik-Softwareentwicklung macht aus Rohdaten der Geräte auswertbare Ergebnisse: Demultiplexing, Alignment, Variantenbestimmung, Single-Cell- und räumliche Analysen sowie Qualitätskontrolle. Die technische Arbeit dreht sich um Reproduzierbarkeit und Skalierung – versionierte Workflows, containerisierte Werkzeuge, automatische Wiederholungsläufe und kostenkontrollierte Ausführung in Cloud oder HPC – und nicht darum, neue Algorithmen zu schreiben.
Multi-Omics- und Forschungsdatenplattformen
Eine Forschungsdatenplattform verbindet Genomik-, Proteomik-, Bild- und Assay-Daten mit den Proben- und Experiment-Metadaten, die ihnen Bedeutung geben. Sie ist die Grundlage jeder KI-Ambition: Modelle, die auf unverbundenen, schlecht annotierten Daten trainiert werden, verallgemeinern nicht. Gute Plattformen folgen den FAIR-Prinzipien – auffindbare, zugängliche, interoperable und wiederverwendbare Daten.
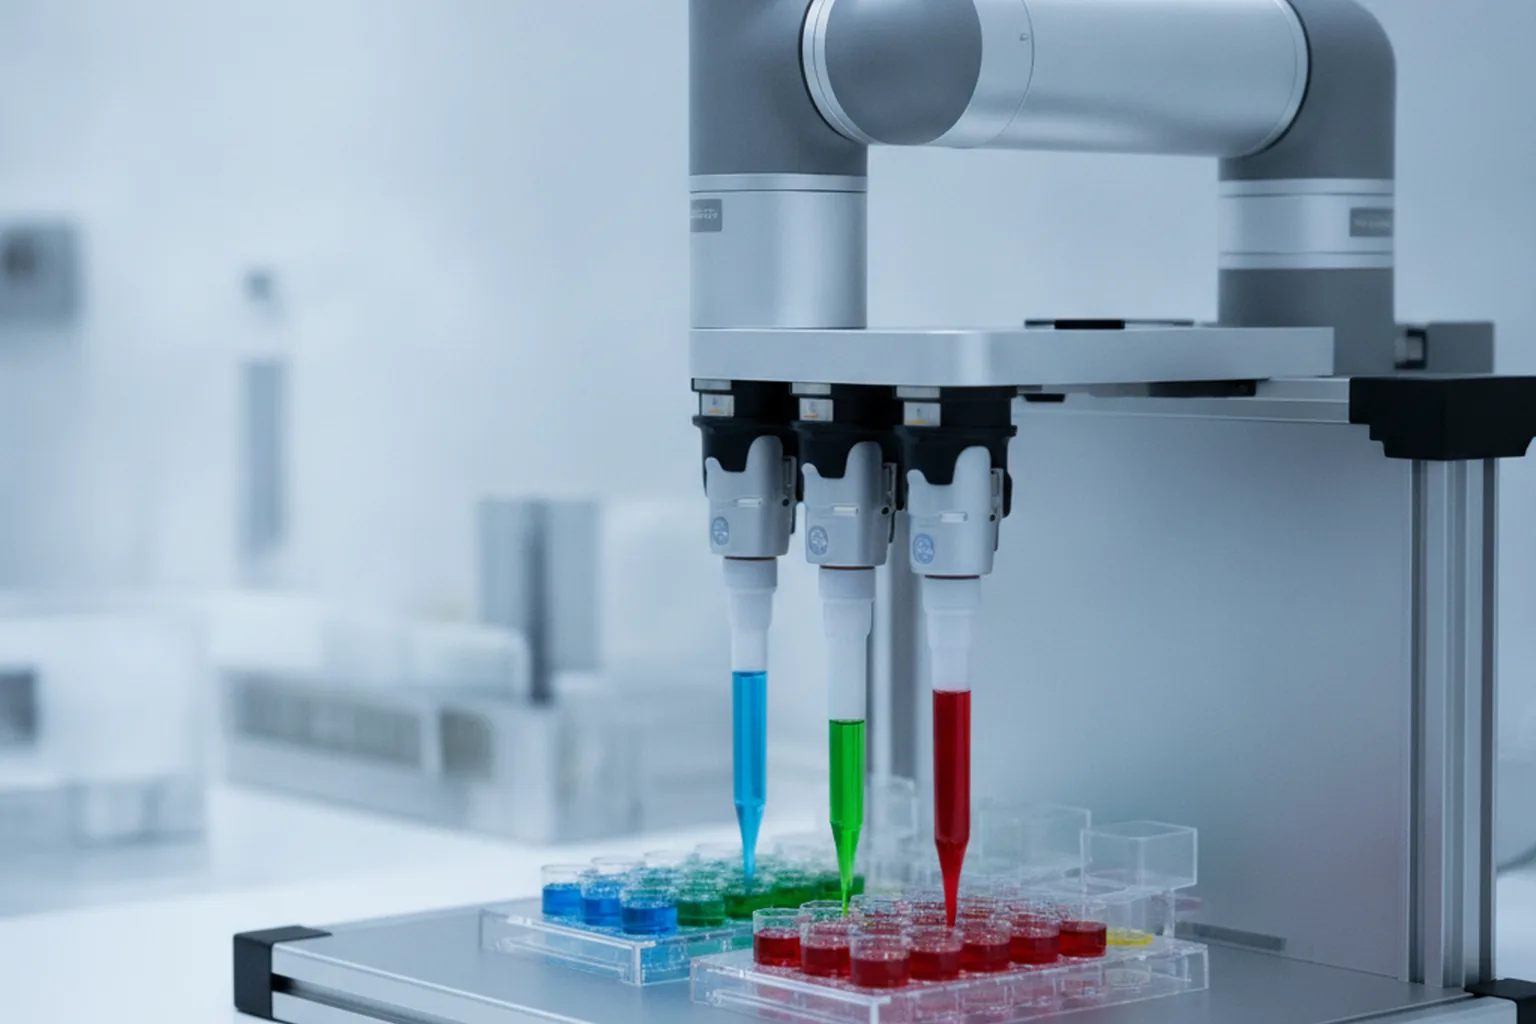
Laborautomatisierung und Geräteintegration
Software für Laborautomatisierung plant und steuert Pipettierroboter, Plattenreader, Inkubatoren und Roboterarme und überträgt deren Daten ohne manuellen Export in das LIMS oder die Datenplattform. Standards wie SiLA 2 für die Gerätekommunikation und das Allotrope Simple Model für Analysedaten verringern den Aufwand für eigene Treiber, doch die meisten Labore betreiben weiterhin einen Gerätemix, der individuelle Konnektoren erfordert.
KI-Werkzeuge für die Forschung
KI-Werkzeuge für die Forschung setzen maschinelles Lernen für Target-Identifikation, Protein- und Antikörperdesign, Vorhersage molekularer Eigenschaften und Hit-Triage ein. Die Software-Herausforderung liegt weniger im Modell als in der Schleife darum: kuratierte Trainingsdaten, Experiment-Tracking, Modellversionierung und ein schneller Weg von der Vorhersage zum nächsten Laborexperiment – das Muster „Lab-in-the-Loop“. Unser Leitfaden zur Machine-Learning-Softwareentwicklung behandelt die MLOps-Seite ausführlicher.
Bioprozess, Bioproduktion und Diagnostik
Je näher Programme an Produktion und Patienten rücken, desto mehr wandelt sich Software von Forschungswerkzeugen zu regulierten Systemen: Bioprozessanalytik, elektronische Chargenprotokolle, Qualitätsmanagement und diagnostische Befundung. Diese Systeme brauchen von Anfang an Validierung, Audit-Trails und kontrollierte Releases, und Diagnostikprodukte können als Medizinprodukte reguliert sein – siehe unseren Leitfaden zur Medizinproduktesoftware.
Welche Funktionen braucht Biotech-Software?
Jede ernsthafte Biotech-Anwendung braucht ein gemeinsames wissenschaftliches Datenmodell, lückenlose Rückverfolgbarkeit, Geräteanbindung, skalierbare Rechenleistung, fein abgestufte Zugriffsrechte und prüfungsfeste Aufzeichnungen. Diese Funktionen entscheiden, ob das System mit der Wissenschaft wächst oder in zwei Jahren ersetzt werden muss.
- Ein flexibles Entitätenregister. Proben, Konstrukte, Zelllinien, Reagenzien und Chargen als verknüpfte Entitäten mit Herkunft, sodass sich jedes Ergebnis bis zu seiner biologischen Quelle zurückverfolgen lässt.
- Konfigurierbare Workflows. Assays und Protokolle als Konfiguration statt als Code, damit Wissenschaftler eine neue Methode ohne Release-Zyklus hinzufügen können.
- Geräte- und Dateiübernahme. Automatische Erfassung von Geräteausgaben, Umwandlung in strukturierte Daten und Speicherung der Rohdateien mit Prüfsummen.
- Reproduzierbare Pipelines. Versionierte Workflows, containerisierte Werkzeuge und protokollierte Parameter, damit eine Analyse auch Jahre später mit demselben Ergebnis wiederholt werden kann.
- Audit-Trails und elektronische Signaturen. Zeitgestempelte, zuordenbare Aufzeichnungen, wer was warum geändert hat, mit elektronischen Signaturen, wo 21 CFR Part 11 gilt.
- Rollenbasierter Zugriff und Datentrennung. Fein abgestufte Berechtigungen für interne Teams, Partner und CROs sowie Pseudonymisierung für Daten aus Patientenproben.
- APIs und Analysezugang. Dokumentierte APIs und direkter Zugriff aus Notebooks oder BI, damit Data Scientists mit kontrollierten Daten arbeiten statt mit privaten Kopien.
Plattform kaufen oder ein Biotech-Softwareentwicklungsunternehmen beauftragen?
Kaufen Sie eine kommerzielle Plattform, wenn Ihre Abläufe Standard sind und Geschwindigkeit am wichtigsten ist; beauftragen Sie ein Biotech-Softwareentwicklungsunternehmen, wenn Ihre Wissenschaft, Ihr Datenmodell oder Ihre Integrationen ein Wettbewerbsvorteil sind, den ein konfigurierbares Produkt nicht abbilden kann. Viele Organisationen tun beides: den Kern kaufen und die differenzierende Schicht darum herum bauen.
| Faktor | Kaufen (kommerzielles LIMS/ELN oder F&E-Plattform) | Bauen (individuelle Entwicklung) |
|---|---|---|
| Zeit bis zum ersten Nutzen | Wochen bis wenige Monate | Drei bis neun Monate bis zum ersten Release |
| Passung zur eigenen Wissenschaft | Begrenzt durch das Datenmodell des Anbieters | Rund um Ihre Entitäten und Abläufe entworfen |
| Kostenprofil | Wiederkehrende Lizenzen, die mit Nutzern und Daten wachsen | Höhere Anfangsinvestition, niedrigere Grenzkosten |
| Integrationstiefe | Abhängig von den APIs des Anbieters | Volle Kontrolle über Integrationen und Datenflüsse |
| Validierung | Herstellerdokumentation hilft | Das Validierungspaket gehört Ihnen |
| Eigentum an IP und Daten | Daten im System und Format des Anbieters | Code, Datenmodell und Daten gehören Ihnen |
Eine nützliche Faustregel: Wenn mehr als ein Drittel der Anforderungen Workarounds oder Herstelleranpassungen braucht, ist eine hybride Architektur – kommerzieller Kern plus individuelle Datenplattform und Integrationen – über fünf Jahre meist günstiger. Unser Artikel Individualsoftware vs. Standardsoftware zeigt die vollständige Rechnung.
Welche Compliance-Regeln gelten 2026 für Biotech-Software?
Biotech-Software muss von Anfang an die Erwartungen an Datenintegrität erfüllen und formale regulatorische Anforderungen, sobald ihre Daten regulierte Entscheidungen stützen: 21 CFR Part 11 für elektronische Aufzeichnungen und Signaturen, GLP und GMP für nichtklinische Studien und Herstellung, HIPAA und DSGVO für Daten aus Patientenproben sowie Medizinprodukte- oder Diagnostikregeln, wo Software klinische Aussagen trifft.
- 21 CFR Part 11 und EU-GMP Anhang 11. Part 11 selbst hat sich 2026 nicht geändert, wohl aber sein Umfeld. Audit-Trails, Zugriffskontrolle, elektronische Signaturen und Aufbewahrung bleiben der Kern.
- Computer Software Assurance (CSA). Die geänderte Quality Management System Regulation der FDA trat am 2. Februar 2026 in Kraft und übernimmt ISO 13485:2016 per Verweis; am 3. Februar 2026 folgte eine aktualisierte finale CSA-Leitlinie. Sie erfasst ausdrücklich Cloud-Dienste sowie KI/ML-Werkzeuge für Produktions- oder Qualitätszwecke und bevorzugt risikobasiertes Testen gegenüber erschöpfender skriptbasierter Validierung.
- Datenintegrität (ALCOA+). Aufzeichnungen müssen zuordenbar, lesbar, zeitnah, original und korrekt sowie vollständig, konsistent, dauerhaft und verfügbar sein – eine Designanforderung, keine Dokumentationsübung.
- HIPAA, DSGVO und genetischer Datenschutz. Genomdaten von Patienten oder Spendern sind Gesundheitsdaten. Rechnen Sie mit Pseudonymisierung, Einwilligungsverwaltung, Auftragsverarbeitungsverträgen und bei EU-Daten mit den DSGVO-Regeln für besondere Kategorien personenbezogener Daten.
- KI in der Arzneimittelentwicklung. Der Leitlinienentwurf der FDA vom Januar 2025 schlägt einen siebenstufigen, risikobasierten Glaubwürdigkeitsrahmen für KI-Modelle in regulatorischen Entscheidungen vor und war im Herbst 2026 noch ein Entwurf. Am 14. Januar 2026 veröffentlichten FDA und EMA zehn gemeinsame Leitprinzipien guter KI-Praxis in der Arzneimittelentwicklung.
- Diagnostik. Software, die diagnostische Ergebnisse erzeugt, kann in den USA unter CLIA, in der EU unter die IVDR oder unter Regeln für Medizinproduktesoftware wie IEC 62304 fallen.
Eine ausführlichere Checkliste für Patientendaten finden Sie in unserer HIPAA-Checkliste für die Softwareentwicklung.
Welcher Technologie-Stack wird für Biotech-Software genutzt?
Ein moderner Biotech-Software-Stack kombiniert eine Webanwendungsschicht für Wissenschaftler, eine Workflow-Engine für Pipelines, elastische Cloud- oder HPC-Rechenleistung, eine kontrollierte Datenschicht für große wissenschaftliche Dateien und Standardschnittstellen zu Geräten und klinischen Systemen. Die Tabelle zeigt typische Entscheidungen 2026.
| Schicht | Gängige Technologien |
|---|---|
| Anwendung und UI | React- oder Angular-Frontends; Python- (Django, FastAPI), Java- oder .NET-Backends |
| Workflow-Engines | Nextflow, Snakemake, WDL mit Cromwell, Airflow oder Prefect für Datenjobs |
| Wissenschaftliches Rechnen | Python (NumPy, pandas, scikit-learn), R und Bioconductor, containerisierte Werkzeuge mit Docker |
| Rechenleistung | Batch- und Genomikdienste von AWS, Google Cloud oder Azure, Kubernetes, HPC mit Slurm, GPUs für KI |
| Datenspeicherung | PostgreSQL für Metadaten; Objektspeicher mit Parquet- oder Delta-Tabellen für große Datensätze; Spezialformate wie BAM, CRAM und Zarr |
| Geräte- und Datenstandards | SiLA 2, Allotrope Simple Model, Hersteller-SDKs |
| Klinische Interoperabilität | HL7 v2 und FHIR für Diagnostik- und Patientensysteme |
| KI und MLOps | PyTorch, Modell-Registries, Experiment-Tracking, Vektorsuche für Literatur und Assay-Daten |
Der Stack zählt weniger als die Architekturentscheidungen dahinter: Metadaten von Massendateien trennen, Pipelines deklarativ und versioniert halten und jeden Datensatz über eine ID adressierbar machen. Teams, die große Workloads in die Cloud verlagern, sollten auch unseren Leitfaden zur Cloud-Softwareentwicklung lesen.
Wie wird Biotech-Software Schritt für Schritt entwickelt?
Biotech-Software entsteht am besten in kurzen, wissenschaftsgetriebenen Iterationen: mit einer Analyse direkt im Labor beginnen, die Daten vor den Oberflächen modellieren, früh einen schmalen funktionierenden Ausschnitt liefern und Validierung ergänzen, sobald sich das System dem regulierten Einsatz nähert. Ein typischer Prozess hat sieben Schritte.
- Laboranalyse. Wissenschaftler am Labortisch begleiten, Proben, Geräte, Dateien und Übergaben abbilden und erkennen, wo Daten doppelt erfasst werden oder verloren gehen.
- Datenmodell und Architektur. Entitäten, Herkunft und Metadatenstandards festlegen; entscheiden, was gekauft, was gebaut wird und wo Daten liegen.
- Regulatorische Einordnung. Jede Komponente nach Risiko einstufen: nur Forschung, GxP-relevant oder diagnostisch. Das bestimmt den Validierungsaufwand.
- Schmaler vertikaler Ausschnitt. Einen Ablauf vollständig liefern – zum Beispiel vom Probeneingang bis zu den Sequenzierungsergebnissen – innerhalb von acht bis zwölf Wochen.
- Integration und Automatisierung. Geräte, Pipelines, ELN/LIMS und Analytik verbinden; manuelle Exporte abschaffen.
- Verifizierung und Validierung. Automatisierte Tests für alle Komponenten sowie risikobasierte CSA- oder CSV-Dokumentation für die regulierten.
- Rollout, Schulung und Support. Historische Daten migrieren, Wissenschaftler schulen, Nutzung beobachten und ein Backlog pflegen, das vom Labor gesteuert wird, nicht vom Anbieter.
Dieselbe Logik liegt unserem allgemeinen Leitfaden zur individuellen Healthcare-Softwareentwicklung zugrunde, hier angepasst an Forschungslabore.
Was kostet Biotech-Softwareentwicklung 2026?
2026 kostet individuelle Biotech-Softwareentwicklung typischerweise $40.000–$120.000 für eine fokussierte Pipeline oder ein Datenwerkzeug, $80.000–$200.000 für ein individuelles LIMS- oder ELN-Modul, $200.000–$600.000 für eine Multi-Omics-Forschungsdatenplattform und $300.000 bis über 1 Million $ für ein validiertes Unternehmenssystem. Umfang, Integrationen und Validierung bestimmen die Spanne.
| Projekttyp | Typische Kosten (2026) | Typische Dauer |
|---|---|---|
| Neubau einer Bioinformatik-Pipeline oder Datenwerkzeug | $40.000–$120.000 | 2–4 Monate |
| Individuelles LIMS- oder ELN-Modul oder Integrationsschicht | $80.000–$200.000 | 4–7 Monate |
| Orchestrierung der Laborautomatisierung | $100.000–$300.000 | 4–9 Monate |
| Multi-Omics-Forschungsdatenplattform | $200.000–$600.000 | 6–12 Monate |
| GxP-validiertes Unternehmenssystem | $300.000–$1.000.000+ | 9–18 Monate |
Diese Spannen beruhen auf unserer Projekterfahrung und decken sich mit veröffentlichten Anbieterleitfäden für 2026, die etwa $50.000 für fokussierte Datenwerkzeuge bis $500.000+ für Unternehmensplattformen nennen. Nicht enthalten sind kommerzielle Lizenzen, Cloud-Rechenleistung und Speicher, die bei sequenzierungsintensiven Organisationen die Entwicklungskosten erreichen können.
Was die Kosten erhöht oder senkt
- Anzahl der zu integrierenden Geräte und Systeme. Jedes nicht standardisierte Gerät und jedes Altsystem bringt Aufwand für Konnektor, Tests und Wartung.
- Validierungsumfang. GxP-relevante Komponenten verursachen 20–40 % Mehraufwand für Dokumentation, Tests und Änderungskontrolle.
- Datenvolumen und Rechenleistung. Speicher im Petabyte-Bereich und GPU-Workloads erfordern mehr Architektur- und Kostenoptimierungsarbeit.
- Datenmigration. Die Übernahme jahrelanger Tabellen und Altdaten aus einem früheren LIMS wird oft unterschätzt.
- Teammodell und Standort. Gemischte Nearshore-Teams kosten bei gleicher Seniorität weniger als reine US-Teams; Richtwerte finden Sie unter Kosten der Healthcare-Softwareentwicklung.
Welches Zusammenarbeitsmodell eignet sich für Biotech-Softwareentwicklung?
Ein dediziertes Team ist meist das beste Zusammenarbeitsmodell für Biotech-Software, weil sich Forschungsanforderungen ständig ändern; Festpreisprojekte funktionieren nur für klar umrissene Teile wie die Migration einer einzelnen Pipeline oder einen Gerätekonnektor. Staff Augmentation passt zu Organisationen, die bereits eine starke interne technische Leitung haben.
| Modell | Funktionsweise | Geeignet für |
|---|---|---|
| Dediziertes Team | Ein stabiles, funktionsübergreifendes Team (Tech Lead, Entwickler, Data Engineer, QA) arbeitet langfristig an Ihrem Backlog | Forschungsdatenplattformen, sich entwickelnde LIMS/ELN, KI-Werkzeuge |
| Festpreisprojekt | Vereinbarter Umfang, Zeitplan und Preis | Pipeline-Migrationen, Konnektoren, validierte Module mit stabilen Anforderungen |
| Staff Augmentation | Einzelne Entwickler verstärken Ihr internes Team | Organisationen mit eigener Leitung für Engineering oder Bioinformatik |
| Discovery-Sprint | Zwei bis sechs Wochen Ablaufanalyse, Architektur und Schätzung | Jedes Projekt, bevor ein großes Budget gebunden wird |
Unabhängig vom Modell sollten Sie auf einen wissenschaftsnahen Product Owner auf Ihrer Seite und ein gemeinsames Backlog bestehen, das das Labor einsehen kann. Unser Vergleich Time & Materials vs. Festpreis vs. dediziertes Team erläutert die Abwägungen im Detail.
Wie wählen Sie ein Biotech-Softwareentwicklungsunternehmen aus?
Wählen Sie ein Biotech-Softwareentwicklungsunternehmen, das bereits wissenschaftliche Datensysteme ausgeliefert hat, mit Ihren Wissenschaftlern in deren Sprache sprechen kann, von Anfang an für Validierung und FAIR-Daten plant und Code, Datenmodell und Dokumentation vollständig in Ihr Eigentum übergibt.
- Wissenschaftliche Fachkompetenz. Fragen Sie nach Beispielen zu Sequenzierung, Assays, Registern oder Laborautomatisierung und beziehen Sie einen Wissenschaftler in das Gespräch ein.
- Tiefe im Data Engineering. Achten Sie auf Erfahrung mit Workflow-Engines, großen Dateien, Metadatenmodellen und Cloud-Kostenkontrolle, nicht nur mit Web-Apps.
- Regulierte Lieferung. Nachweise für Arbeit mit 21 CFR Part 11, CSA/CSV, ISO 13485 oder HIPAA, mit Beispielen von Validierungsunterlagen.
- Erfahrung mit Integrationen. Geräte, kommerzielle LIMS/ELN-Plattformen und klinische Systeme, die bereits angebunden wurden.
- Sicherheitsniveau. Praktiken nach ISO 27001 oder SOC 2, sicherer SDLC und ein klarer Umgang mit Daten aus Patientenproben.
- Eigentum und Ausstieg. Vertragliche IP-Übertragung, dokumentierte Architektur und kein proprietärer Lock-in.
- Liefermodell. Ein stabiles Team mit Tech Lead, Unterstützung für den Product Owner und Zeitzonenüberschneidung mit Ihren Wissenschaftlern.
Unser allgemeines Raster zur Auswahl eines Softwareentwicklungsunternehmens gilt ebenfalls; die Punkte oben sind die biotech-spezifische Ebene darüber.
Welche Trends prägen Biotech-Software 2026?
Die prägenden Trends bei Biotech-Software 2026 sind KI, die von Piloten in die Forschungsschleife wandert, stark wachsende Ausgaben für Bioinformatik und LIMS, cloud-native Omics-Infrastruktur, FAIR-Daten als Voraussetzung für KI und strengere regulatorische Erwartungen an KI- und Cloud-Werkzeuge.
- Marktwachstum. MarketsandMarkets schätzt den Bioinformatikmarkt 2026 auf 18,63 Mrd. $ mit Wachstum auf 34,41 Mrd. $ bis 2031 bei 13,1 % CAGR, den LIMS-Markt 2026 auf 3,26 Mrd. $ mit 5,84 Mrd. $ bis 2031 bei 12,4 % CAGR.
- Lab-in-the-Loop-KI. Modelle für Proteindesign und Eigenschaftsvorhersage werden zunehmend direkt mit automatisierten Experimenten verbunden, sodass Software die Schleife aus Vorhersage, Experiment und Nachtraining schließen muss.
- Cloud-native Omics. Verwaltete Genomikdienste und Objektspeicherformate ersetzen lokale Dateiserver für Sequenzierungsdaten.
- FAIR-Daten und Ontologien. Organisationen investieren in Metadatenstandards und kontrollierte Vokabulare, weil KI-Modelle an inkonsistenten Daten scheitern.
- Regulatorischer Fokus auf KI und Cloud. Die CSA-Leitlinie nennt Cloud- und KI/ML-Werkzeuge jetzt ausdrücklich, und die Prinzipien von FDA und EMA setzen Erwartungen an die Modell-Governance.
- Generative KI für Wissenschaftler. Assistenten, die Literatur, Protokolle und interne Daten durchsuchen, ziehen in ELNs ein; unser Leitfaden zur Entwicklung generativer KI-Software zeigt, wie man sie sicher baut.
Häufig gestellte Fragen
Was macht ein Biotech-Softwareentwicklungsunternehmen?
Ein Biotech-Softwareentwicklungsunternehmen entwirft und baut individuelle Software für Biotech-Firmen und Forschungslabore, etwa LIMS, elektronische Laborbücher, Bioinformatik- und Sequenzierungs-Pipelines, Multi-Omics-Datenplattformen, Software für Laborautomatisierung und KI-Werkzeuge für die Forschung. Es integriert außerdem Geräte und bestehende Plattformen, unterstützt die Validierung für den regulierten Einsatz und betreut die Systeme nach dem Start.
Was kostet Biotech-Softwareentwicklung?
2026 kostet eine fokussierte Bioinformatik-Pipeline oder ein Datenwerkzeug typischerweise $40.000 bis $120.000, ein individuelles LIMS- oder ELN-Modul $80.000 bis $200.000, eine Multi-Omics-Forschungsdatenplattform $200.000 bis $600.000 und ein GxP-validiertes Unternehmenssystem $300.000 bis über 1 Million $. Integrationen, Validierungsumfang und Datenvolumen bestimmen den Endbetrag.
Was ist der Unterschied zwischen Biotech- und Pharma-Software?
Biotech-Software konzentriert sich auf Forschung und Entdeckung: Experimente, biologische Daten, Pipelines und sich schnell ändernde Methoden. Pharma-Software konzentriert sich auf den regulierten Arzneimittellebenszyklus: klinische Studien, GMP-Herstellung, Qualität und Pharmakovigilanz. Biotech-Systeme priorisieren Flexibilität und Datenskalierung, Pharma-Systeme Validierung und kontrollierte Änderungen; beide wachsen zusammen, wenn Forschungsdaten regulatorische Entscheidungen stützen.
Sollte ein Biotech-Unternehmen ein LIMS bauen oder kaufen?
Kaufen Sie ein kommerzielles LIMS, wenn Ihre Abläufe Standard sind und Sie schnell starten müssen. Bauen Sie selbst oder um einen kommerziellen Kern herum, wenn Ihre Entitäten, Assays oder Integrationen einzigartig sind und starke Anpassungen erfordern würden. Brauchen mehr als etwa ein Drittel der Anforderungen Workarounds, ist eine Kombination aus kommerziellem Kern und individueller Datenplattform über fünf Jahre meist günstiger.
Braucht Biotech-Software eine Compliance nach 21 CFR Part 11?
Nur wenn ihre elektronischen Aufzeichnungen FDA-regulierte Tätigkeiten stützen, etwa GLP-Studien, GMP-Herstellung, klinische Arbeit oder regulatorische Einreichungen. Reine Forschungswerkzeuge brauchen keine formale Part-11-Validierung, sollten aber trotzdem mit Audit-Trails, Zugriffskontrolle und Datenintegritätspraktiken gebaut werden, damit sie später ohne Neuentwicklung validiert werden können.
Wie lange dauert die Entwicklung von Biotech-Software?
Eine fokussierte Pipeline oder ein Datenwerkzeug dauert meist zwei bis vier Monate, ein individuelles LIMS- oder ELN-Modul vier bis sieben Monate, eine Forschungsdatenplattform sechs bis zwölf Monate und ein validiertes Unternehmenssystem neun bis achtzehn Monate. Ein schmaler funktionierender Ausschnitt eines Ablaufs lässt sich meist innerhalb von acht bis zwölf Wochen liefern.
Welche Programmiersprachen werden in der Bioinformatik-Softwareentwicklung genutzt?
Python und R dominieren Analyse und wissenschaftliches Rechnen, mit Bioconductor für Genomik-Statistik. Pipelines werden in Workflow-Sprachen wie Nextflow, Snakemake oder WDL geschrieben, leistungskritische Werkzeuge oft in C++, Rust oder Java, und Webanwendungen für Wissenschaftler nutzen typischerweise TypeScript mit React oder Angular auf Python-, Java- oder .NET-Backends.
Veröffentlicht am 26. Oktober 2026. Quellen: MarketsandMarkets, Bioinformatics Market 2026–2031; MarketsandMarkets, LIMS Market 2026–2031; eCFR, 21 CFR Part 11; FDA, Computer Software Assurance for Production and Quality Management System Software (Februar 2026); FDA, Leitlinienentwurf zu KI für regulatorische Entscheidungen bei Arzneimitteln und biologischen Produkten (Januar 2025); FDA–EMA, Guiding Principles of Good AI Practice in Drug Development (Januar 2026); veröffentlichte Anbieterleitfäden zu Kosten 2026. Kosten sind Marktspannen, keine Angebote. Dieser Artikel ist eine allgemeine Information und keine regulatorische Beratung.