
Une société de développement de logiciels biotech conçoit, développe et maintient les logiciels sur lesquels reposent les entreprises de biotechnologie orientées recherche : des systèmes qui suivent les échantillons, enregistrent les expériences, traitent les données de séquençage, pilotent les robots de laboratoire et transforment des téraoctets de données biologiques en décisions. En 2026, ce travail se situe à la croisée de trois disciplines – génie logiciel, ingénierie des données et science de laboratoire –, et les meilleurs partenaires maîtrisent les trois.
Les équipes biotech font généralement appel à un développeur externe lorsque les plateformes standard ne correspondent plus à leur science : un nouveau test que le LIMS ne sait pas modéliser, un pipeline de séquençage qui ne passe plus à l’échelle ou un modèle d’IA qui a besoin de données d’entraînement propres et reliées. Comme les logiciels biotech touchent souvent à des échantillons issus de patients, à une production réglementée ou à des allégations diagnostiques, ils doivent aussi atteindre le même niveau d’intégrité des données que les systèmes cliniques. C’est pourquoi nous les traitons dans le cadre de nos services de développement logiciel HealthTech et sciences de la vie, et non comme du simple développement web.
Ce guide explique ce que recouvre le développement de logiciels biotech, en quoi il diffère du logiciel pharmaceutique, les principaux types de logiciels biotech développés aujourd’hui, les fonctionnalités et règles de conformité qui comptent, la stack technologique, un processus de développement étape par étape, des coûts réalistes en 2026 et la manière de choisir une société de développement de logiciels biotech. Si votre activité est plus proche de la fabrication de médicaments et des essais cliniques, commencez plutôt par notre guide du développement de logiciels pharmaceutiques.
Que fait une société de développement de logiciels biotech ?
Une société de développement de logiciels biotech crée des logiciels sur mesure au service de la recherche, du développement et de la production biologiques : saisie des données de laboratoire, gestion des échantillons et des stocks, traitement des données scientifiques, intégration des instruments, analytique et IA. Contrairement à un éditeur qui vend une seule plateforme, elle conçoit des systèmes autour de la science, des données et des processus propres à une organisation.
Dans la pratique, les « services de développement de logiciels biotech » couvrent des missions très variées, de la refonte d’un pipeline de bioinformatique en trois mois à une plateforme de données de recherche sur plusieurs années. Les acheteurs qui cherchent une société de développement de logiciels de biotechnologie rencontrent généralement quatre types de prestataires :
| Type de prestataire | Ce qu’il livre | Idéal pour | Limite |
|---|---|---|---|
| Éditeurs de plateformes (produits LIMS/ELN) | Logiciel sous licence configuré pour votre laboratoire | Processus standard, démarrage rapide, support éditeur | Modèles de données rigides, coût par utilisateur, feuille de route hors de votre contrôle |
| Sociétés de développement de logiciels biotech sur mesure | Applications, intégrations et plateformes de données sur mesure | Science unique, processus propriétaires, environnements riches en intégrations | Exige une responsabilité produit claire de votre côté |
| Cabinets de conseil en bioinformatique | Pipelines d’analyse, statistiques, interprétation scientifique | Analyses ponctuelles, développement de méthodes | Souvent plus faibles sur l’ingénierie de production et le support à long terme |
| Intégrateurs et sociétés de validation | Déploiement de plateformes, validation CSV/CSA, exploitation IT | Déploiements réglementés (GxP) de produits existants | Peu de développement produit sur mesure |
La plupart des organisations biotech matures les combinent : un ELN ou un LIMS commercial pour le travail standard, un partenaire de développement sur mesure pour la plateforme de données et les intégrations qui l’entourent, et des spécialistes de la validation pour les parties réglementées.
En quoi un logiciel biotech diffère-t-il d’un logiciel pharmaceutique ?
Le logiciel biotech est conçu principalement pour la découverte et la recherche – expériences, données biologiques et méthodes en évolution rapide –, tandis que le logiciel pharmaceutique sert surtout les étapes réglementées plus tardives du cycle de vie du médicament : essais cliniques, fabrication BPF, qualité et pharmacovigilance. Les deux se recoupent, mais leurs priorités diffèrent.
| Dimension | Biotech (orientée recherche) | Pharmaceutique (orientée cycle de vie) |
|---|---|---|
| Utilisateurs principaux | Chercheurs de paillasse, bioinformaticiens, data scientists, ingénieurs en automatisation | Opérations cliniques, AQ/CQ, production, affaires réglementaires |
| Systèmes typiques | ELN, LIMS de recherche, pipelines NGS, plateformes multi-omiques, modèles d’IA | EDC, CTMS, QMS, MES, pharmacovigilance |
| Données | Très volumineuses et hétérogènes : séquences, images, lectures de plaques, spectres | Données cliniques, de lots et de qualité structurées |
| Rythme du changement | Élevé – tests et méthodes changent chaque mois | Faible – les changements passent par un contrôle formel |
| Réglementation | Intégrité des données et principes FAIR ; BPL/BPF dès que le travail entre dans des études réglementées ou en production | GxP, 21 CFR Part 11 et validation des systèmes informatisés dès le premier jour |
| Principal défi technique | Faire passer le calcul à l’échelle et modéliser une science en évolution | Validation, pistes d’audit et mises en production contrôlées |
Conséquence pratique : une société de développement de logiciels biotech doit savoir livrer vite en recherche tout en préservant un chemin propre vers la validation, car un outil de découverte peut devenir un système réglementé dès que ses données soutiennent un dossier IND, une allégation diagnostique ou une libération de lot.
Quelles organisations ont besoin d’un logiciel biotech sur mesure ?
Un logiciel biotech sur mesure est rentable pour les organisations dont la science, les volumes de données ou les partenariats dépassent les outils standard : start-up biotech financées par capital-risque, biotechs de plateforme, CRO et CDMO, plateformes académiques, laboratoires de diagnostic et entreprises de biotechnologie industrielle ou agricole. Chaque groupe a besoin d’un premier système différent.
- Start-up biotech en phase précoce. Commencent généralement avec un ELN commercial, puis ajoutent un registre léger, un data lake et un ou deux pipelines automatisés dès que les volumes de séquençage ou de criblage augmentent.
- Biotechs de plateforme. Les entreprises dont la plateforme est le produit – découverte d’anticorps, thérapie cellulaire, biologie de synthèse – investissent tôt dans une plateforme de données sur mesure, car leur modèle de données est leur avantage concurrentiel.
- CRO et CDMO. Ont besoin d’une séparation des données entre clients, de portails promoteurs, d’un suivi des études et de systèmes validés qui résistent aux audits de chaque client.
- Plateformes académiques et institutionnelles. Ont besoin de réception des échantillons, de facturation, de réservation d’instruments et de livraison des résultats pour des centaines d’utilisateurs internes.
- Laboratoires de diagnostic et de génomique clinique. Ont besoin de prescription des tests, d’enregistrement des échantillons, de flux d’interprétation et d’intégration au dossier patient selon CLIA ou l’IVDR.
- Biotech industrielle, alimentaire et agricole. A davantage besoin de banques de souches, de données de fermentation et de bioprocédés et d’analyses de montée en échelle que de fonctions cliniques.
Quels types de logiciels biotech développe-t-on en 2026 ?
Les types de logiciels biotech sur mesure les plus courants en 2026 sont les systèmes de gestion de l’information de laboratoire (LIMS), les cahiers de laboratoire électroniques, les pipelines de bioinformatique et de séquençage, les plateformes de données multi-omiques, l’automatisation de laboratoire et l’intégration d’instruments, les outils d’IA pour la recherche, les logiciels de bioprocédés et de bioproduction ainsi que les applications de diagnostic.
| Type de logiciel | Ce qu’il fait | Intégrations typiques |
|---|---|---|
| LIMS | Enregistrement des échantillons, chaîne de traçabilité, tests, résultats, stocks | Instruments, ELN, ERP, congélateurs et systèmes de codes-barres |
| Cahier de laboratoire électronique (ELN) | Protocoles, observations, calculs, contexte expérimental | LIMS, registres, stockage de fichiers, outils d’analyse |
| Pipelines de bioinformatique et NGS | Alignement, appel de variants, analyse d’expression, contrôle qualité | Séquenceurs, calcul HPC ou cloud, bases de référence |
| Plateforme de données multi-omiques | Stockage unifié, métadonnées, recherche et analytique sur tous les types de données | Pipelines, ELN/LIMS, notebooks, outils BI et ML |
| Automatisation et planification de laboratoire | Orchestration des robots, plans de plaques, planification des runs, pilotage des appareils | Robots de pipetage, lecteurs, incubateurs via SiLA 2 ou API constructeurs |
| Outils d’IA pour la recherche | Identification de cibles, conception de protéines et d’anticorps, tri des hits | Données de tests, bases de structures, calcul GPU |
| Bioprocédés et bioproduction | Dossiers de lot, analyse des procédés, données de montée en échelle, liens MES | Bioréacteurs, historians, QMS, ERP |
| Diagnostic et génomique clinique | Prescription des tests, rendu des résultats, portails patients | Dossier patient via HL7/FHIR, payeurs, instruments de laboratoire |
LIMS et cahiers de laboratoire électroniques
Le LIMS et l’ELN sont le système de référence de la plupart des laboratoires biotech : le LIMS gère les opérations structurées comme les échantillons, les tests et les stocks, tandis que l’ELN capture le contexte scientifique – protocoles, observations et raisonnements. Le développement sur mesure se justifie généralement lorsque les entités d’un laboratoire (constructions, lignées cellulaires, anticorps, souches) ou ses processus n’entrent pas dans un modèle de données commercial, ou lorsque les deux systèmes doivent partager un registre unique au lieu d’une double saisie manuelle.
Pipelines de bioinformatique et de séquençage
Le développement de logiciels de bioinformatique transforme les sorties brutes des instruments en résultats exploitables : démultiplexage, alignement, appel de variants, analyses single-cell et spatiales, et contrôle qualité. Le travail d’ingénierie porte sur la reproductibilité et la montée en charge – workflows versionnés, outils conteneurisés, relances automatiques et exécution cloud ou HPC maîtrisée en coûts – plutôt que sur l’écriture de nouveaux algorithmes.
Plateformes multi-omiques et de données de recherche
Une plateforme de données de recherche relie les données de génomique, de protéomique, d’imagerie et de tests aux métadonnées d’échantillons et d’expériences qui leur donnent du sens. C’est le socle de toute ambition en IA : des modèles entraînés sur des données déconnectées et mal annotées ne se généralisent pas. Les bonnes plateformes suivent les principes FAIR – des données faciles à trouver, accessibles, interopérables et réutilisables.
Automatisation de laboratoire et intégration d’instruments
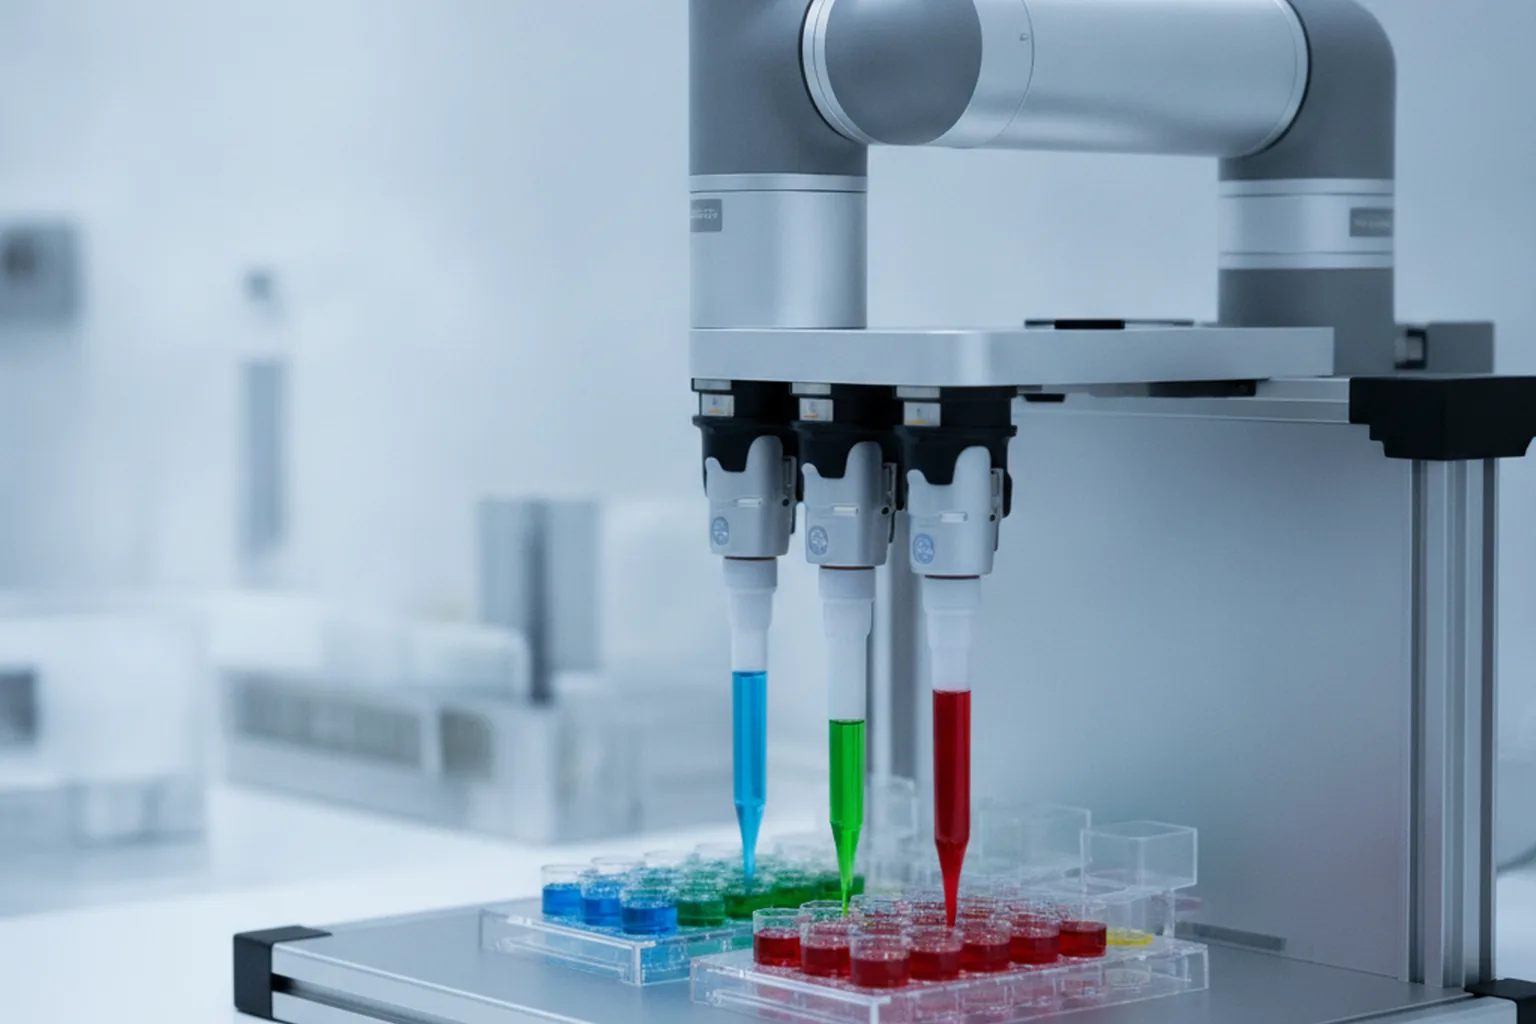
Le logiciel d’automatisation de laboratoire planifie et pilote les robots de pipetage, lecteurs de plaques, incubateurs et bras robotisés, et transfère leurs données vers le LIMS ou la plateforme de données sans export manuel. Des standards comme SiLA 2 pour la communication avec les appareils et l’Allotrope Simple Model pour les données analytiques réduisent le développement de pilotes spécifiques, mais la plupart des laboratoires exploitent encore un parc d’instruments hétérogène qui exige des connecteurs sur mesure.
Outils d’IA pour la recherche
Les outils d’IA pour la recherche appliquent l’apprentissage automatique à l’identification de cibles, à la conception de protéines et d’anticorps, à la prédiction de propriétés moléculaires et au tri des hits. Le défi logiciel tient moins au modèle qu’à la boucle qui l’entoure : données d’entraînement curées, suivi des expériences, versionnement des modèles et passage rapide de la prédiction à l’expérience suivante en laboratoire – le schéma « lab-in-the-loop ». Notre guide du développement de logiciels de machine learning détaille la partie MLOps.
Bioprocédés, bioproduction et diagnostic
À mesure que les programmes se rapprochent de la production et des patients, le logiciel passe d’outils de recherche à des systèmes réglementés : analyse des bioprocédés, dossiers de lot électroniques, gestion de la qualité et rendu de résultats diagnostiques. Ces systèmes exigent dès le départ validation, pistes d’audit et mises en production contrôlées, et les produits de diagnostic peuvent être réglementés comme des dispositifs médicaux – voir notre guide du développement de logiciels de dispositifs médicaux.
De quelles fonctionnalités un logiciel biotech a-t-il besoin ?
Toute application biotech sérieuse a besoin d’un modèle de données scientifique partagé, d’une traçabilité complète, d’une connexion aux instruments, d’un calcul évolutif, de droits d’accès fins et d’enregistrements prêts pour l’audit. Ces fonctionnalités déterminent si le système grandira avec la science ou devra être remplacé dans deux ans.
- Un registre d’entités flexible. Échantillons, constructions, lignées cellulaires, réactifs et lots modélisés comme des entités liées avec leur lignage, afin que chaque résultat puisse être relié à sa source biologique.
- Des workflows configurables. Tests et protocoles définis par configuration et non par code, pour que les scientifiques ajoutent une nouvelle méthode sans cycle de mise en production.
- L’ingestion des instruments et des fichiers. Capture automatique des sorties d’instruments, conversion en données structurées et stockage des fichiers bruts avec sommes de contrôle.
- Des pipelines reproductibles. Workflows versionnés, outils conteneurisés et paramètres enregistrés, pour qu’une analyse puisse être relancée des années plus tard avec le même résultat.
- Pistes d’audit et signatures électroniques. Enregistrements horodatés et attribuables indiquant qui a modifié quoi et pourquoi, avec signatures électroniques là où le 21 CFR Part 11 s’applique.
- Accès par rôles et cloisonnement des données. Permissions fines pour les équipes internes, les partenaires et les CRO, plus pseudonymisation des données issues de patients.
- API et accès analytique. API documentées et accès direct depuis les notebooks ou la BI, pour que les data scientists travaillent sur des données gouvernées plutôt que sur des copies privées.
Faut-il acheter une plateforme ou faire appel à une société de développement de logiciels biotech ?
Achetez une plateforme commerciale lorsque vos processus sont standard et que la rapidité prime ; faites appel à une société de développement de logiciels biotech lorsque votre science, votre modèle de données ou vos intégrations constituent un avantage concurrentiel qu’un produit configurable ne sait pas exprimer. Beaucoup d’organisations font les deux : acheter le cœur et développer la couche différenciante autour.
| Critère | Acheter (LIMS/ELN commercial ou plateforme R&D) | Développer (sur mesure) |
|---|---|---|
| Délai avant la première valeur | De quelques semaines à quelques mois | Trois à neuf mois pour une première version |
| Adéquation à votre science | Limitée par le modèle de données de l’éditeur | Conçu autour de vos entités et processus |
| Profil de coût | Licences récurrentes qui augmentent avec les utilisateurs et les données | Investissement initial plus élevé, coût marginal plus faible |
| Profondeur d’intégration | Dépend des API de l’éditeur | Contrôle total des intégrations et des flux de données |
| Validation | La documentation de l’éditeur aide | Le dossier de validation vous appartient |
| Propriété de la PI et des données | Données dans le système et le format de l’éditeur | Code, modèle de données et données vous appartiennent |
Règle empirique utile : si plus d’un tiers des exigences nécessitent des contournements ou une personnalisation par l’éditeur, une architecture hybride – cœur commercial plus plateforme de données et intégrations sur mesure – revient généralement moins cher sur cinq ans. Notre article logiciel sur mesure ou logiciel standard détaille le calcul complet.
Quelles règles de conformité s’appliquent aux logiciels biotech en 2026 ?
Un logiciel biotech doit répondre dès le départ aux attentes en matière d’intégrité des données, puis aux exigences réglementaires formelles dès que ses données soutiennent des décisions réglementées : 21 CFR Part 11 pour les enregistrements et signatures électroniques, BPL et BPF pour les études non cliniques et la fabrication, HIPAA et RGPD pour les données issues de patients, et règles applicables aux dispositifs ou au diagnostic lorsque le logiciel formule des allégations cliniques.
- 21 CFR Part 11 et annexe 11 des BPF de l’UE. La Part 11 elle-même n’a pas changé en 2026, mais son environnement si. Pistes d’audit, contrôle d’accès, signatures électroniques et conservation des enregistrements restent l’essentiel.
- Computer Software Assurance (CSA). Le règlement modifié de la FDA sur les systèmes de management de la qualité (QMSR) est entré en vigueur le 2 février 2026 en intégrant l’ISO 13485:2016 par référence, et une version finale mise à jour du guide CSA a suivi le 3 février 2026. Elle couvre explicitement les services cloud et les outils d’IA/ML utilisés à des fins de production ou de qualité, et privilégie des tests fondés sur le risque plutôt qu’une validation scriptée exhaustive.
- Intégrité des données (ALCOA+). Les enregistrements doivent être attribuables, lisibles, contemporains, originaux et exacts, mais aussi complets, cohérents, durables et disponibles – une exigence de conception, pas un exercice documentaire.
- HIPAA, RGPD et confidentialité génétique. Les données génomiques de patients ou de donneurs sont des données de santé. Prévoyez pseudonymisation, suivi des consentements, accords de traitement des données et, pour les données de l’UE, les règles du RGPD sur les catégories particulières de données.
- IA dans le développement de médicaments. Le projet de guide de la FDA de janvier 2025 propose un cadre de crédibilité en sept étapes, fondé sur le risque, pour les modèles d’IA utilisés dans les décisions réglementaires ; il était encore à l’état de projet à l’automne 2026. Le 14 janvier 2026, la FDA et l’EMA ont publié dix principes directeurs communs de bonnes pratiques d’IA dans le développement des médicaments.
- Diagnostic. Un logiciel qui produit des résultats diagnostiques peut relever de CLIA aux États-Unis, du règlement européen IVDR ou des règles applicables aux logiciels de dispositifs médicaux comme l’IEC 62304.
Pour une liste de contrôle plus complète sur les données de patients, consultez notre checklist HIPAA pour le développement logiciel.
Quelle stack technologique utiliser pour un logiciel biotech ?
Une stack biotech moderne associe une couche applicative web pour les scientifiques, un moteur de workflows pour les pipelines, un calcul cloud ou HPC élastique, une couche de données gouvernée pour les gros fichiers scientifiques et des interfaces standard vers les instruments et les systèmes cliniques. Le tableau présente les choix typiques en 2026.
| Couche | Technologies courantes |
|---|---|
| Application et interface | Front-ends React ou Angular ; back-ends Python (Django, FastAPI), Java ou .NET |
| Moteurs de workflows | Nextflow, Snakemake, WDL avec Cromwell, Airflow ou Prefect pour les traitements de données |
| Calcul scientifique | Python (NumPy, pandas, scikit-learn), R et Bioconductor, outils conteneurisés avec Docker |
| Calcul | Services batch et génomiques d’AWS, Google Cloud ou Azure, Kubernetes, HPC sous Slurm, GPU pour l’IA |
| Stockage des données | PostgreSQL pour les métadonnées ; stockage objet avec tables Parquet ou Delta pour les grands jeux de données ; formats spécialisés comme BAM, CRAM et Zarr |
| Standards d’instruments et de données | SiLA 2, Allotrope Simple Model, SDK des constructeurs |
| Interopérabilité clinique | HL7 v2 et FHIR pour le diagnostic et les systèmes destinés aux patients |
| IA et MLOps | PyTorch, registres de modèles, suivi des expériences, recherche vectorielle pour la littérature et les données de tests |
La stack compte moins que les choix d’architecture qui la sous-tendent : séparer les métadonnées des fichiers volumineux, garder des pipelines déclaratifs et versionnés et rendre chaque jeu de données adressable par un identifiant. Les équipes qui migrent de grosses charges vers le cloud liront aussi notre guide du développement de logiciels cloud.
Comment développe-t-on un logiciel biotech, étape par étape ?
Un logiciel biotech se construit au mieux par itérations courtes guidées par la science : commencer par une phase de découverte au laboratoire, modéliser les données avant les écrans, livrer tôt une première tranche fonctionnelle et ajouter la validation à mesure que le système se rapproche d’un usage réglementé. Un processus type compte sept étapes.
- Découverte au laboratoire. Observer les scientifiques à la paillasse, cartographier échantillons, instruments, fichiers et passations, et repérer où les données sont ressaisies ou perdues.
- Modèle de données et architecture. Définir les entités, le lignage et les standards de métadonnées ; décider quoi acheter, quoi développer et où résident les données.
- Cadrage réglementaire. Classer chaque composant selon le risque : recherche uniquement, pertinent GxP ou diagnostic. Cela détermine l’effort de validation.
- Tranche verticale fine. Livrer un processus de bout en bout – par exemple de la réception des échantillons aux résultats de séquençage – en huit à douze semaines.
- Intégration et automatisation. Connecter instruments, pipelines, ELN/LIMS et analytique ; supprimer les exports manuels.
- Vérification et validation. Tests automatisés pour tous les composants, plus documentation CSA ou CSV fondée sur le risque pour les composants réglementés.
- Déploiement, formation et support. Migrer les données historiques, former les scientifiques, suivre l’usage et tenir un backlog piloté par le laboratoire, pas par l’éditeur.
La même logique sous-tend notre guide du développement de logiciels de santé sur mesure, adaptée ici aux laboratoires de recherche.
Combien coûte le développement d’un logiciel biotech en 2026 ?
En 2026, le développement de logiciels biotech sur mesure coûte généralement de 40 000 à 120 000 $ pour un pipeline ou un outil de données ciblé, de 80 000 à 200 000 $ pour un module LIMS ou ELN sur mesure, de 200 000 à 600 000 $ pour une plateforme de données de recherche multi-omiques et de 300 000 $ à plus d’un million de dollars pour un système d’entreprise validé. Le périmètre, les intégrations et la validation déterminent la fourchette.
| Type de projet | Coût typique (2026) | Durée typique |
|---|---|---|
| Refonte d’un pipeline de bioinformatique ou outil de données | 40 000–120 000 $ | 2–4 mois |
| Module LIMS ou ELN sur mesure, ou couche d’intégration | 80 000–200 000 $ | 4–7 mois |
| Orchestration de l’automatisation de laboratoire | 100 000–300 000 $ | 4–9 mois |
| Plateforme de données de recherche multi-omiques | 200 000–600 000 $ | 6–12 mois |
| Système d’entreprise validé GxP | 300 000–1 000 000 $ et plus | 9–18 mois |
Ces fourchettes reflètent notre expérience de livraison et concordent avec les guides de prestataires publiés en 2026, qui citent environ 50 000 $ pour des outils de données ciblés jusqu’à plus de 500 000 $ pour des plateformes d’entreprise. Elles excluent les licences commerciales, le calcul et le stockage cloud, qui peuvent rivaliser avec le coût de développement dans les organisations à fort volume de séquençage.
Ce qui fait monter ou baisser le coût
- Nombre d’instruments et de systèmes à intégrer. Chaque instrument non standard ou système hérité ajoute du travail de connecteur, de test et de maintenance.
- Périmètre de validation. Les composants pertinents GxP ajoutent 20 à 40 % pour la documentation, les tests et le contrôle des changements.
- Volume de données et calcul. Un stockage à l’échelle du pétaoctet et des charges GPU exigent davantage de travail d’architecture et d’optimisation des coûts.
- Migration des données. Le transfert d’années de tableurs et de données d’un ancien LIMS est souvent sous-estimé.
- Modèle d’équipe et localisation. Les équipes nearshore mixtes coûtent moins cher que des équipes 100 % américaines à séniorité égale ; voir le coût du développement de logiciels de santé pour des repères de tarifs.
Quel modèle de collaboration choisir pour le développement de logiciels biotech ?
Une équipe dédiée est généralement le meilleur modèle de collaboration pour un logiciel biotech, car les besoins de la recherche évoluent sans cesse ; les projets au forfait ne fonctionnent que pour des éléments bien définis, comme la migration d’un seul pipeline ou un connecteur d’instrument. Le renfort d’équipe (staff augmentation) convient aux organisations qui disposent déjà d’un solide encadrement technique interne.
| Modèle | Fonctionnement | Idéal pour |
|---|---|---|
| Équipe dédiée | Une équipe pluridisciplinaire stable (tech lead, ingénieurs, data engineer, QA) travaille durablement sur votre backlog | Plateformes de données de recherche, LIMS/ELN évolutifs, outils d’IA |
| Projet au forfait | Périmètre, calendrier et prix convenus | Migrations de pipelines, connecteurs, modules validés aux exigences stables |
| Staff augmentation | Des ingénieurs rejoignent individuellement votre équipe interne | Organisations dotées d’un responsable interne de l’ingénierie ou de la bioinformatique |
| Sprint de cadrage | Deux à six semaines de cartographie des processus, d’architecture et d’estimation | Tout projet, avant d’engager un budget important |
Quel que soit le modèle, exigez un product owner proche des scientifiques de votre côté et un backlog partagé visible par le laboratoire. Notre comparatif régie, forfait ou équipe dédiée détaille les compromis.
Comment choisir une société de développement de logiciels biotech ?
Choisissez une société de développement de logiciels biotech qui a déjà livré des systèmes de données scientifiques, sait parler à vos scientifiques dans leur langage, conçoit dès le premier jour pour la validation et les données FAIR, et vous remet en pleine propriété le code, le modèle de données et la documentation.
- Maîtrise du domaine scientifique. Demandez des exemples liés au séquençage, aux tests, aux registres ou à l’automatisation de laboratoire, et associez un scientifique à l’entretien.
- Profondeur en ingénierie des données. Recherchez une expérience des moteurs de workflows, des gros fichiers, des modèles de métadonnées et de la maîtrise des coûts cloud, pas seulement des applications web.
- Livraison en environnement réglementé. Preuves de travaux sous 21 CFR Part 11, CSA/CSV, ISO 13485 ou HIPAA, avec des exemples de livrables de validation.
- Expérience des intégrations. Instruments, plateformes LIMS/ELN commerciales et systèmes cliniques déjà connectés.
- Niveau de sécurité. Pratiques ISO 27001 ou SOC 2, SDLC sécurisé et gestion claire des données issues de patients.
- Propriété et réversibilité. Cession contractuelle de la PI, architecture documentée et aucun verrouillage propriétaire.
- Modèle de livraison. Une équipe stable avec tech lead, soutien au product owner et recouvrement horaire avec vos scientifiques.
Notre grille générale pour choisir une société de développement logiciel s’applique aussi ; les points ci-dessus en constituent la couche propre à la biotech.
Quelles sont les tendances des logiciels biotech en 2026 ?
Les tendances marquantes des logiciels biotech en 2026 sont le passage de l’IA des pilotes à la boucle de découverte, la forte croissance des dépenses en bioinformatique et en LIMS, une infrastructure omique native cloud, les données FAIR comme prérequis de l’IA et des attentes réglementaires plus strictes envers les outils d’IA et cloud.
- Croissance du marché. MarketsandMarkets estime le marché de la bioinformatique à 18,63 milliards de dollars en 2026, avec 34,41 milliards en 2031 (TCAC de 13,1 %), et le marché des LIMS à 3,26 milliards de dollars en 2026, avec 5,84 milliards en 2031 (TCAC de 12,4 %).
- IA « lab-in-the-loop ». Les modèles de conception de protéines et de prédiction de propriétés sont de plus en plus reliés directement à des expériences automatisées ; le logiciel doit donc boucler prédiction, expérience et réentraînement.
- Omique native cloud. Les services génomiques managés et les formats de stockage objet remplacent les serveurs de fichiers sur site pour les données de séquençage.
- Données FAIR et ontologies. Les organisations investissent dans des standards de métadonnées et des vocabulaires contrôlés, car les modèles d’IA échouent sur des données incohérentes.
- Attention réglementaire portée à l’IA et au cloud. Le guide CSA cite désormais explicitement les outils cloud et d’IA/ML, et les principes FDA–EMA fixent des attentes en matière de gouvernance des modèles.
- IA générative pour les scientifiques. Des assistants qui interrogent la littérature, les protocoles et les données internes arrivent dans les ELN ; notre guide du développement de logiciels d’IA générative explique comment les construire en toute sécurité.
FAQ
Que fait une société de développement de logiciels biotech ?
Une société de développement de logiciels biotech conçoit et développe des logiciels sur mesure pour les entreprises de biotechnologie et les laboratoires de recherche, comme des LIMS, des cahiers de laboratoire électroniques, des pipelines de bioinformatique et de séquençage, des plateformes de données multi-omiques, des logiciels d’automatisation de laboratoire et des outils d’IA pour la recherche. Elle intègre aussi les instruments et les plateformes existantes, accompagne la validation pour un usage réglementé et maintient les systèmes après leur lancement.
Combien coûte le développement de logiciels biotech ?
En 2026, un pipeline de bioinformatique ou un outil de données ciblé coûte généralement de 40 000 à 120 000 $, un module LIMS ou ELN sur mesure de 80 000 à 200 000 $, une plateforme de données de recherche multi-omiques de 200 000 à 600 000 $ et un système d’entreprise validé GxP de 300 000 $ à plus d’un million de dollars. Les intégrations, le périmètre de validation et le volume de données déterminent le montant final.
Quelle est la différence entre logiciel biotech et logiciel pharmaceutique ?
Le logiciel biotech se concentre sur la découverte et la recherche : expériences, données biologiques, pipelines et méthodes en évolution rapide. Le logiciel pharmaceutique se concentre sur le cycle de vie réglementé du médicament : essais cliniques, fabrication BPF, qualité et pharmacovigilance. Les systèmes biotech privilégient la flexibilité et le volume de données, les systèmes pharma la validation et le contrôle des changements ; les deux convergent lorsque des données de recherche soutiennent des décisions réglementaires.
Une entreprise biotech doit-elle développer ou acheter un LIMS ?
Achetez un LIMS commercial si vos processus sont standard et que vous devez démarrer vite. Développez, ou construisez autour d’un cœur commercial, si vos entités, vos tests ou vos intégrations sont uniques et exigeraient une personnalisation lourde. Si plus d’environ un tiers des exigences nécessitent des contournements, une combinaison cœur commercial plus plateforme de données sur mesure revient généralement moins cher sur cinq ans.
Un logiciel biotech doit-il être conforme au 21 CFR Part 11 ?
Seulement lorsque ses enregistrements électroniques soutiennent des activités réglementées par la FDA, comme des études BPL, la fabrication BPF, des travaux cliniques ou des soumissions réglementaires. Les outils de pure recherche n’ont pas besoin d’une validation formelle Part 11, mais ils doivent tout de même intégrer pistes d’audit, contrôle d’accès et bonnes pratiques d’intégrité des données pour pouvoir être validés plus tard sans réécriture.
Combien de temps faut-il pour développer un logiciel biotech ?
Un pipeline ou un outil de données ciblé prend généralement deux à quatre mois, un module LIMS ou ELN sur mesure quatre à sept mois, une plateforme de données de recherche six à douze mois et un système d’entreprise validé neuf à dix-huit mois. Une première tranche fonctionnelle couvrant un processus peut généralement être livrée en huit à douze semaines.
Quels langages de programmation utilise-t-on en développement de logiciels de bioinformatique ?
Python et R dominent l’analyse et le calcul scientifique, avec Bioconductor pour les statistiques génomiques. Les pipelines sont écrits dans des langages de workflow comme Nextflow, Snakemake ou WDL, les outils critiques en performance souvent en C++, Rust ou Java, et les applications web destinées aux scientifiques utilisent généralement TypeScript avec React ou Angular au-dessus de back-ends Python, Java ou .NET.
Publié le 26 octobre 2026. Sources : MarketsandMarkets, Bioinformatics Market 2026–2031 ; MarketsandMarkets, LIMS Market 2026–2031 ; eCFR, 21 CFR Part 11 ; FDA, Computer Software Assurance for Production and Quality Management System Software (février 2026) ; FDA, projet de guide sur l’IA pour les décisions réglementaires concernant les médicaments et produits biologiques (janvier 2025) ; FDA–EMA, Guiding Principles of Good AI Practice in Drug Development (janvier 2026) ; guides de coûts de prestataires publiés en 2026. Les coûts sont des fourchettes de marché, pas des devis. Cet article est une information générale et ne constitue pas un conseil réglementaire.