Lo sviluppo di software di riconoscimento immagini è il lavoro di costruire un software che guarda una foto o un fotogramma di una telecamera, decide che cosa contiene — un prodotto, un difetto, un pannello danneggiato, un campo di un documento — e trasmette questa risposta al sistema che deve agire. Per la maggior parte delle aziende il punto di partenza è un controllo visivo manuale che non regge più i volumi: persone che smistano resi, ispezionano componenti, leggono etichette o confrontano le foto dei sinistri, con errori che si trasformano in rimborsi, difetti non intercettati e servizio lento. Il nostro team di servizi di sviluppo di computer vision costruisce proprio questi sistemi, e in questa guida condividiamo ciò che abbiamo imparato su come farlo bene.
Da solo, un modello di riconoscimento produce soltanto un’etichetta e un punteggio di confidenza. Acquista valore quando il risultato arriva all’ERP, al sistema di gestione del magazzino, alla piattaforma dei sinistri o all’app mobile dove qualcuno prende una decisione. Per questo trattiamo il riconoscimento immagini come parte dei nostri servizi di integrazione di modelli AI e non come un esperimento di data science a sé stante: acquisizione, modello, regole di business, revisione umana e feedback devono funzionare come un unico prodotto.
Le sezioni che seguono sono scritte per CTO, responsabili di prodotto e responsabili operativi. Trattano le attività di riconoscimento che si possono costruire, come funziona la pipeline, quando basta un’API gestita come Google Cloud Vision o Amazon Rekognition, quanti dati etichettati servono, quali metriche di accuratezza contano, dove deve girare il modello, lo stack tecnologico 2026, le fasce di costi e tempi, il team, le regole legali e le domande da porre a un fornitore. Per flussi video, robotica e il campo nel suo insieme, consultate la nostra guida allo sviluppo di software di computer vision.
Che cos’è lo sviluppo di software di riconoscimento immagini?
Lo sviluppo di software di riconoscimento immagini è il processo di progettazione, addestramento, integrazione e gestione di un sistema che identifica oggetti, attributi o testo in immagini statiche e restituisce un risultato strutturato utilizzabile dal vostro software. Combina il machine learning, di solito una rete neurale profonda, con l’ingegneria tradizionale: pipeline di dati, API, interfacce utente, sicurezza e monitoraggio.
L’input è un’immagine: una foto da smartphone, una scansione, un fotogramma di una telecamera industriale, una porzione di immagine satellitare o la foto di un prodotto caricata da un cliente. L’output dipende dall’attività. Un modello di riconoscimento può restituire uno o più dei seguenti elementi:
- Un’etichetta — «graffio», «maturo», «SKU 4471» — con un punteggio di confidenza compreso tra 0 e 1.
- Un riquadro di delimitazione (bounding box) attorno a ogni oggetto trovato, con un’etichetta per ciascun riquadro.
- Una maschera di pixel che delinea la forma esatta di un oggetto o di una regione, come un’ammaccatura o una lesione.
- Testo letto dall’immagine tramite riconoscimento ottico dei caratteri (OCR), spesso con la sua posizione nella pagina.
- Un embedding — un vettore di numeri che descrive l’immagine e permette di trovare immagini visivamente simili.
In un prodotto, il modello si colloca tra acquisizione e decisione. Un’app mobile, una telecamera o un modulo di caricamento invia l’immagine al modello; l’output del modello passa attraverso regole di business (per esempio, «scarta se la probabilità di difetto supera 0,9»), a volte arriva a un revisore umano e poi entra nel sistema che registra la decisione. La maggior parte dello sforzo di ingegneria sta intorno al modello, non dentro di esso.
Riconoscimento immagini vs computer vision: qual è la differenza?
Il riconoscimento immagini è un sottoinsieme della computer vision: risponde alla domanda «che cosa c’è in questa immagine?», mentre la computer vision comprende ogni modo in cui un software può interpretare dati visivi, inclusi il tracciamento video, la ricostruzione 3D, l’analisi del movimento e la guida dei robot. In pratica, la maggior parte dei progetti aziendali che nascono come «computer vision» sono progetti di riconoscimento su immagini statiche.
| Aspetto | Riconoscimento immagini | Computer vision (campo più ampio) |
|---|---|---|
| Ambito | Identificare oggetti, attributi o testo in una singola immagine | Qualsiasi comprensione visiva: immagini, video, profondità, movimento, 3D |
| Output tipici | Etichette, riquadri, maschere, testo, punteggi di similarità | In più tracce nel tempo, pose, mappe 3D, calibrazione delle telecamere |
| Esempi | Classificazione dei difetti, riconoscimento dei prodotti a scaffale, lettura di documenti d’identità, foto dei danni | Conteggio delle persone nei video, guida autonoma, picking robotizzato, AR |
| Dati | Immagini statiche etichettate | Immagini, clip video, dati di profondità e dei sensori |
| Progetto tipico | Un modello o un piccolo insieme di modelli dietro un’API, integrati in un flusso di lavoro | Sistemi multisensore con pipeline in tempo reale e hardware specializzato |
Se le vostre immagini arrivano come flussi video continui da molte telecamere, il problema cambia: servono campionamento dei fotogrammi, tracciamento, elaborazione in streaming e hardware diverso. Il nostro articolo sulla video analytics con AI tratta questo caso. Per una visione d’insieme del campo, dalla robotica all’imaging medico, leggete la guida allo sviluppo di software di computer vision. Il resto di questo articolo resta sul riconoscimento di immagini statiche.
Quali tipi di riconoscimento immagini si possono costruire?
Esistono sei tipi principali di riconoscimento immagini, e scegliere quello giusto è la prima decisione di progettazione, perché determina lo sforzo di etichettatura, la famiglia di modelli e il costo. Molti prodotti ne combinano due o tre, per esempio il rilevamento seguito dalla classificazione di ogni oggetto rilevato.
Classificazione delle immagini (a etichetta singola e multi-etichetta)
La classificazione assegna una o più etichette all’intera immagine. La classificazione a etichetta singola risponde a «quale?» — pezzo buono o difettoso, gatto o cane, categoria di prodotto A, B o C. La classificazione multi-etichetta consente più etichette contemporaneamente, come «esterno», «notte» e «veicolo». La classificazione è l’attività più economica da etichettare, perché gli annotatori assegnano solo un tag all’immagine, ed è la scelta giusta quando l’oggetto occupa la maggior parte dell’inquadratura.
Rilevamento degli oggetti
Il rilevamento degli oggetti (object detection) trova ogni istanza di ciascun oggetto in un’immagine e disegna un riquadro attorno a essa. Usatelo quando un’immagine contiene più elementi, quando dovete contarli o quando conta la posizione, come negli audit degli scaffali, nel conteggio dei pacchi o nella localizzazione dei difetti su un pannello di grandi dimensioni. I modelli di rilevamento come la famiglia YOLO sono abbastanza veloci da funzionare in tempo reale su hardware modesto.
Segmentazione (semantica e di istanza)
La segmentazione etichetta i singoli pixel invece dell’intera immagine o di un riquadro. La segmentazione semantica indica quali pixel appartengono a ciascuna classe (strada, coltura, sfondo); la segmentazione di istanza separa anche i singoli oggetti della stessa classe. Sceglietela quando contano la forma o l’area esatte — misurare l’estensione di una zona di corrosione, l’area colpita da una malattia delle colture o il contorno di un danno sulla portiera di un’auto. È l’attività più costosa da etichettare.
OCR e riconoscimento dei documenti
L’OCR legge testo stampato o scritto a mano nelle immagini, e il riconoscimento dei documenti va oltre, individuando campi specifici come nomi, date, totali o numeri di serie e restituendoli come dati strutturati. Gli usi tipici sono fatture, etichette di spedizione, letture dei contatori, documenti d’identità e targhette di prodotto. Le pipeline moderne combinano un rilevatore di testo, un riconoscitore di testo e un modello di layout o linguistico che associa il testo ai campi.
Riconoscimento e verifica del volto
La verifica del volto controlla se due immagini di volti appartengono alla stessa persona (per esempio, un selfie confrontato con la foto di un documento), mentre l’identificazione del volto cerca una corrispondenza in un database. Sono tecnologie mature, ma comportano il rischio legale più alto tra tutte le attività di riconoscimento, perché i modelli biometrici del volto sono dati biometrici nell’UE e in diversi stati USA. Pianificate una revisione legale prima di progettare la funzionalità, come descritto nella sezione sulla conformità più avanti.
Ricerca per similarità visiva con embedding
La ricerca visiva converte ogni immagine in un vettore di embedding e trova i vettori più vicini in un database, così gli utenti possono cercare tramite foto invece che per parola chiave. È alla base di funzioni come «trova prodotti simili», il rilevamento dei duplicati, la ricerca di ricambi da una foto scattata con il telefono e l’abbinamento ai cataloghi. Poiché non richiede un elenco fisso di classi, i nuovi articoli si aggiungono indicizzandone le immagini, senza riaddestrare il modello.
| Attività | Output | Esempio di business | Famiglia di modelli tipica | Sforzo di etichettatura |
|---|---|---|---|---|
| Classificazione | Etichetta/e per immagine | Pezzo buono/difettoso, categoria di prodotto | CNN (ResNet, EfficientNet), vision transformer (ViT) | Basso — un tag per immagine |
| Rilevamento degli oggetti | Riquadri + etichette | Audit degli scaffali, conteggio dei pacchi | YOLO, rilevatori in stile DETR | Medio — disegnare riquadri |
| Segmentazione | Maschere di pixel | Area del danno, area colpita da malattie delle colture | U-Net, Mask R-CNN, modelli assistiti da SAM | Alto — poligoni o maschere |
| OCR / riconoscimento dei documenti | Testo + campi | Fatture, etichette, documenti d’identità | Rilevatore + riconoscitore di testo, modelli di layout | Medio — tag di testo e campi |
| Verifica del volto | Punteggio di corrispondenza | Verifica selfie-documento | Reti di embedding facciale | Medio, più lavoro su consenso e aspetti legali |
| Ricerca visiva | Immagini simili in ordine di rilevanza | «Trova simili», ricerca di ricambi | Modelli di embedding (in stile CLIP, ViT) | Da basso a medio — coppie o metadati di catalogo |
Come funziona un software di riconoscimento immagini?
Un software di riconoscimento immagini funziona come una pipeline in sei passaggi: acquisisce un’immagine, la prepara, esegue il modello, ripulisce l’output grezzo del modello, applica regole di business o revisione umana e infine reimmette il risultato nell’addestramento. Ogni passaggio può fallire in modo indipendente, quindi i buoni sistemi registrano e monitorano tutti e sei, non solo il modello.
- Acquisizione. Una telecamera, un telefono o un modulo di caricamento produce l’immagine. Qui si fissano illuminazione, angolazione, risoluzione e sfondo, che contano quanto il modello: una postazione di acquisizione controllata spesso fa guadagnare più accuratezza di una rete più grande.
- Pre-elaborazione. L’immagine viene ridimensionata, normalizzata, ritagliata sulla regione di interesse e talvolta corretta per colore o prospettiva. Dati personali come volti o targhe possono essere sfocati in questa fase se non servono.
- Inferenza del modello. Una rete neurale addestrata — per esempio una rete neurale convoluzionale (CNN) o un vision transformer (ViT) — trasforma i pixel in previsioni: probabilità delle classi, riquadri, maschere o un embedding.
- Post-elaborazione. Le previsioni grezze vengono filtrate con soglie di confidenza, i riquadri sovrapposti vengono uniti con la non-maximum suppression (NMS) e i risultati vengono tradotti nel vostro vocabolario di business («classe 7» diventa «microfessura»).
- Regola di business o revisione umana. I risultati ad alta confidenza attivano automaticamente un’azione; quelli incerti finiscono nella coda di un revisore; la decisione finale viene scritta nell’ERP, nel WMS, nel sistema dei sinistri o nell’app.
- Ciclo di feedback. Le correzioni dei revisori e i nuovi casi limite acquisiti vengono archiviati, etichettati e usati per riaddestrare il modello, così l’accuratezza migliora e il modello segue i cambiamenti di prodotti, telecamere o stagioni.
Dietro le quinte, i moderni modelli di riconoscimento apprendono le caratteristiche visive a strati: i primi strati rilevano bordi e texture, quelli successivi li combinano in parti e oggetti. Quasi nessun progetto aziendale addestra una rete da zero. I team partono invece da un modello pre-addestrato su milioni di immagini pubbliche e lo perfezionano (fine-tuning) sulle proprie immagini etichettate — una tecnica chiamata transfer learning che riduce drasticamente il fabbisogno di dati e i tempi di addestramento.
Dove ripaga il riconoscimento immagini? Casi d’uso per settore
Il riconoscimento immagini ripaga dove le persone guardano ripetutamente immagini per prendere lo stesso tipo di decisione, dove gli errori costano cari o dove i volumi rendono impossibili i controlli manuali. La tabella mostra i casi d’uso tipici per settore e come misurarne il risultato; il guadagno effettivo dipende dalla vostra situazione di partenza, quindi misuratela prima che il progetto inizi.
| Settore | Problema | Cosa fa il modello | Come misurare il risultato |
|---|---|---|---|
| Manifattura | I difetti sfuggono all’ispezione manuale; gli ispettori si stancano | Classifica o segmenta graffi, crepe e parti mancanti sulla linea | Tasso di difetti non intercettati, tasso di falsi scarti, tempo di ispezione per pezzo |
| Retail ed e-commerce | Buchi a scaffale, facing errati, tagging lento del catalogo | Rileva i prodotti sugli scaffali; assegna tag alle foto dei prodotti; alimenta la ricerca visiva | Tempo di rilevamento delle rotture di stock, ore di tagging, conversione della ricerca |
| Logistica | Etichette illeggibili o smistate male, pacchi danneggiati | Legge le etichette con l’OCR, rileva i danni, verifica il numero di pacchi | Tasso di smistamenti errati, ore di inserimento manuale, reclami per danni |
| Assicurazioni | Valutazione dei danni dalle foto lenta e disomogenea | Rileva e segmenta le parti danneggiate, stima la gravità per lo smistamento | Tempo di gestione dei sinistri, quota di sinistri smistati automaticamente, ore dei periti |
| Sanità | Grandi volumi di immagini da pre-esaminare | Segnala reperti per la revisione del medico (supporto decisionale, non diagnosi) | Tempo di refertazione, accuratezza della prioritizzazione, carico di lavoro dei revisori |
| Agricoltura | Malattie e parassiti scoperti troppo tardi | Classifica le malattie delle piante da immagini sul campo o da drone | Anticipo del rilevamento, superficie trattata, perdita di resa |
| Fintech | Documenti d’identità fraudolenti o di bassa qualità in fase di onboarding | Legge i campi del documento, ne verifica la qualità e confronta il selfie con il documento | Completamento dell’onboarding, quota di revisione manuale, perdite per frode |
Le fabbriche vedono di solito il ritorno più rapido, perché il costo dell’errore è concreto e le condizioni di acquisizione sono controllabili; la nostra panoramica sullo sviluppo software per la manifattura mostra dove si inserisce l’ispezione nei sistemi MES e di qualità. I retailer combinano il riconoscimento a scaffale con la ricerca visiva, come descritto nella nostra guida allo sviluppo software per il retail. L’imaging medico porta con sé formati di dati e regole propri; leggete sviluppo di software per l’analisi di immagini mediche prima di pianificare un progetto in ambito sanitario.
API pronta, modello custom o ibrido: quale scegliere?
Scegliete un’API pronta quando le vostre etichette sono generiche e i volumi moderati, un modello custom quando vi servono classi specifiche del dominio, maggiore accuratezza o pieno controllo dei dati, e una soluzione ibrida quando un’API può gestire i casi comuni e un piccolo modello custom il resto. La maggior parte dei progetti dovrebbe iniziare testando un’API sulle proprie immagini, perché questa base di riferimento costa giorni, non mesi.
| Criterio | API gestita (es. Google Cloud Vision, Amazon Rekognition) | Modello custom | Ibrido |
|---|---|---|---|
| Tempo al primo risultato | Da ore a giorni | 4–8 settimane per un PoC | 2–6 settimane |
| Accuratezza su classi di nicchia | Da bassa a media — solo etichette generiche | Alta, se addestrato su dati rappresentativi | Alta sulle classi che contano |
| Dati necessari | Nessuno (o un piccolo set per i servizi a etichette personalizzate) | Da centinaia a migliaia di immagini etichettate per classe | Dati etichettati solo per la parte custom |
| Profilo di costo | Pagamento per immagine; cresce linearmente con il volume | Sviluppo iniziale più hosting fisso; costo marginale basso | Misto |
| Controllo dei dati | Immagini elaborate dal provider | Possono restare nel vostro cloud, on-premise o sul dispositivo | Le immagini sensibili possono restare nella parte custom |
| Lock-in | Alto — set di etichette e API sono specifici del provider | Basso — pesi e codice sono vostri | Medio |
Quanto costano le API gestite di riconoscimento immagini nel 2026
Le API gestite fanno pagare per immagine o per funzionalità, e i prezzi di listino di ottobre 2026 sono abbastanza bassi da rendere un pilota quasi gratuito. Secondo la pagina dei prezzi di Cloud Vision API di Google, le prime 1.000 unità al mese sono gratuite; rilevamento delle etichette, OCR e rilevamento dei volti costano poi 1,50 $ ogni 1.000 unità fino a 5 milioni di unità al mese, mentre la localizzazione degli oggetti costa 2,25 $ ogni 1.000. Oltre i 5 milioni di unità, il rilevamento delle etichette scende a 1,00 $ ogni 1.000. I prezzi di Rekognition di Amazon partono da 0,001 $ per immagine per le API standard di immagine nella regione US East, con tariffe per immagine più basse ai volumi maggiori. Per le vostre classi, Rekognition Custom Labels costa 1 $ per ora di addestramento e 4 $ per ora di inferenza finché il modello è in esecuzione.
Esempio di calcolo: quando un modello custom diventa più economico?
Il punto di pareggio tra API e modello custom dipende dal volume, e il calcolo è abbastanza semplice da farlo prima di parlare con qualsiasi fornitore. Le cifre che seguono sono una stima illustrativa di YuSMP basata sui prezzi di listino, non un preventivo.
- 2 milioni di immagini al mese con il rilevamento delle etichette di Cloud Vision: circa 1.999 migliaia fatturabili × 1,50 $ ≈ 3.000 $ al mese, ovvero circa 36.000 $ all’anno.
- Lo stesso volume con un classificatore perfezionato in self-hosting: 2 milioni di immagini al mese sono in media meno di un’immagine al secondo. Una o due istanze GPU cloud di fascia base costano di solito circa 400–1.200 $ al mese on demand, quindi l’hosting si aggira sui 1.000 $ al mese inclusi storage e monitoraggio.
- Risparmio a 2 milioni di immagini: circa 2.000 $ al mese. A fronte di uno sviluppo custom da 60.000–120.000 $, i soli risparmi sull’inferenza richiederebbero diversi anni per ripagare l’investimento.
- A 20 milioni di immagini al mese: il rilevamento delle etichette di Cloud Vision costa circa 7.500 $ per i primi 5 milioni di unità più 15.000 $ per i successivi 15 milioni, in tutto circa 22.500 $ al mese. Il self-hosting su più istanze GPU potrebbe costare 2.000–4.000 $, con un risparmio vicino a 20.000 $ al mese — abbastanza per ripagare uno sviluppo da 100.000 $ in circa sei mesi.
- Custom Labels in esecuzione 24 ore su 24: un’unità di inferenza a 4 $ l’ora per circa 730 ore al mese costa circa 2.900 $ al mese, prima dei costi di addestramento. Questo lo rende un buono strumento per i piloti e per i modelli che devono girare solo durante finestre di elaborazione batch.
La lezione: a volumi moderati il costo raramente giustifica da solo un modello custom; di solito lo giustificano l’accuratezza, il controllo dei dati o il funzionamento offline. A volumi elevati il prezzo per immagine diventa l’argomento principale. Rifate questo calcolo con il vostro volume, la previsione di crescita e l’accuratezza richiesta prima di decidere.
Quando conviene lo sviluppo di software di riconoscimento immagini su misura?
Lo sviluppo di software di riconoscimento immagini su misura conviene quando un’API generica non riesce a riconoscere ciò che conta per il vostro business, non raggiunge l’accuratezza di cui avete bisogno o non può, per motivi legali o tecnici, vedere le vostre immagini. Se nessuno dei fattori scatenanti qui sotto si applica, partite da un’API gestita e rivalutate la decisione quando il volume cresce.
- Classi specifiche del dominio. Dovete distinguere le vostre varianti di prodotto, tipi di difetto, codici di componenti o malattie delle piante, che nessun set di etichette pubblico contiene.
- Accuratezza superiore al riferimento dell’API. I test sulle vostre immagini mostrano che l’API manca troppi casi, e ogni mancato riconoscimento ha un costo reale — un pezzo difettoso spedito, un documento fraudolento accettato.
- Immagini sensibili o proprietarie. Immagini mediche, documenti d’identità, volti o design di prodotto riservati devono restare nel vostro ambiente per ragioni di GDPR, HIPAA o contrattuali.
- Funzionamento edge o offline. La telecamera si trova su una linea di produzione, su un veicolo o su un telefono in un magazzino senza connettività affidabile, oppure la latenza deve restare sotto qualche decina di millisecondi.
- Costo per chiamata su larga scala. Elaborate decine di milioni di immagini al mese, e l’esempio di calcolo qui sopra mostra un ritorno rapido.
- Spiegabilità e audit. Dovete documentare come il modello è stato addestrato e testato, fissare soglie per classe e dimostrare perché è stata presa una decisione automatizzata.
Una via di mezzo utile è perfezionare un modello pre-addestrato aperto sui vostri dati. Ottenete gran parte dell’accuratezza dello sviluppo di software di riconoscimento immagini su misura a una frazione del costo di progettare una rete da zero, e i pesi restano vostri.
Come costruire un software di riconoscimento immagini: il processo passo dopo passo
Costruire un software di riconoscimento immagini richiede dieci passaggi, dalla definizione della decisione che il modello supporta fino al suo riaddestramento in produzione. Ogni passaggio si conclude con un deliverable concreto, così potete fermarvi o cambiare direzione prima di spendere l’intero budget.
1. Definite la decisione e il costo di ogni errore
Mettete per iscritto quale decisione supporterà il modello, chi agisce in base a essa e quanto costa una risposta sbagliata. Un difetto non rilevato (falso negativo) e un pezzo buono scartato (falso positivo) hanno di solito prezzi molto diversi. Deliverable: una descrizione del problema di una pagina con la metrica obiettivo e i costi degli errori.
2. Verificate i dati che avete già
Raccogliete un campione di immagini reali dalle telecamere o dagli utenti effettivi, controllate risoluzione, illuminazione, angolazioni e quanti esempi esistono per classe, e confermate di avere il diritto di usarle. Deliverable: un audit dei dati con le lacune e un piano di raccolta.
3. Pianificate l’etichettatura
Scegliete il tipo di annotazione (tag, riquadri o poligoni), scrivete linee guida di etichettatura con esempi visivi per ogni classe e caso limite e decidete chi etichetta: esperti interni, un team di un fornitore o entrambi. Deliverable: una guida all’etichettatura e un set pilota etichettato.
4. Fissate una base di riferimento con un’API o un modello pre-addestrato
Eseguite un’API gestita o un modello pre-addestrato pronto all’uso sul set pilota. Questa base di riferimento vi dice quanto è difficile il problema e se serve davvero un lavoro custom. Deliverable: metriche di riferimento per classe.
5. Selezionate il modello e applicate il transfer learning
Scegliete una famiglia di modelli adatta all’attività e alla destinazione di rilascio — una CNN compatta per un telefono, un rilevatore YOLO per il conteggio in tempo reale, un ViT per la classificazione a grana fine — e partite da pesi pre-addestrati. Deliverable: una scelta del modello con una motivazione scritta.
6. Addestrate con la data augmentation
Perfezionate il modello sui vostri dati etichettati, usando l’augmentation (rotazioni, ritagli, variazioni di luminosità e sfocatura) per simulare la variabilità del mondo reale, e tracciate ogni esperimento perché i risultati siano riproducibili. Deliverable: modelli candidati addestrati con i log degli esperimenti.
7. Valutate su un set di test reale tenuto da parte
Testate solo su immagini che il modello non ha mai visto, acquisite in condizioni reali, e riportate precision, recall e F1 per classe più una matrice di confusione. Fissate le soglie di confidenza in base ai costi degli errori definiti al passaggio 1. Deliverable: un report di valutazione e soglie concordate.
8. Integrate il modello nei vostri sistemi
Incapsulate il modello in un’API o in un SDK, collegatelo all’ERP, al WMS, al sistema dei sinistri o all’app mobile, costruite la schermata di revisione umana e registrate ogni previsione. Deliverable: un flusso di lavoro integrato e testato end-to-end.
9. Rilasciate nel cloud o sull’edge
Impacchettate il modello per la sua destinazione — un servizio GPU nel cloud, un box edge accanto alla telecamera o un formato per il dispositivo — con versionamento e rollback. Deliverable: rilascio in produzione con un piano di rollback.
10. Monitorate il drift e riaddestrate
Tenete traccia della quota di previsioni a bassa confidenza, delle correzioni dei revisori e dell’accuratezza su nuovi campioni etichettati; quando un nuovo prodotto, una nuova telecamera o una stagione spostano i dati, riaddestrate e rilasciate di nuovo. La nostra guida allo sviluppo software di machine learning descrive le pratiche MLOps alla base di questo ciclo. Deliverable: dashboard di monitoraggio e un calendario di riaddestramento.
Quanti dati di addestramento servono e come vanno etichettati?
Con il transfer learning, un proof of concept funziona spesso con qualche centinaio di immagini etichettate per classe, mentre un modello di produzione richiede di solito migliaia di immagini per classe più casi limite raccolti di proposito. Considerate questi numeri regole empiriche, non garanzie: classi simili tra loro, difetti piccoli e illuminazione variabile fanno salire il fabbisogno.
Nei progetti YuSMP, raccolta, pulizia ed etichettatura dei dati richiedono di solito il 30–50% dello sforzo totale — più dell’addestramento del modello. Pianificatele dalla prima settimana, perché un modello non può mai essere migliore degli esempi da cui ha imparato.
Tipi di annotazione e sforzo richiesto
Il tipo di annotazione segue l’attività di riconoscimento e determina il costo di etichettatura. I tag a livello di immagine per la classificazione sono rapidi — spesso pochi secondi per immagine. I riquadri per il rilevamento richiedono più tempo, perché ogni oggetto va disegnato. Poligoni o maschere di pixel per la segmentazione richiedono il tempo maggiore per immagine. Strumenti come Label Studio e CVAT supportano tutti e tre, e l’etichettatura assistita dal modello, in cui un modello preliminare o un modello visione-linguaggio propone etichette che le persone correggono, può ridurre i tempi in modo considerevole.
Squilibrio tra classi e difetti rari
Lo squilibrio tra classi è la norma nei dati aziendali: una linea di produzione può produrre migliaia di pezzi buoni per ogni pezzo difettoso. Un modello addestrato su questi dati può ottenere un’«accuratezza» elevata prevedendo «buono» ogni volta. Contrastatelo raccogliendo di proposito i casi rari, sovracampionandoli durante l’addestramento, pesando la funzione di perdita e, soprattutto, misurando la recall per classe invece dell’accuratezza complessiva.
Dati sintetici e augmentation
L’augmentation crea varianti delle immagini esistenti — ribaltamenti, rotazioni, ritagli, variazioni di colore, rumore — ed è standard in ogni addestramento. I dati sintetici vanno oltre, renderizzando o generando nuove immagini, per esempio render 3D di difetti rari o sfondi generati per i prodotti. Aiutano quando gli esempi reali scarseggiano, ma convalidate sempre su immagini reali, perché i modelli possono imparare gli artefatti del generatore.
Controllo qualità delle etichette
Etichette incoerenti danneggiano l’accuratezza quanto un numero insufficiente di etichette. Scrivete linee guida chiare con esempi di casi limite, fate etichettare un campione di immagini da un secondo annotatore, misurate l’accordo tra annotatori e rivedete i disaccordi con un esperto del dominio. Se due esperti non riescono a concordare su un’etichetta, nemmeno il modello la imparerà in modo affidabile — e questo è un risultato che riguarda il processo, non solo i dati.
Quanto deve essere accurato il riconoscimento immagini? Metriche e soglie
Il riconoscimento immagini deve essere abbastanza accurato da far sì che il costo degli errori residui sia inferiore al costo del processo attuale, e questo obiettivo va fissato per classe usando precision e recall, non un unico numero di «accuratezza». Un modello con il 99% di accuratezza può essere comunque inutile se manca proprio l’1% di casi che contano.
| Metrica | Cosa vi dice | Quando conta di più |
|---|---|---|
| Precision | Di tutto ciò che il modello ha segnalato, quanto era corretto | Quando i falsi allarmi costano cari (pezzi buoni scartati, clienti bloccati) |
| Recall | Di tutto ciò che andava segnalato, quanto ne ha trovato il modello | Quando i mancati rilevamenti costano cari (difetti spediti, frodi accettate) |
| F1 score | L’equilibrio tra precision e recall in un solo numero | Per confrontare modelli quando contano entrambi i tipi di errore |
| mAP (mean average precision) | La qualità del rilevamento tra classi e livelli di confidenza | Benchmark di rilevamento degli oggetti |
| IoU (intersection over union) | Quanto un riquadro o una maschera prevista si sovrappone a quella reale | Rilevamento e segmentazione, quando contano posizione o dimensioni |
| Matrice di confusione | Quali classi il modello confonde | Per individuare classi simili che richiedono più dati |
Soglie di confidenza e revisione human-in-the-loop
Ogni previsione è accompagnata da un punteggio di confidenza, e le soglie che fissate su quel punteggio decidono come si comporta il sistema. Un approccio comune usa tre fasce:
- Accettazione automatica sopra una soglia alta, dove il modello ha ragione in modo affidabile.
- Revisione umana nella fascia intermedia, dove il modello è incerto; un revisore vede l’immagine, la previsione e opzioni a un clic.
- Scarto automatico o nuova acquisizione sotto una soglia bassa, per esempio chiedendo all’utente di rifare una foto sfocata.
Fissate le fasce in base ai costi degli errori, non all’intuito. Supponiamo che un difetto non rilevato costi 400 $ tra garanzia e gestione, un falso scarto 8 $ di nuova ispezione e una revisione umana 0,50 $. In questo caso è razionale inviare alla revisione — o persino scartare — molti più casi borderline rispetto a quando i due errori costano lo stesso. Ricalcolate le soglie ogni volta che cambiano i costi degli errori o il modello, e usate le decisioni dei revisori come nuove etichette di addestramento: la revisione human-in-the-loop è sia una rete di sicurezza sia la fonte più economica di dati di alto valore.
Cloud, edge o sul dispositivo: dove deve girare il modello?
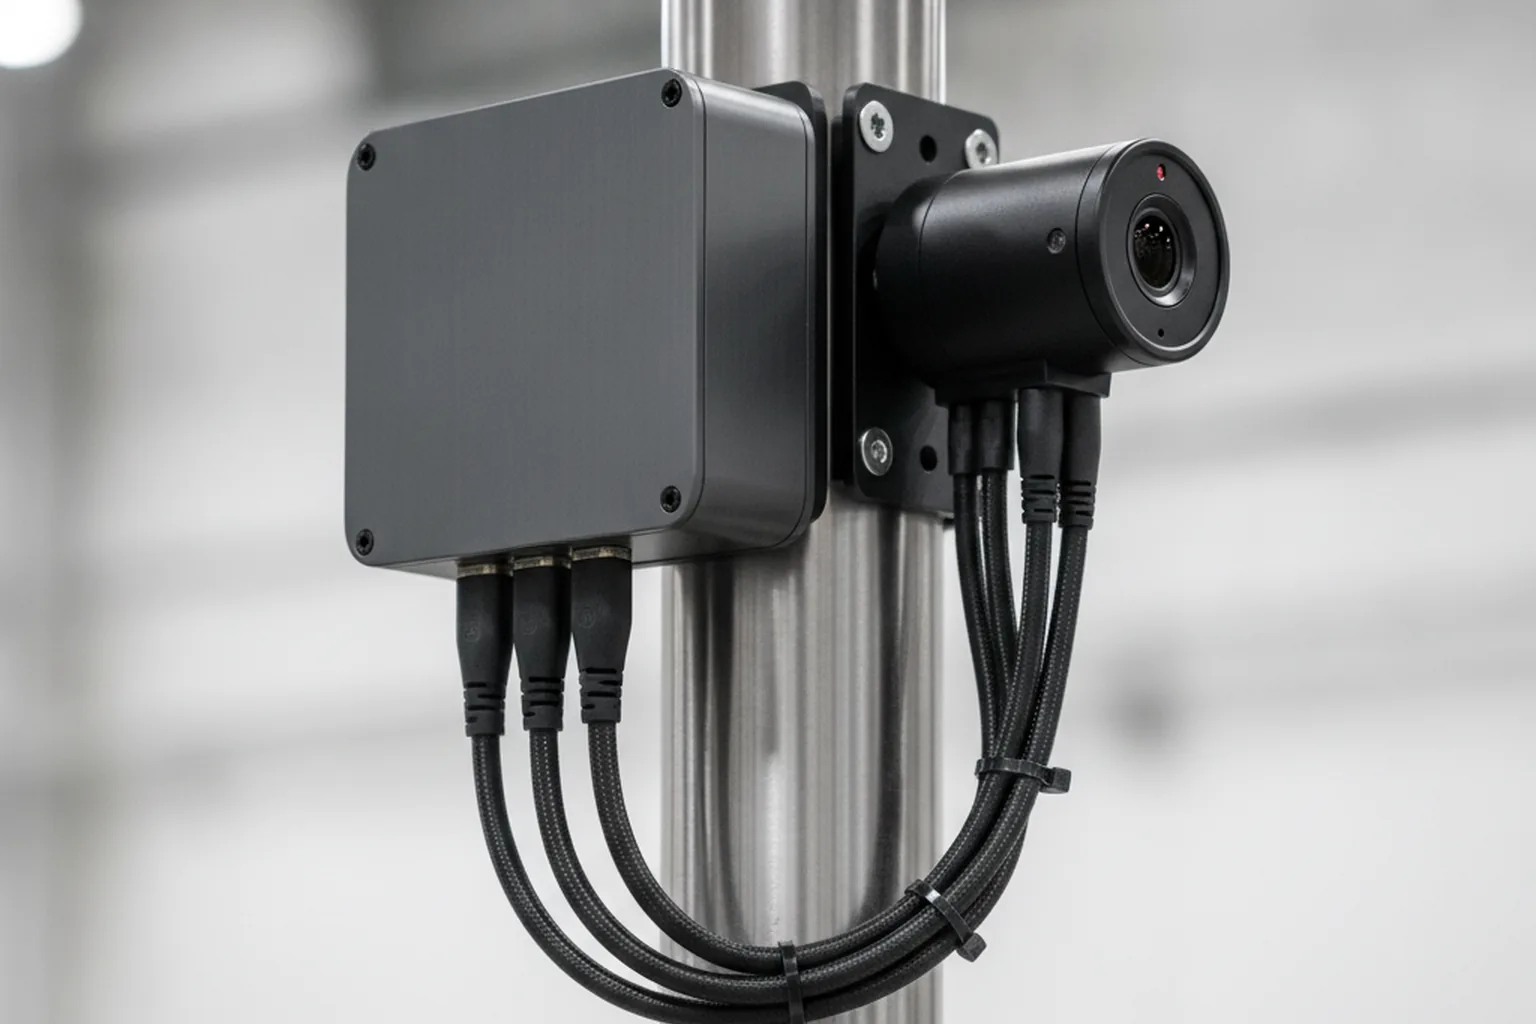
Fate girare il modello nel cloud quando le immagini arrivano già online e una latenza di un secondo è accettabile; su un dispositivo edge accanto alla telecamera quando vi servono decisioni in tempo reale o la connettività è inaffidabile; e sul telefono dell’utente quando privacy, uso offline o costo per immagine contano di più. Molti sistemi li combinano: un modello piccolo sul dispositivo e uno più grande nel cloud per i casi difficili.
| Fattore | Cloud | Dispositivo edge | Sul dispositivo (telefono, tablet) |
|---|---|---|---|
| Latenza | Da centinaia di ms a secondi, in base alla rete | Da millisecondi a decine di ms | Da millisecondi a decine di ms |
| Costo | Per chiamata o per ora di GPU | Hardware per sito più manutenzione | Nessun costo di inferenza; budget di dimensioni dell’app e batteria |
| Privacy | Le immagini lasciano il sito | Le immagini possono restare in sede | Le immagini possono restare sul dispositivo |
| Connettività | Necessaria | Funziona offline, sincronizza i risultati | Funziona offline |
| Hardware e dimensioni del modello | Modelli di qualsiasi dimensione | Limitate dalla GPU o dall’acceleratore edge | Solo modelli compatti e quantizzati |
Per il rilascio su edge e dispositivi, i modelli vengono esportati in runtime ottimizzati: ONNX Runtime e NVIDIA TensorRT per i computer edge, Core ML per iPhone e iPad, e TensorFlow Lite — oggi chiamato LiteRT — per Android e i dispositivi embedded. La quantizzazione a interi a 8 bit riduce di solito il modello di circa quattro volte, con una piccola perdita di accuratezza che dovreste misurare sul vostro set di test. Il nostro articolo sull’AI sul dispositivo nelle app mobili spiega più nel dettaglio il lato mobile.
Lo stack tecnologico per il riconoscimento immagini nel 2026
Lo stack di riconoscimento immagini del 2026 è in gran parte open source: addestramento basato su PyTorch, strumenti di etichettatura come Label Studio o CVAT, runtime ottimizzati come ONNX Runtime per il serving e strumenti MLOps per tracciare dati e modelli. I servizi cloud gestiti lo completano per basi di riferimento e piloti.
| Livello | Strumenti comuni nel 2026 | Note |
|---|---|---|
| Dati ed etichettatura | Label Studio, CVAT | Supportano tag, riquadri, poligoni e pre-etichettatura assistita dal modello |
| Addestramento | PyTorch, TensorFlow/Keras, Ultralytics YOLO, timm e gli hub di modelli Hugging Face | Pesi pre-addestrati per il transfer learning |
| Computer vision classica | OpenCV | Pre-elaborazione, geometria, controlli basati su regole |
| Serving | ONNX Runtime, NVIDIA Triton Inference Server, TorchServe, servizi FastAPI | Batching, condivisione delle GPU, endpoint versionati |
| Edge e mobile | TensorRT, Core ML, TensorFlow Lite / LiteRT | Build quantizzate e specifiche per l’hardware |
| Storage | Object storage per le immagini; database vettoriali per gli embedding | La ricerca vettoriale alimenta le funzioni di similarità visiva |
| MLOps | MLflow, DVC | Tracciamento degli esperimenti, versionamento di dataset e modelli |
| Servizi gestiti | Google Cloud Vision, Amazon Rekognition, Azure AI Vision | Basi di riferimento, etichette generiche, OCR, piloti |
I modelli visione-linguaggio (VLM), che comprendono immagini e testo insieme, sono ormai una parte concreta dello stack. Raramente sono l’opzione più economica per l’inferenza di produzione ad alto volume, ma sono molto utili per l’etichettatura zero-shot, la pre-annotazione dei dataset, la gestione delle classi rare e la spiegazione di ciò che un modello vede. La nostra panoramica sullo sviluppo software con AI generativa spiega come questi modelli vengono integrati nei prodotti.
Quanto costa lo sviluppo di software di riconoscimento immagini nel 2026?
Nel 2026 lo sviluppo di software di riconoscimento immagini costa circa 15.000–40.000 $ per un proof of concept basato su API, 60.000–120.000 $ per un MVP custom e 120.000–250.000 $ per un sistema di produzione con integrazioni, secondo stime di YuSMP Group basate su tariffe medie tra USA e UE. I programmi enterprise con più modelli o una flotta di dispositivi edge vanno oltre i 250.000 $.
| Perimetro | Budget (stima YuSMP, 2026) | Durata tipica | Cosa ottenete |
|---|---|---|---|
| Proof of concept basato su API | 15.000–40.000 $ | 4–6 settimane | Base di riferimento sulle vostre immagini, analisi dei costi degli errori, go/no-go e piano di sviluppo |
| MVP custom | 60.000–120.000 $ | 10–16 settimane | Modello perfezionato per le classi principali, API, schermata di revisione, un’integrazione |
| Sistema di produzione con integrazioni | 120.000–250.000 $ | 4–9 mesi in totale | Modelli consolidati, più integrazioni, monitoraggio, pipeline di riaddestramento, revisione di sicurezza |
| Enterprise, multi-modello o flotta edge | Oltre 250.000 $ | 9 mesi e oltre | Più attività di riconoscimento, rilascio edge su molti siti, governance e audit |
Per confronto, le guide di mercato pubblicate riportano una forbice simile: una guida 2026 di Biz4Group colloca le app di riconoscimento immagini con AI a circa 30.000–180.000 $ e oltre, a seconda della complessità. Le differenze tra le stime derivano di solito da ciò che è incluso — etichettatura dei dati, integrazioni e hardware edge restano spesso fuori dalla cifra principale.
Fattori di costo
- Dati ed etichettatura. Se esistono già immagini etichettate, quante classi le richiedono e quanto è complessa l’annotazione (tag o poligoni).
- Numero di classi e loro somiglianza. Dieci classi ben distinte costano meno di duecento varianti simili tra loro.
- Obiettivo di accuratezza. Ogni passo verso l’automazione senza revisione umana richiede più dati, più test e più lavoro sui casi limite.
- Destinazione di rilascio. Hardware edge, più siti e sincronizzazione offline aggiungono ingegneria e dispositivi.
- Integrazioni. Ogni sistema ERP, WMS, dei sinistri o mobile che il risultato deve raggiungere aggiunge settimane.
- Conformità. Dati biometrici, immagini mediche o decisioni regolamentate aggiungono flussi di consenso, documentazione, audit e lavoro di sicurezza.
Costi continui dopo il lancio
Pianificate i costi operativi fin dal primo giorno: inferenza (canoni delle API o hosting GPU), archiviazione di immagini e previsioni, etichettatura di nuovi campioni, riaddestramento periodico, monitoraggio e supporto. Secondo una stima YuSMP, questi aggiungono di solito il 15–25% del costo di sviluppo all’anno, di più se i volumi crescono in fretta o i prodotti cambiano spesso. Per una visione più ampia di come si compongono i budget software, consultate la nostra guida ai costi dello sviluppo software su misura.
Quanto tempo serve per costruire un software di riconoscimento immagini?
Un proof of concept richiede da quattro a otto settimane, un MVP custom da dieci a sedici settimane e un sistema di produzione con integrazioni da quattro a nove mesi in totale. La variabile più importante sono i dati: se le immagini devono ancora essere raccolte ed etichettate, aggiungete questo tempo prima che l’addestramento possa iniziare.
| Fase | Durata tipica | Output principale |
|---|---|---|
| Discovery e audit dei dati | 1–3 settimane | Descrizione del problema, costi degli errori, lacune nei dati, piano di etichettatura |
| Proof of concept | 4–8 settimane | Risultati di riferimento vs custom sulle vostre immagini, go/no-go |
| MVP | 10–16 settimane | Modello in un flusso di lavoro reale con schermata di revisione e un’integrazione |
| Consolidamento per la produzione | 4–9 mesi in totale dall’avvio | Integrazioni, monitoraggio, ciclo di riaddestramento, sicurezza e conformità |
| Esercizio | Continuo | Monitoraggio del drift, nuove classi, riaddestramento periodico |
Potete accorciare il percorso eseguendo l’etichettatura in parallelo alla base di riferimento con l’API, fissando presto le condizioni di acquisizione e limitando il primo rilascio alle classi che portano la maggior parte del valore.
Il team: chi serve per costruire un software di riconoscimento immagini?
Un progetto di riconoscimento immagini richiede competenze di machine learning, competenze sui dati e la normale ingegneria di prodotto, più qualcuno che conosca il dominio abbastanza bene da definire le classi e giudicare i casi limite. Un piccolo team pilota può contare tre o quattro persone; un programma di produzione richiede di solito sette ruoli o più.
- Ingegnere ML / computer vision — seleziona e addestra i modelli, esegue la valutazione, fissa le soglie.
- Data engineer — costruisce acquisizione, archiviazione, versionamento e pipeline delle immagini.
- Responsabile dell’annotazione e annotatori — scrivono le linee guida di etichettatura, etichettano e controllano la qualità.
- Ingegnere backend — costruisce l’API, la schermata di revisione e le integrazioni con i sistemi aziendali.
- Ingegnere MLOps / DevOps — rilascia nel cloud o sull’edge, monitora e automatizza il riaddestramento.
- Ingegnere QA — testa l’intero flusso di lavoro, incluse foto di cattiva qualità e percorsi di errore.
- Product owner ed esperto del dominio — definiscono la decisione, i costi degli errori e il significato di ogni classe.
Per un proof of concept bastano spesso un ingegnere ML, un ingegnere backend, un product owner a tempo parziale e il vostro esperto del dominio. Per la produzione aggiungete data engineering, MLOps e QA, e assicuratevi che l’esperto del dominio resti coinvolto: le definizioni delle etichette derivano quando nessuno ne è responsabile.
Privacy, sicurezza e conformità nel riconoscimento immagini
Il riconoscimento immagini è regolamentato soprattutto attraverso le immagini che elabora: le foto di persone identificabili sono dati personali e i modelli biometrici del volto sono dati biometrici, il che comporta regole severe nell’UE e in diversi stati USA. Progettate pensando alla privacy dal primo sprint, perché aggiungere a posteriori flussi di consenso e cancellazione dei dati è costoso. Questa sezione è una sintesi, non una consulenza legale.
Il GDPR nell’UE
Ai sensi del GDPR, qualsiasi immagine che mostra una persona identificabile è un dato personale: servono quindi una base giuridica, un periodo di conservazione e il rispetto dei diritti degli interessati. I dati biometrici trattati per identificare in modo univoco una persona, come i modelli biometrici del volto, sono dati di categoria particolare ai sensi dell’articolo 9 e il loro trattamento è in generale vietato salvo un’eccezione, di solito il consenso esplicito. Se le persone non servono all’attività, sfocatele o ritagliatele durante la pre-elaborazione.
Il BIPA dell’Illinois e le altre leggi biometriche USA
L’Illinois Biometric Information Privacy Act richiede un consenso scritto e informato prima di raccogliere la geometria del volto o altri identificatori biometrici, una policy pubblica di conservazione e distruzione e il divieto di vendere i dati. Le persone possono agire direttamente in giudizio, con risarcimenti forfettari di 1.000 $ per ogni violazione colposa e di 5.000 $ per ogni violazione intenzionale o sconsiderata; un emendamento del 2024 limita il risarcimento a uno per persona per metodo di raccolta. Anche Texas e Washington hanno leggi biometriche, quindi verificate ogni stato in cui si trovano i vostri utenti.
L’AI Act dell’UE
L’AI Act dell’UE vieta già alcune pratiche basate sulle immagini ai sensi dell’articolo 5, in vigore dal 2 febbraio 2025: la creazione di database di riconoscimento facciale tramite scraping non mirato di immagini facciali da internet o da telecamere a circuito chiuso, il riconoscimento delle emozioni sul luogo di lavoro e negli istituti di istruzione e la categorizzazione biometrica che deduce caratteristiche sensibili come razza, opinioni politiche o orientamento sessuale. L’identificazione biometrica remota in tempo reale negli spazi pubblici a fini di contrasto è consentita solo in casi limitati. Gli obblighi per i sistemi ad alto rischio elencati nell’allegato III, che includono molti usi biometrici, si applicano ora dal 2 dicembre 2027, dopo le modifiche del Digital Omnibus entrate in vigore il 27 luglio 2026; gli obblighi di trasparenza dell’articolo 50 restano invariati. La nostra checklist di conformità all’AI Act dell’UE elenca cosa preparare.
Controlli pratici
- Cifrate le immagini in transito e a riposo e tenete i dati di produzione nel vostro account cloud.
- Definite e applicate i periodi di conservazione; cancellate le immagini grezze che non vi servono più per l’addestramento o l’audit.
- Sfocate o ritagliate volti, targhe e schermi che l’attività non richiede.
- Limitate e registrate l’accesso a immagini, etichette e modelli.
- Tenete una model card per ogni modello: dati di addestramento, uso previsto, metriche per classe, limiti noti.
- Registrate il consenso quando sono coinvolti dati biometrici e fate sì che le richieste di cancellazione arrivino fino ai dataset di addestramento.
Errori comuni nei progetti di riconoscimento immagini
La maggior parte dei progetti di riconoscimento immagini che deludono fallisce sui dati e sul processo, non sul modello. I sette errori qui sotto sono quelli che vediamo più spesso, e ognuno ha una semplice contromisura.
- Addestrare su immagini di laboratorio e rilasciare su immagini reali. Foto pulite da studio non rappresentano lenti impolverate, riflessi e angolazioni strane. Raccogliete i dati di addestramento dalla configurazione di acquisizione reale.
- Nessun set di test reale tenuto da parte. Testare su immagini simili al set di addestramento gonfia i risultati. Tenete un set separato e intatto proveniente dalle condizioni reali.
- Inseguire l’accuratezza senza i costi degli errori. Un unico valore di accuratezza nasconde il compromesso tra mancati rilevamenti e falsi allarmi. Date un prezzo a entrambi e fissate le soglie di conseguenza.
- Ignorare i casi limite. Occlusioni, cambi di illuminazione, nuovi imballaggi e difetti rari mettono in crisi i modelli in produzione. Raccoglieteli di proposito.
- Nessun ciclo di riaddestramento. Prodotti, telecamere e stagioni cambiano. Senza monitoraggio e riaddestramento, l’accuratezza cala lentamente.
- Funzionalità sul volto senza revisione legale. Funzionalità biometriche progettate senza regole di consenso e conservazione possono bloccare un lancio o creare responsabilità.
- Lock-in su un’API senza un piano di uscita. Costruire l’intero flusso di lavoro sul set di etichette di un solo provider rende costoso cambiare. Conservate i vostri dati etichettati e un livello di astrazione.
Come scegliere un partner per servizi di sviluppo di software di riconoscimento immagini su misura
Scegliete un partner per servizi di sviluppo di software di riconoscimento immagini su misura verificando come gestisce i vostri dati, i vostri costi degli errori e la vostra destinazione di rilascio, non dalle demo che mostra. Ponete queste sette domande e pretendete risposte concrete e scritte:
- Di chi sono i dati, le etichette, i pesi del modello e il codice? Devono essere tutti vostri, e le vostre immagini non devono addestrare i modelli di nessun altro.
- Valuterete il modello sulle nostre immagini prima che estendiamo il contratto? Un buon partner propone un proof of concept a pagamento sui vostri dati con un set di test tenuto da parte.
- Quali sono i criteri di successo del proof of concept? Aspettatevi obiettivi di precision e recall per classe legati ai vostri costi degli errori, concordati prima dell’inizio dei lavori.
- Avete già rilasciato sulla nostra destinazione? Cloud, box edge, iOS o Android comportano vincoli diversi; chiedete un esempio.
- Qual è il piano di MLOps e riaddestramento? Monitoraggio, rilevamento del drift, etichettatura dei nuovi dati e frequenza di riaddestramento devono far parte della proposta.
- Come gestite privacy e conformità? Chiedete di GDPR, BIPA, AI Act dell’UE, residenza dei dati e di come vengono trattati volti e documenti d’identità.
- Possiamo parlare con un cliente di un settore simile? Le referenze in manifattura, retail, logistica o assicurazioni pesano più dei progetti AI generici.
In YuSMP Group avviamo la maggior parte dei progetti di riconoscimento proprio con questo tipo di pilota breve e misurabile sulle immagini del cliente, così la decisione di costruire si basa sui numeri e non su una demo.
Le tendenze del riconoscimento immagini nel 2026
Le principali tendenze del riconoscimento immagini nel 2026 sono i modelli visione-linguaggio, modelli edge più piccoli, i dati sintetici, la ricerca multimodale e la privacy by design spinta dalla regolamentazione. Gli analisti si aspettano una crescita continua: The Business Research Company stima il mercato del riconoscimento immagini con AI a 3,87 miliardi di $ nel 2026, rispetto ai 3,27 miliardi di $ del 2025, anche se le stime di mercato variano molto in base al perimetro.
- Modelli visione-linguaggio per il riconoscimento zero-shot e la pre-etichettatura. I VLM riconoscono nuove classi a partire da una descrizione testuale e preparano bozze di etichette per gli annotatori, accorciando la fase dei dati.
- Modelli edge più piccoli e veloci. Rilevatori e classificatori quantizzati girano ormai in tempo reale su telefoni e acceleratori a basso consumo, spostando più riconoscimento sul dispositivo.
- Dati sintetici. Immagini renderizzate e generate colmano le lacune per difetti rari e nuovi prodotti, convalidate rispetto a campioni reali.
- Ricerca multimodale ed embedding. Embedding condivisi tra immagini e testo permettono agli utenti di cercare nei cataloghi tramite foto, testo o entrambi.
- Privacy by design. La regolamentazione spinge i team verso l’elaborazione sul dispositivo, l’oscuramento automatico e modelli documentati.
FAQ
Che cos’è lo sviluppo di software di riconoscimento immagini?
Lo sviluppo di software di riconoscimento immagini è il processo con cui si costruisce un software che identifica ciò che compare in un’immagine, per esempio un prodotto, un difetto, un campo di un documento o una parte danneggiata di un’auto, e trasmette il risultato a un sistema aziendale. Comprende la raccolta e l’etichettatura dei dati, la scelta o l’addestramento di un modello, l’integrazione con app e sistemi di back office, il rilascio nel cloud o su un dispositivo edge e il monitoraggio dell’accuratezza dopo il lancio.
Quanto costa lo sviluppo di software di riconoscimento immagini su misura?
Nel 2026 YuSMP Group stima circa da 15.000 a 40.000 $ per un proof of concept basato su API, da 60.000 a 120.000 $ per un MVP custom e da 120.000 a 250.000 $ per un sistema di produzione con integrazioni. I programmi enterprise con più modelli o una flotta di dispositivi edge superano i 250.000 $. Mettete a budget un ulteriore 15-25% del costo di sviluppo all’anno per inferenza, riaddestramento, etichettatura e monitoraggio.
Quante immagini servono per addestrare un modello di riconoscimento immagini?
Con il transfer learning da un modello pre-addestrato, un proof of concept funziona spesso con qualche centinaio di immagini etichettate per classe. Un modello di produzione richiede di solito migliaia di immagini per classe, più esempi raccolti di proposito dei casi limite come scarsa illuminazione, occlusioni e difetti rari. Sono regole empiriche: il numero reale dipende da quanto si somigliano le classi e dall’obiettivo di accuratezza, quindi testate su un set separato di immagini reali raccolte sul campo.
Conviene usare Google Cloud Vision o Amazon Rekognition invece di costruire un modello custom?
Usate un’API gestita quando le vostre etichette sono generiche, come oggetti comuni, testo o volti, i volumi sono moderati e le immagini possono uscire dal vostro ambiente. Nel 2026 Google Cloud Vision costa 1,50 $ ogni 1.000 rilevamenti di etichette e Amazon Rekognition circa 0,001 $ per immagine nella prima fascia. Costruite un modello custom quando vi servono classi specifiche del vostro dominio, un’accuratezza più alta, un’elaborazione on-premise o offline oppure costi inferiori a volumi molto elevati.
Quanto tempo serve per sviluppare un software di riconoscimento immagini?
Discovery e audit dei dati richiedono da una a tre settimane, un proof of concept da quattro a otto settimane e un MVP custom da dieci a sedici settimane. Un sistema di produzione con integrazioni, monitoraggio e ciclo di riaddestramento richiede in genere da quattro a nove mesi in totale. La variabile principale sono i dati: se le immagini devono ancora essere raccolte ed etichettate, aggiungete diverse settimane prima che possa iniziare l’addestramento del modello.
Quanto è accurato il riconoscimento immagini nel 2026?
L’accuratezza dipende dall’attività, non solo dalla tecnologia. Le etichette generiche di oggetti fornite dalle API gestite sono affidabili su foto nitide, mentre le classi di nicchia, come difetti specifici o varianti di prodotto, richiedono un modello custom addestrato sulle vostre immagini. Misurate precision, recall e F1 per classe su immagini reali raccolte sul campo, fissate le soglie di confidenza in base al costo di ogni tipo di errore e inviate i risultati incerti alla revisione umana.
Il riconoscimento immagini può funzionare su uno smartphone o su un dispositivo edge senza cloud?
Sì. Modelli compatti convertiti in Core ML per iOS, in TensorFlow Lite o LiteRT per Android, oppure in ONNX Runtime e TensorRT per i computer edge possono classificare e rilevare oggetti in tempo reale senza connessione di rete. L’inferenza sul dispositivo riduce la latenza e il costo per immagine e mantiene le immagini in locale, ma limita le dimensioni del modello e richiede un processo per aggiornare i modelli su tutti i dispositivi.
Il riconoscimento facciale è legale nell’UE e negli USA?
Il riconoscimento facciale è legale in molti casi, ma fortemente regolamentato. Nell’UE i modelli biometrici del volto sono dati biometrici di categoria particolare ai sensi del GDPR, e dal 2 febbraio 2025 l’AI Act vieta lo scraping non mirato di immagini facciali e il riconoscimento delle emozioni sul luogo di lavoro e a scuola. Negli USA il BIPA dell’Illinois impone il consenso scritto e una policy di conservazione, con risarcimenti da 1.000 a 5.000 $ per violazione. Prima di costruire funzionalità sul volto, chiedete una revisione legale.
Pubblicato il 21 ottobre 2026. Fonti: prezzi di Google Cloud Vision API e prezzi di Amazon Rekognition (entrambi verificati a ottobre 2026); AI Act dell’UE, articolo 5 e regolamento (UE) 2024/1689; Gibson Dunn e Orrick sul Digital Omnibus sull’IA (luglio 2026); Illinois Biometric Information Privacy Act (740 ILCS 14); The Business Research Company, report sul mercato globale del riconoscimento immagini con AI; guida di Biz4Group allo sviluppo di app di riconoscimento immagini con AI (2026). Le fasce di costo, tempi, sforzo sui dati e costi operativi dei progetti, l’esempio di pareggio con le API e l’esempio sulle soglie sono stime di YuSMP Group. Questo articolo non costituisce consulenza legale.