Ir al contenido principal

Elasticsearch 8 OpenSearch Búsqueda vectorial GDPR

Servicios de Elasticsearch para búsqueda y analítica rápidas

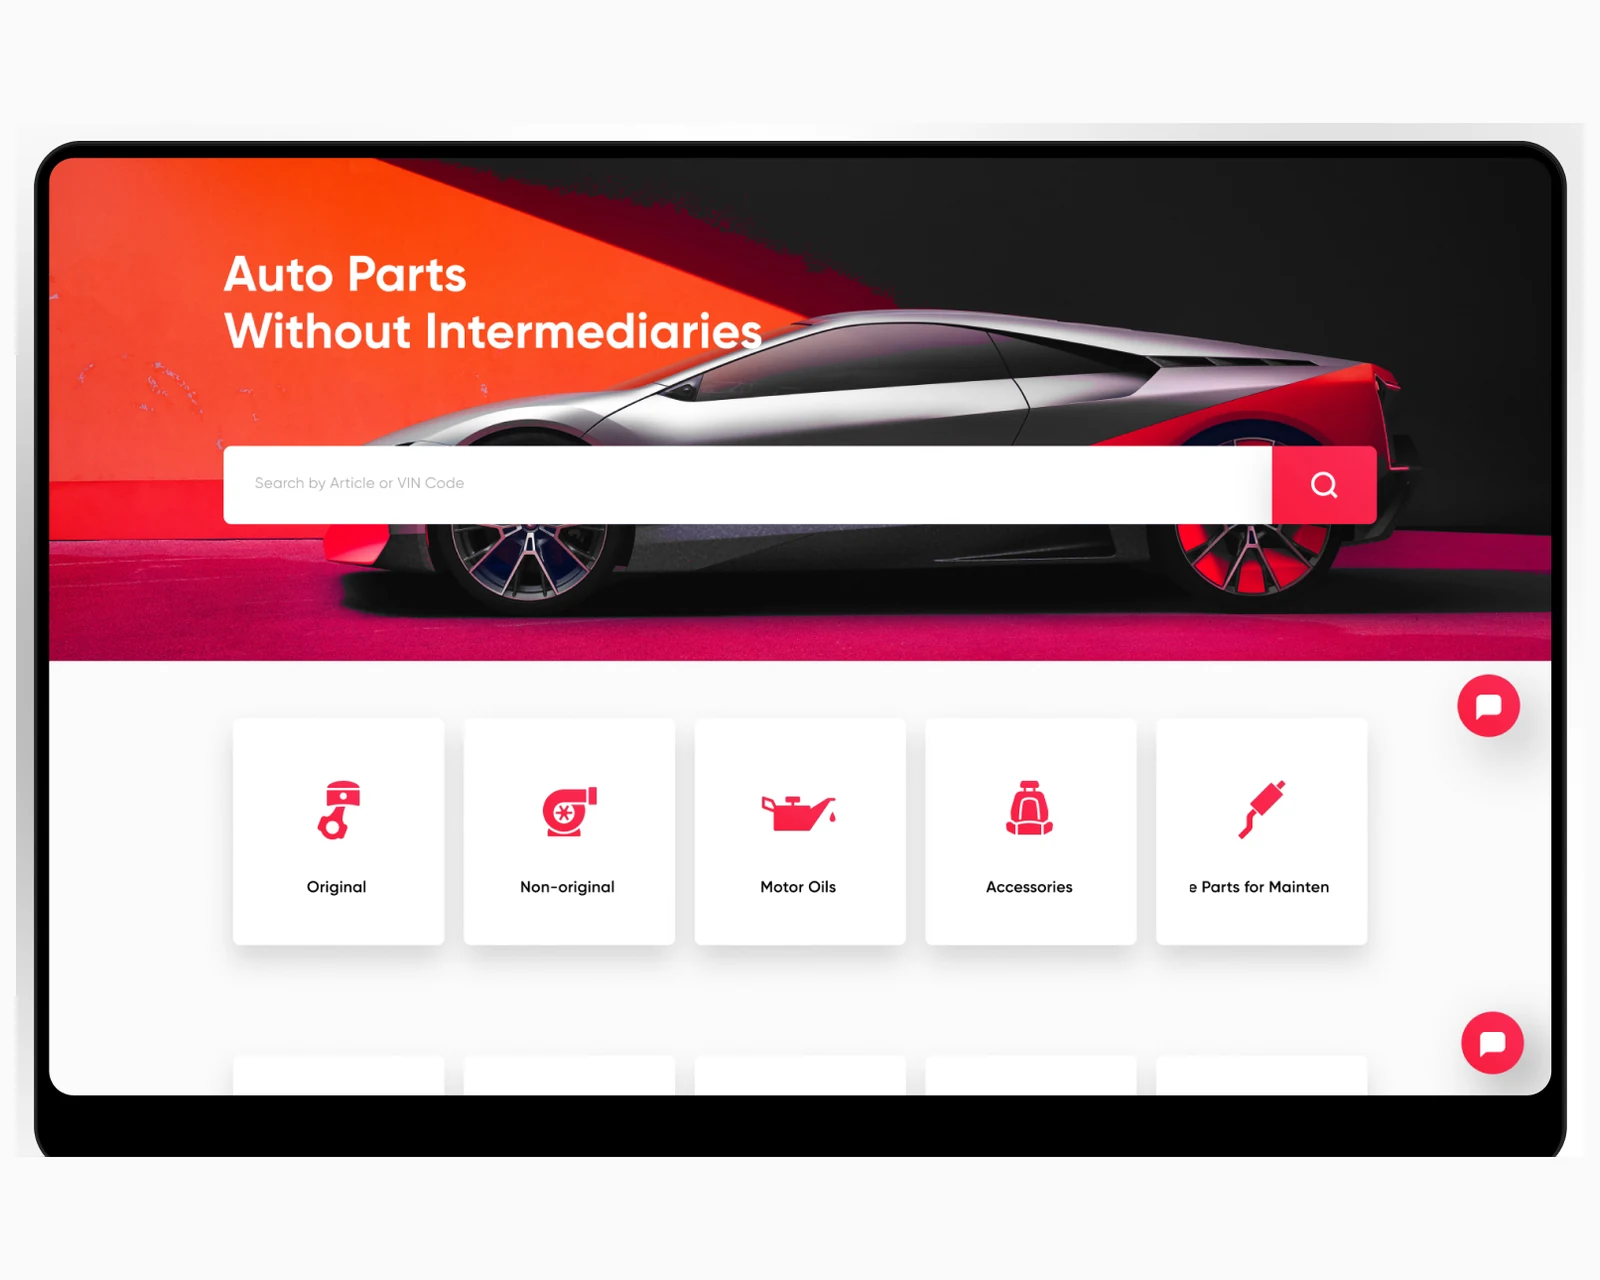
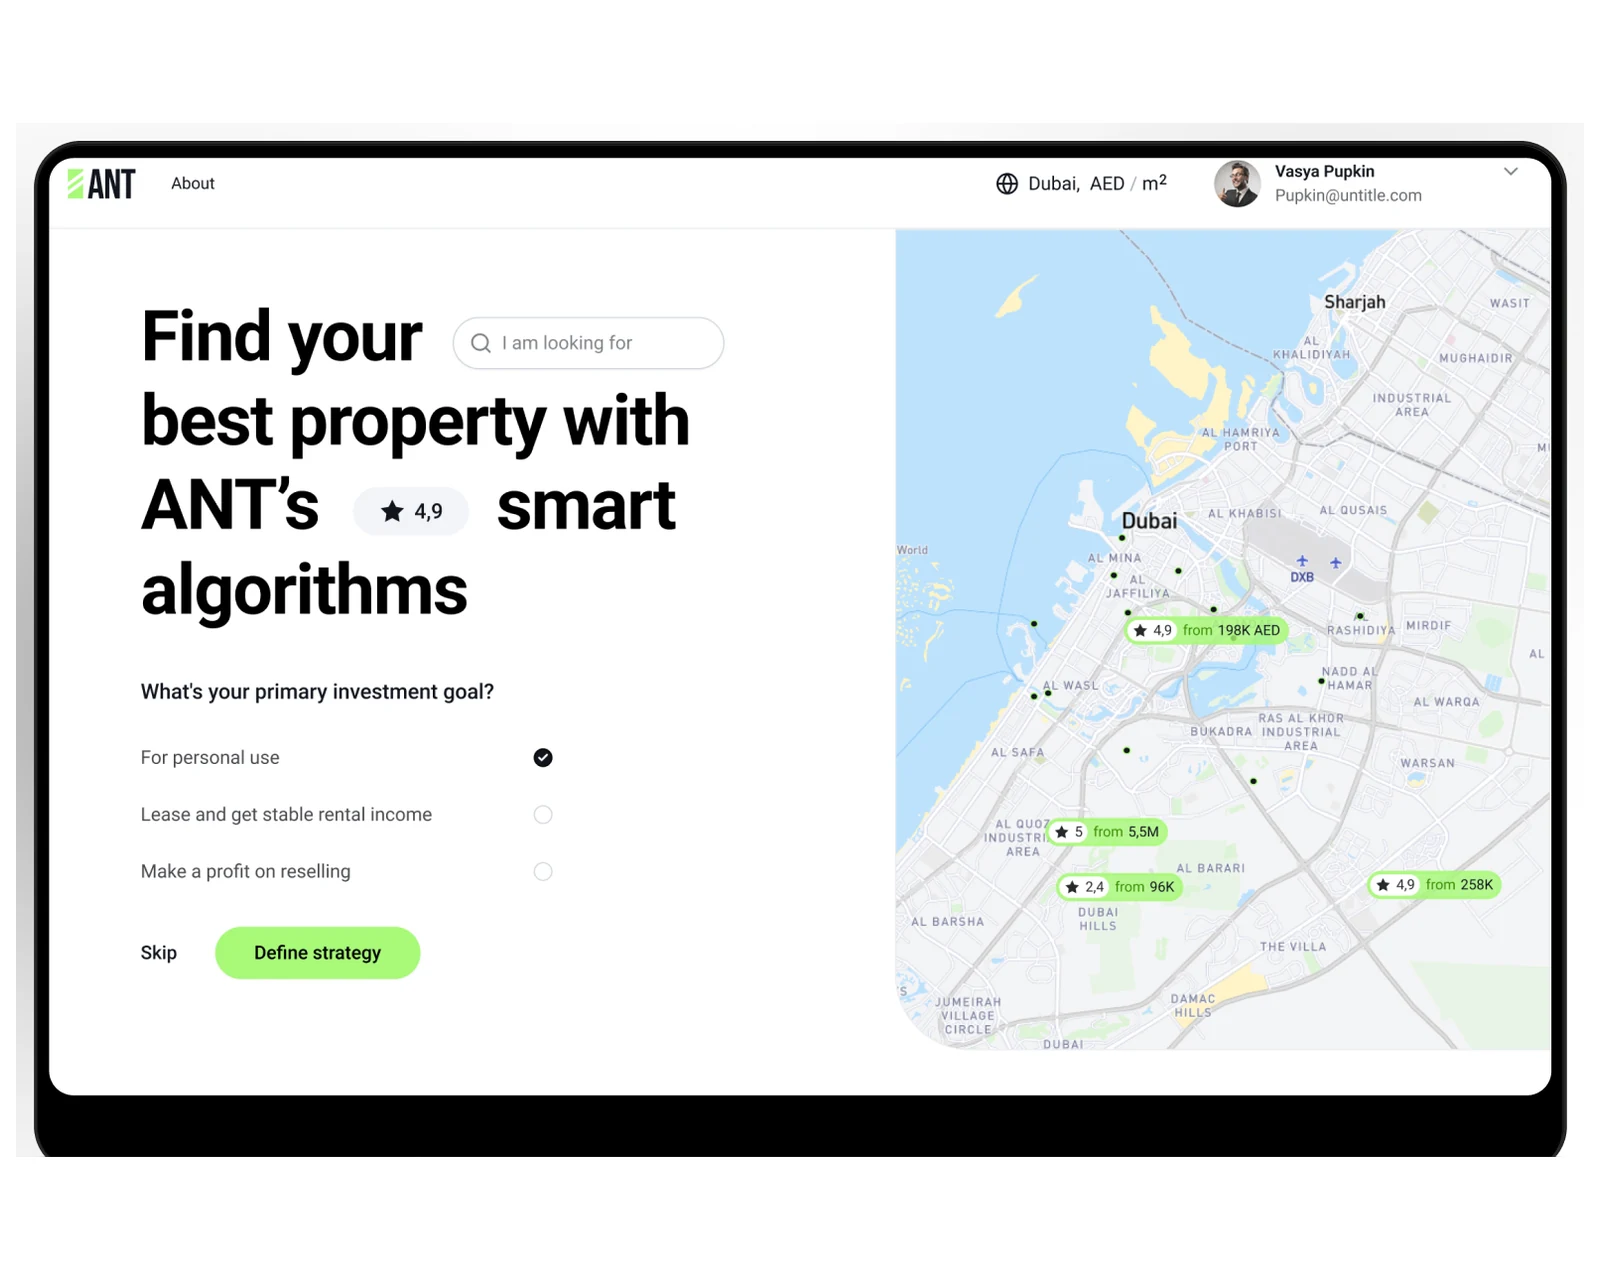
Elasticsearch impulsa la búsqueda en tres de nuestros sistemas de producción con más tráfico — el marketplace PropTech de ANT con búsqueda de inmuebles multilingüe y filtros geográficos, el portal B2B de REHAU con catálogo de productos sincronizado con SAP, la búsqueda de compatibilidad de AutoParts con inventario entre tiendas. Búsqueda por facetas, kNN vectorial, niveles de coste con ILM y reindexación sin tiempo de inactividad: todo es estándar en nuestros despliegues de Elasticsearch.

Pedir propuesta Ver casos de búsqueda

Ingeniería con Elasticsearch y OpenSearch para búsqueda de texto completo y de registros rápida

Entregamos ingeniería de Elasticsearch y OpenSearch para catálogos de productos y marketplaces que requieren búsqueda por facetas, portales B2B con inventario sincronizado con el ERP, plataformas de observabilidad que ingieren logs y métricas estructurados, y equipos de IA que añaden búsqueda híbrida BM25 + vectorial para la recuperación semántica. El diseño de mappings, la estrategia de shards, los niveles de coste con ILM y la reindexación sin tiempo de inactividad forman parte de cada proyecto.

Retos

Retos del sector que resolvemos

Explosión de mappings por campos dinámicos

Un mapping dinámico sin límite crea miles de campos, infla el estado del clúster y degrada el rendimiento. Mapeamos explícitamente todos los campos y desactivamos el mapping dinámico en los índices de ingesta.

Exceso de shards

Demasiados shards pequeños desperdician memoria heap y ralentizan la búsqueda. Apuntamos a 20–50GB por shard y usamos políticas de rollover de ILM para evitar la proliferación descontrolada de shards.

Recuentos de facetas inexactos tras filtrar

Las agregaciones de facetas posteriores a la consulta reflejan solo el conjunto de resultados filtrado, no todo el corpus. Implementamos post-filter para mantener exactos los recuentos de facetas.

Tiempo de inactividad en la reindexación

Los cambios de mapping en índices activos requieren reindexar, lo que bloquea el tráfico de producción si se hace de forma ingenua. Usamos alias de índice para reindexar sin tiempo de inactividad con la API de reindex.

Divergencia del índice respecto a la fuente de verdad

La doble escritura desde la aplicación pasa por alto fallos en silencio y diverge de PostgreSQL. Sustituimos la doble escritura por un pipeline de CDC con Debezium para garantizar la sincronización.

Crecimiento del coste de almacenamiento

Los índices de logs y de analítica crecen sin límite si no hay ILM. Implementamos niveles hot-warm-cold-delete con transiciones de fase automatizadas.

Soluciones

Soluciones que desarrollamos

Búsqueda por facetas en marketplaces

Análisis multilingüe, facetas, búsqueda geográfica, sincronización de inventario y ajuste de relevancia para catálogos de productos.

Búsqueda en catálogos B2B

Búsqueda de productos sincronizada con el ERP, con consulta por número de pieza, filtros de ACL multi-tenant y extracción de datos estructurados.

Búsqueda híbrida BM25 + vectorial

Búsqueda léxica y semántica combinadas con RRF para la recuperación en RAG y los sistemas de recomendación.

Analítica de logs y eventos

Pipelines de observabilidad que ingieren logs estructurados, trazas de APM y métricas, con paneles de Kibana y alertas.

Reindexación sin tiempo de inactividad

Estrategia de reindexación basada en alias para migraciones de mappings y cambios de analizadores sin interrumpir la búsqueda.

Optimización de costes con ILM

Niveles hot-warm-cold-delete, consolidación de shards y force-merge en índices de solo lectura para reducir los costes de almacenamiento.

Stack

Stack tecnológico

Elasticsearch 8, OpenSearch 2, Amazon OpenSearch Service, Kibana, OpenSearch Dashboards, Logstash, Beats, Debezium, ILM, búsqueda vectorial kNN, RRF, Terraform.

Cumplimiento

Cumplimiento y normativa

Alineado con el RGPD · apto para SOC 2 · apto para HIPAA · CCPA contemplada

UE

  • RGPD — residencia de datos a nivel de índice, derecho de supresión mediante delete-by-query.
  • ISO 27001 — control de acceso, registro de auditoría, cifrado en reposo.
  • NIS2 — retención de logs, respuesta a incidentes, pipelines de observabilidad.
  • DSA — trazas de auditoría de moderación de contenido, derechos de los interesados.

EE. UU.

  • SOC 2 — indexación de logs de auditoría, control de acceso, pipelines de monitorización.
  • HIPAA — enmascaramiento de información médica protegida (PHI), registro de accesos, cifrado en reposo y en tránsito.
  • CCPA — delete-by-query para las solicitudes de eliminación de datos de consumidores.
  • PCI DSS — exclusión de los datos de titulares de tarjetas de los índices de búsqueda, registro de auditoría.

Común: TLS + mTLS, ACL de índices basadas en roles, SBOM para las bibliotecas cliente.

Por qué YuSMP

Por qué los equipos de búsqueda eligen YuSMP

Disciplina de mappings primero

Diseñamos mappings explícitos antes de ingerir datos — sin explosión de campos dinámicos ni sorpresas de reindexación retroactiva.

ILM desde el primer día

Niveles hot-warm-cold configurados al montar el clúster — los costes de almacenamiento no le sorprenden tras 12 meses de crecimiento de los índices.

Búsqueda híbrida BM25 + vectorial

Implementamos pipelines combinados de BM25 y kNN con RRF — mejor relevancia que cualquiera de los dos enfoques por separado, ajustada a su corpus.

Preguntas frecuentes

Preguntas frecuentes sobre Elasticsearch

Elasticsearch u OpenSearch: ¿cuál recomiendan?

OpenSearch (la bifurcación de AWS) para equipos en AWS que quieren evitar la licencia propietaria de Elastic e integrarse estrechamente con Amazon OpenSearch Service. Elasticsearch para equipos que usan Elastic Cloud o el stack ELK, donde importan Kibana y la integración con APM. Ambos son compatibles a nivel de API en la mayoría de los casos de uso; diseñamos el código de la aplicación para que sea portable entre ellos.

¿Cómo diseñan los mappings de Elasticsearch para un catálogo de productos?

Separamos los campos keyword (filtros de coincidencia exacta, agregaciones) de los campos text (búsqueda de texto completo con análisis), usamos objetos nested para los atributos de variantes, definimos analizadores adecuados por idioma y creamos alias de índice para reindexar sin tiempo de inactividad. El diseño del mapping es la decisión individual con más impacto en la calidad de la búsqueda.

¿Cómo implementan la búsqueda por facetas?

Agregaciones de términos para facetas discretas (marca, categoría), agregaciones de rango para facetas numéricas (precio, valoración) y agregaciones nested para facetas que tienen en cuenta las variantes. Aplicamos post-filter tras la agregación para que los recuentos de facetas sean exactos para todo el conjunto de resultados y no solo para la selección de filtros actual.

¿Cómo gestionan Elasticsearch a escala de forma rentable?

ILM (Index Lifecycle Management) para escalonar los índices: hot (SSD), warm (HDD), cold (frozen) y delete, según la frecuencia de consulta y los requisitos de retención. Número de shards ajustado a ~20–50GB por shard. Índices rollup para agregaciones a largo plazo. Force-merge en índices cerrados. Auditamos el número de shards y el tamaño de los índices en cada proyecto.

Búsqueda vectorial en Elasticsearch: ¿cuándo es útil?

La búsqueda vectorial kNN en Elasticsearch 8+ u OpenSearch está lista para producción en búsqueda semántica, recomendación y aumento de la recuperación en RAG. La usamos junto con la búsqueda léxica BM25 en un pipeline híbrido con RRF (Reciprocal Rank Fusion) para obtener mejor relevancia que cualquiera de los dos enfoques por separado.

¿Cómo sincronizan Elasticsearch con una fuente de verdad en PostgreSQL?

CDC mediante un pipeline de Debezium Kafka Connect para una sincronización casi en tiempo real. Entrada JDBC de Logstash en Elasticsearch para la sincronización por lotes cuando Kafka supone una sobrecarga. Doble escritura desde la aplicación para casos sencillos en los que el riesgo de divergencia es aceptable. En sistemas regulados evitamos la doble escritura y preferimos el pipeline de CDC.

Cree una búsqueda rápida y escalable con ingenieros sénior de Elasticsearch

Respuesta en 1 día hábil. NDA a petición.

Pedir propuesta

Pedir propuesta

Cuéntenos algunos detalles y un consultor sénior le responderá en un día hábil.