Migración sin inactividad
Trasladamos las cargas de producción a AWS, Azure o GCP con patrones strangler y ejecuciones en paralelo. El cutover se hace en horario laboral, no a las 3 de la madrugada.

Servicios
YuSMP Group presta consultoría DevOps y de nube a equipos de producto e ingeniería de empresas medianas para migrar a AWS, Azure y GCP, y operarlos bien. Precios en USD de alcance cerrado y todo incluido: una auditoría de infraestructura desde $700, implementación llave en mano desde $1,800, DevOps gestionado desde $1,100 al mes o un ingeniero DevOps dedicado desde $100 por hora. Arquitectos cloud e ingenieros DevOps sénior se ocupan de la migración, Kubernetes, la infraestructura como código basada en Terraform, el CI/CD, el SRE y el FinOps bajo controles alineados con el RGPD, preparados para ISO 27001 y con SOC 2 Type II en curso. Propiedad intelectual transferida el primer día, sin recargo por intermediación y sin sobrecostes por herramientas. Entrega desde Ereván con solapamiento diario con la costa este de EE. UU., de 9:00 a 13:00 ET.
Neutral respecto a proveedores cloud · alineado con el RGPD · preparado para ISO 27001 · SOC 2 Type II en curso · apto para HIPAA · apto para el ámbito de PCI DSS · jornada CET con solapamiento de 9:00–13:00 ET
Entregamos proyectos de nube y DevOps de extremo a extremo: descubrimiento y arquitectura del estado objetivo, migración lift-and-shift o replatform a AWS, Azure o GCP, construcción de plataformas Kubernetes, pipelines con GitHub Actions y ArgoCD, entornos gestionados con Terraform, observabilidad con Prometheus/Grafana y Datadog, y SRE continuo. FinOps está integrado desde el primer día (etiquetado, rightsizing, savings plans y paneles de economía unitaria) para que el coste y la fiabilidad avancen juntos. Los ingenieros se incorporan a sus standups, programan en sus repositorios y entregan según los SLO que su negocio realmente usa. Véalo en la práctica en nuestro caso de éxito REHAU.
Trasladamos las cargas de producción a AWS, Azure o GCP con patrones strangler y ejecuciones en paralelo. El cutover se hace en horario laboral, no a las 3 de la madrugada.
Plataformas EKS, AKS y GKE con valores por defecto sensatos: GitOps, políticas de red, autoescalado y guardrails de costes. Rechazamos la complejidad que no tiene justificación de negocio. Para un proyecto de clústeres más profundo, consulte nuestra consultoría de Kubernetes dedicada.
Pipelines trunk-based en GitHub Actions o GitLab CI, artefactos firmados, SBOM, promoción automatizada y un camino del commit a producción en menos de quince minutos.
Recursos etiquetados, reparto de costes por equipo, savings plans y detección de recursos inactivos. Los clientes recortan habitualmente sus facturas entre un 20 y un 40 % en el primer trimestre.
Referencias CIS, mínimo privilegio en IAM, gestión de secretos y detección de amenazas en tiempo de ejecución. Controles de ISO 27001 y recopilación de evidencias de SOC 2 integrados en el pipeline.
Trazas de OpenTelemetry, logs estructurados, SLO y alertas con sentido. Las guardias dejan de ser un impuesto cuando por fin se puede ver el sistema.
¿Necesita un proyecto acotado en lugar de un programa de extremo a extremo? Cada línea siguiente es un servicio específico de YuSMP con su propio equipo sénior, su guía de entrega y su doble enfoque de cumplimiento para EE. UU. y la UE.
Evaluación, landing zones y migración por oleadas a AWS para cargas de trabajo de EE. UU. y la UE, con rollback ante el primer incumplimiento de SLO.
Migración a AWS →Traslados empresariales a Azure: identidad, redes y gobernanza diseñadas como módulos de Terraform y documentadas como ADR.
Migración a Azure →Cargas de trabajo intensivas en datos y aptas para ML en Google Cloud, con elecciones de región que respetan la residencia de datos de la UE y de EE. UU.
Consultoría de GCP →Plataformas EKS, AKS y GKE con GitOps, políticas de red, autoescalado y guardrails de costes: complejidad solo donde compensa.
Consultoría de Kubernetes →Evaluación de dos semanas de las cargas de trabajo, las dependencias, los costes, el cumplimiento y las capacidades del equipo, que termina en una arquitectura objetivo y un plan de migración.
Landing zones, topología de red, identidad, doble residencia de datos (UE y EE. UU.) y diseños de recuperación ante desastres, todo expresado como módulos de Terraform y ADR.
Cargas de trabajo migradas por oleadas, con feature flags y tráfico en sombra, despliegue con GitOps y rollback automático ante el primer incumplimiento de SLO.
Capacitación del equipo de plataforma, playbooks de guardia, revisiones mensuales de costes y fiabilidad y un backlog de mejoras de plataforma que su equipo puede asumir.
Para migraciones acotadas, configuraciones de landing zone y auditorías de FinOps con un alcance claro y una fecha objetivo.
Para trabajo continuo de plataforma donde las prioridades cambian cada semana. Squad sénior, demos semanales y capacidad revisada cada mes.
Un squad de ingeniería de plataforma de larga duración integrado en su organización, responsable de la fiabilidad, la seguridad y la experiencia del desarrollador.
Precios de alcance cerrado y todo incluido, presupuestados en USD y escalonados según cuánto quiera que asumamos. Sin recargo por intermediación, sin sobrecostes por herramientas y sin tarifas ocultas. Usted ve el presupuesto desglosado al final del descubrimiento y lo aprueba antes de que empiece cualquier trabajo; además, los costes de la nube corren por sus propias cuentas, de modo que conserva el control del coste.
Auditoría de infraestructura
desde $700
alcance cerrado · puntual
Una revisión de su parque cloud, CI/CD, seguridad y costes. Mapa de arquitectura y dependencias, principales riesgos y mejoras rápidas, una hoja de ruta de subsanación priorizada y un informe de desperdicio de FinOps.
Implementación llave en mano
desde $1,800
alcance cerrado · puntual
Configuración de extremo a extremo que usted conserva: landing zone en Terraform, pipeline de CI/CD, observabilidad, secretos y una línea base de seguridad, entregados como infraestructura como código versionada.
DevOps gestionado
desde $1,100
al mes · iguala
Operación continua de la plataforma: SRE y guardia, revisiones mensuales de FinOps y fiabilidad, y mantenimiento de pipelines e infraestructura según los SLO que su negocio realmente usa.
Ingeniero DevOps
desde $100
por hora · staff augmentation
Un ingeniero DevOps o de plataforma sénior integrado en su equipo bajo tiempo y materiales. Sin recargo por intermediación, con aumento o reducción según lo exija el trabajo.
Lo que mueve la cifra: el tamaño del parque, la mezcla de migración y refactor, la profundidad del cumplimiento (RGPD, ámbito de PCI DSS, salvaguardas de HIPAA, residencia de datos en la UE) y cuánto tiempo mantenga la iguala gestionada. El gasto en la nube, en GPU y en herramientas de terceros corre por sus propias cuentas, de modo que usted conserva el control del coste. Los precios son orientativos y se fijan en un presupuesto escrito para su alcance concreto.

B2B e-commerce y configurador de producto para un fabricante mundial de polímeros, con precios por región, stock y flujos de trabajo para distribuidores.
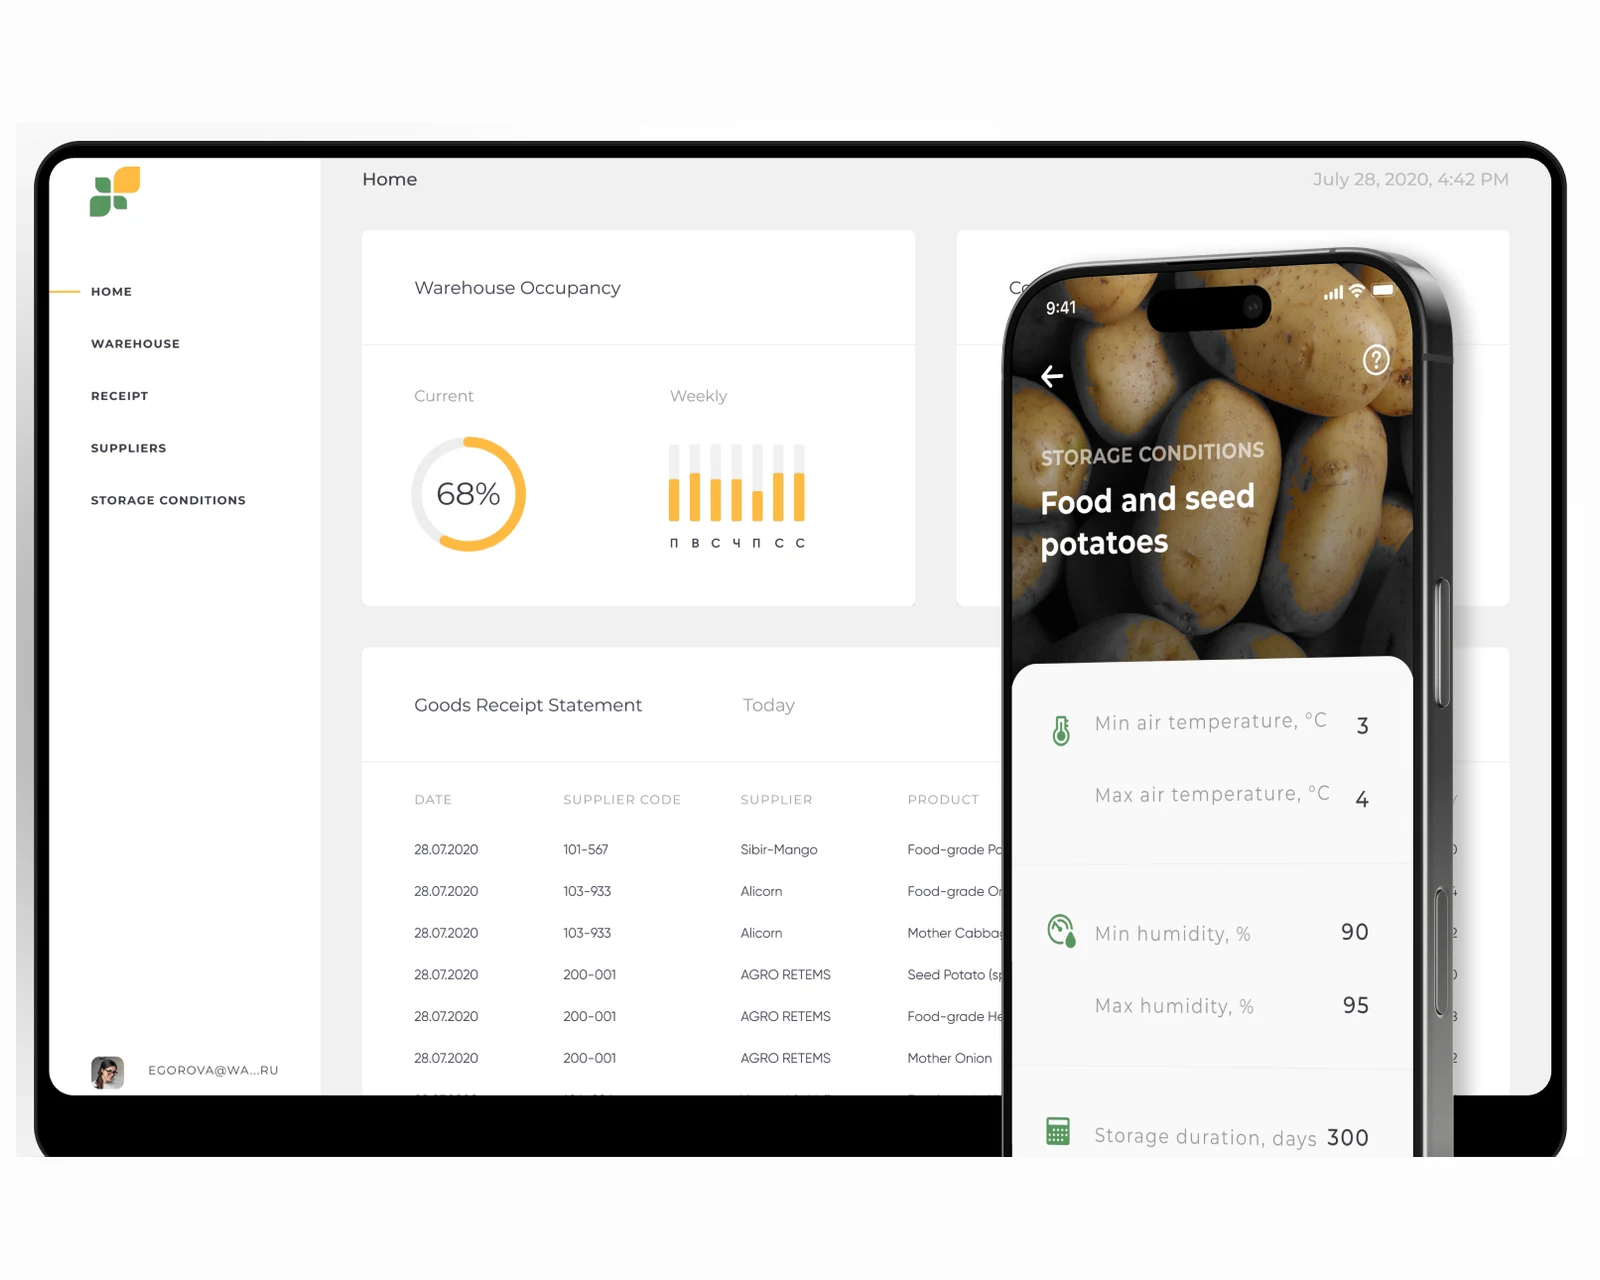
Sistema de gestión de almacenes con paneles web y escáneres móviles: productividad multiplicada por 2×, errores reducidos un 78 %, listo para EE. UU. y la UE.
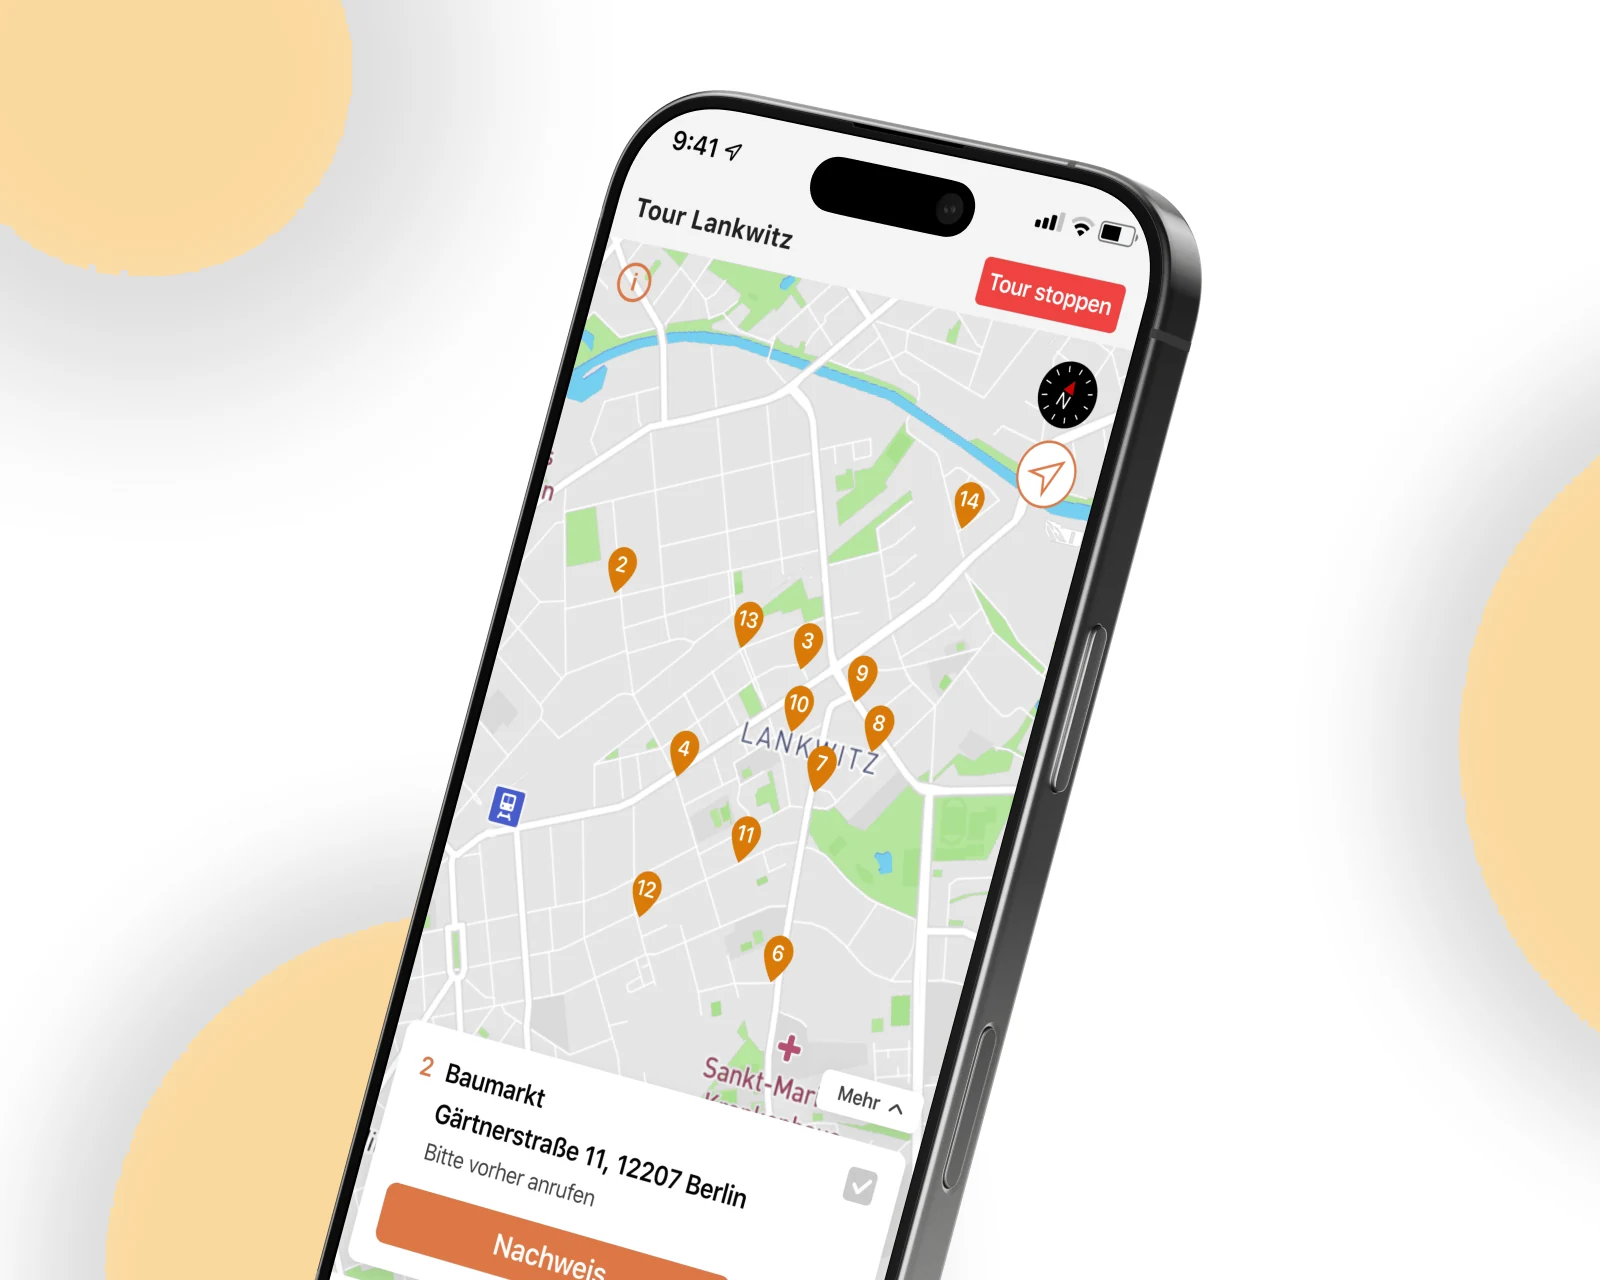
Refactorización y reconstrucción en Android e iOS para un operador alemán de logística de última milla: planificación de rutas multipunto, seguimiento de conductores en tiempo real y facturación en la app, en producción en la UE.
La fiabilidad, el coste y la residencia de datos significan cosas distintas en cada sector. Combinamos la ingeniería de plataformas con el cumplimiento específico de cada sector en los mercados de EE. UU. y la UE.
Las plataformas financieras exigen landing zones conformes con PCI DSS, segmentación de red entre los entornos con datos de titulares de tarjeta y sin ellos, y evidencias de lanzamiento inmutables que su QSA pueda auditar.
Construimos pipelines de tokenización, jerarquías de gestión de claves y capas de WAF más DDoS que satisfacen a los adquirentes, a los programas de seguridad de los esquemas de tarjetas y a los requisitos SCA de PSD2 de la UE sin añadir latencia a los flujos de pago.
Los datos de pacientes y clínicos conllevan las mayores obligaciones de residencia y control de acceso en la nube. Configuramos entornos aptos para HIPAA con BAA, almacenes de datos solo en la UE para los datos de categoría especial del artículo 9 del RGPD y pistas de auditoría que satisfacen tanto a la OCR como a las autoridades de supervisión.
El trabajo típico incluye backends de API HL7 FHIR, pipelines de desidentificación, acceso a información médica protegida (PHI) basado en roles con registro de emergencia (break-glass) y estrategias de DR probadas según umbrales de RPO/RTO que su equipo de cumplimiento pueda aprobar.
La nube del retail vive y muere por dos cifras: el coste por pedido en régimen estable y el tiempo de carga de página en los picos. Diseñamos grupos de autoescalado que absorben los picos del Black Friday, estrategias de CDN multirregión para una entrega de activos inferior a 100 ms y guardrails de FinOps que detectan las regresiones del coste unitario antes de que se acumulen.
Más allá de la preparación para los picos, nos ocupamos de patrones de integración de PIM/OMS/ERP, del alcance SAQ-D de PCI DSS para los flujos de pago y de pipelines de despliegue sin inactividad que permiten a los equipos de merchandising publicar a diario sin ventana de mantenimiento.
Los sistemas de despacho, enrutamiento y seguimiento son dirigidos por eventos por naturaleza: un mensaje de Kafka perdido o una Lambda en arranque en frío se traduce directamente en una entrega retrasada o en un conductor sin asignación. Construimos pipelines de eventos de baja latencia y alto rendimiento sobre servicios de streaming gestionados y los respaldamos con prácticas de SRE que tratan la latencia P99 como un SLO de primer nivel.
Los requisitos de cobertura geográfica nos llevan hacia arquitecturas multirregión activo-activo. Dimensionamos, ubicamos y conectamos las regiones con patrones de hash consistente y elección de líder que mantienen el enrutamiento caliente incluso cuando una AZ de la nube se cae.
El SaaS multi-tenant tiene un problema cloud singular: un vecino ruidoso en una infraestructura compartida puede incumplir el SLA de todos los demás tenants. Diseñamos el aislamiento de tenants en las capas de cómputo, almacenamiento y red (modelos silo, pool y bridge), calibrado con la estructura de niveles de precios y con su enfoque de cumplimiento frente a los compradores empresariales.
A medida que la plataforma escala, el coste por tenant se convierte en la métrica que determina si el modelo de negocio funciona. Nuestra práctica de FinOps sigue el coste a nivel de tenant, modela las asignaciones de savings plans entre familias de cuentas y señala las anomalías antes de que lleguen a la factura.
El vídeo en streaming, las aulas en directo y la entrega de grandes archivos comparten un requisito común: salida de datos de alto rendimiento a bajo coste. Diseñamos pipelines de medios con transcodificación gestionada, entrega con bitrate adaptativo y enrutamiento de CDN regional que mantiene los ratios de buffering por debajo del 0.5 % incluso en picos de carga síncronos como clases en directo o lanzamientos de producto.
Las restricciones de COPPA y FERPA sobre los datos de los alumnos requieren aislamiento a nivel de tenant y flujos de datos conscientes del consentimiento, distintos de los patrones generales de consumo del RGPD. Configuramos la residencia de datos, los calendarios de retención y la propagación del consentimiento como controles de infraestructura y no como añadidos de última hora en la capa de aplicación.
Alineados con el RGPD · preparados para ISO 27001 · SOC 2 Type II en curso · aptos para HIPAA · CCPA contemplada
SRE con jornada CET y solapamiento con la costa este de EE. UU. (9:00–13:00 ET), presentes en su puente de incidentes, con Slack compartido y calendarios de guardia compartidos.
Todos los responsables cloud han operado plataformas en producción. No ponemos a prueba Kubernetes por primera vez en su clúster.
Regiones de la UE / claves de la UE / soporte de la UE para los clientes de la UE; regiones de EE. UU. / claves KMS solo de EE. UU. / soporte de EE. UU. para los clientes de EE. UU. bajo petición. Controles de ISO 27001 integrados, SOC 2 Type II en curso, delimitación de PCI DSS para parques fintech y apto para HIPAA en cargas de salud.
En las plataformas de pago operamos dentro del ámbito de PCI DSS, trabajamos con su QSA en la segmentación, la gestión de claves y el registro, y documentamos las evidencias como parte de cada lanzamiento.
Agregar precios en vivo de varios exchanges manteniendo la latencia por debajo de 500 ms es ingeniería realmente difícil. YuSMP integró el feed multi-exchange, los gráficos de tokens en tiempo real y el flujo de listados en una plataforma coherente. No hemos sufrido ninguna caída desde el lanzamiento.
El control de procesos en un entorno de reactores no puede permitirse cortes de conectividad. YuSMP entregó un MES offline-first que registra cada paso de forma fiable y se sincroniza con el servidor central sin pérdida de datos. La preparación para auditorías, que antes llevaba días, ahora lleva minutos.
Todo despliegue cloud regulado empieza con la landing zone adecuada y termina con evidencias documentadas. Así abordamos los cuatro marcos que más se encuentran nuestros clientes.
Desplegamos las cargas de trabajo de la UE únicamente dentro de regiones de la UE (AWS eu-central-1/eu-west-1, Azure West/North Europe, GCP europe-west) con claves KMS gestionadas por el cliente que nunca salen del almacén de claves de la UE. Los acuerdos de subencargado están firmados de antemano con AWS, Azure y GCP conforme al artículo 28 del RGPD. Las cláusulas contractuales tipo y un acuerdo de encargo del tratamiento (DPA) se incluyen en nuestro contrato marco de servicios sin coste adicional.
Para los flujos de datos transatlánticos (almacenes de analítica, herramientas de soporte) aplicamos el cumplimiento del EU-US Data Privacy Framework y patrones de minimización de datos, y documentamos cada transferencia de responsable a encargado en un registro de flujos de datos que su delegado de protección de datos (DPO) puede usar en la auditoría.
HIPAA no certifica nubes; certifica controles. Acotamos cada carga de datos de salud mediante un Business Associate Agreement con el proveedor cloud, configuramos el cifrado de PHI en reposo (AES-256) y en tránsito (TLS 1.2+), activamos CloudTrail/Azure Monitor/Cloud Audit Logs para el registro de accesos y aplicamos IAM de mínimo privilegio en todos los servicios que tocan datos protegidos.
Los BAA con YuSMP están disponibles para los clientes del sector sanitario. Nuestro entorno de salud estándar incluye pipelines de desidentificación conformes con los métodos Safe Harbor (45 CFR §164.514(b)) y Expert Determination, aislamiento VPC para los almacenes de PHI y procedimientos de emergencia (break-glass) con plazos obligatorios de notificación de incidentes alineados con la Breach Notification Rule.
Acotamos los entornos cloud a la superficie mínima de PCI DSS mediante la segmentación de red entre el entorno de datos de titulares de tarjeta (CDE) y las zonas fuera de alcance. El CDE funciona en subredes dedicadas con WAF, IDS/IPS, grupos de seguridad restrictivos y tránsito cifrado, generando las evidencias de registro que su QSA necesita para los requisitos 10 y 11.
Trabajamos con el alcance SAQ-A, SAQ-A-EP y SAQ-D según la cantidad de datos de tarjeta que gestione su plataforma. Para comercios completos, ayudamos con la preparación de pruebas de penetración, los análisis de vulnerabilidades automatizados y el seguimiento de la subsanación con la cadencia que exige su evaluación anual.
Las auditorías de SOC 2 Type II evalúan los controles a lo largo de una ventana de observación de 6 a 12 meses. Ayudamos a las empresas de SaaS a instrumentar esos controles desde el primer día: controles de gestión de accesos (CC6), gestión de cambios (CC8), disponibilidad (A1) y confidencialidad (C1) asignados a sus criterios de servicios de confianza concretos y evidenciados mediante policy-as-code automatizado en lugar de capturas de pantalla manuales.
El trabajo de ISO 27001 abarca la implantación de los controles del Anexo A, la redacción de la Declaración de Aplicabilidad, la documentación del SGSI y el apoyo a la auditoría interna. Nuestra línea base alineada con ISO 27001 se aplica por defecto a cada entorno cloud de cliente, lo que significa que las empresas que buscan la certificación parten de una línea base mucho más alta que las implantaciones desde cero.
Los precios son de alcance cerrado y todo incluido, presupuestados en USD. Una auditoría de infraestructura parte de $700; una implementación llave en mano de CI/CD y nube, desde $1,800; DevOps gestionado, desde $1,100 al mes; y un ingeniero DevOps dedicado mediante ampliación de equipos (staff augmentation), desde $100 por hora. La cifra exacta depende del tamaño del parque, de la mezcla de migración y refactor, del alcance de cumplimiento y de cuánto tiempo mantenga la iguala gestionada. Usted ve el presupuesto desglosado al final del descubrimiento y lo aprueba antes de que empiece cualquier trabajo. No hay recargo por intermediación ni sobrecostes por herramientas, y los costes de la nube corren por sus propias cuentas, de modo que conserva el control del coste.
Elegimos según la carga de trabajo, la disponibilidad de regiones (UE y EE. UU.), las competencias existentes y el coste total de propiedad a tres años. El SaaS de la UE suele acabar en AWS Fráncfort o Azure West Europe; las cargas de EE. UU. van a AWS us-east-1/us-west-2 o Azure East US; el ML intensivo en datos suele ir a GCP. No vamos a empujar un logotipo preferido.
Un lift-and-shift de un SaaS de tamaño medio se completa en tres a cuatro meses. Un re-platform a Kubernetes con CI/CD, observabilidad e IaC reconstruidos suele llevar de seis a nueve meses, incluido un periodo de ejecución en paralelo.
Sí. Una auditoría de FinOps lleva de dos a tres semanas y suele descubrir entre un 20 y un 40 % de desperdicio mediante rightsizing, savings plans, niveles de almacenamiento y retirada de cargas inactivas. Compartimos el playbook para que los ahorros se mantengan.
No. Kubernetes es excelente cuando se necesita aislamiento entre varios equipos, redes complejas o cargas de trabajo políglotas. Para parques más pequeños, ECS, App Service, Cloud Run o incluso PaaS gestionado siguen siendo más baratos y más sencillos. Recomendamos la herramienta más pequeña que encaje.
Por defecto usamos regiones de la UE para los clientes de la UE (RGPD + residencia de datos, claves KMS solo de la UE, contratos de soporte en la UE, nodos de CDN de la UE); desplegamos en regiones de EE. UU. con claves KMS solo de EE. UU. para los clientes de EE. UU. (SOC 2 + CCPA + HIPAA cuando se requiera), con soporte residente en EE. UU. y nodos de CDN de EE. UU. Cuando los servicios transatlánticos son inevitables, aplicamos el DPF, las SCC y patrones de minimización de datos, y documentamos la decisión. Para una lista de verificación completa y los rangos de tarifas en la UE, consulte nuestra guía para elegir consultores europeos de DevOps.
GitOps trata su repositorio Git como única fuente de verdad del estado de la infraestructura y de las aplicaciones: un push a main activa un bucle de reconciliación (Argo CD o Flux) que alinea el clúster con el estado declarado en el repositorio. Las ventajas son la auditabilidad total de cada cambio, el rollback instantáneo mediante un git revert y la detección de desviaciones, que alerta cuando alguien aplica un parche manual con kubectl. Recomendamos GitOps a los equipos que operan Kubernetes y quieren una gobernanza de cambios sólida sin un proceso ITSM pesado. En parques más pequeños sobre ECS o App Service, un modelo convencional de CI/CD con push suele ser más sencillo y suficiente.
La técnica depende de la arquitectura. Para los servicios sin estado usamos actualizaciones progresivas con surge y max-unavailable configurables, o despliegues blue-green en los que el balanceador de carga cambia de destino tras una puerta de pruebas de humo. Las versiones canary, gestionadas con Argo Rollouts o una capa de feature flags, dirigen un pequeño porcentaje del tráfico a la nueva versión y hacen rollback automático si se supera la tasa de errores. Los cambios de esquema de la base de datos son lo más difícil: aplicamos patrones de migración expand-contract para que el código antiguo y el nuevo funcionen con el esquema durante la ventana de transición, lo que elimina la necesidad de una página de mantenimiento.
Nuestra iguala gestionada incluye un SLO de disponibilidad de la plataforma del 99.9 % (medido en el health check del balanceador de carga, no en la página de estado del proveedor cloud), un SLA de 15 minutos para el acuse de recibo de incidentes P1 y un SLA de cuatro horas para la resolución de incidentes P1. Los incidentes P2 (servicio degradado, no caído) se reconocen en una hora y se resuelven en 24 horas. Los SLO se revisan cada trimestre y se ajustan a las necesidades reales de fiabilidad de su producto; no vendemos una cifra genérica de «cinco nueves» sin entender antes su tráfico y sus modos de fallo.
Sí, y es una de las formas de colaboración más habituales. Normalmente ampliamos un equipo interno de una de estas tres maneras: construcción de plataforma (diseñamos e implementamos la capa de plataforma mientras su equipo se encarga de los pipelines de aplicación), capacidad especializada (aportamos profundidad en Kubernetes, FinOps o seguridad que su equipo no tiene internamente) o ampliación de capacidad (asumimos la rotación de guardia para extender la cobertura a 24/7 sin quemar a sus ingenieros). En todos los casos trabajamos en su Jira, su Slack y sus runbooks, y documentamos todo para que el conocimiento se quede con su equipo.
Empezamos con un análisis de impacto en el negocio: ¿cuánto cuesta una hora de inactividad frente a lo que cuesta lograr un RTO de una hora? Ese cálculo suele revelar que la mayoría de los productos SaaS pequeños necesitan una estrategia warm-standby (RTO de 30–60 min, RPO de 5–15 min) y no una configuración multirregión activo-activo, que cuesta de tres a cinco veces más de operar. Documentamos los procedimientos de recuperación, los probamos cada trimestre con ejercicios de game day y medimos el RTO real frente al objetivo en lugar de dar por hecho que el runbook funciona. En las cargas reguladas (financieras, de salud) alineamos la cadencia y las evidencias de las pruebas de DR con el requisito del marco (SOC 2 A1.3, plan de contingencia de HIPAA), de modo que las pruebas sirvan además como evidencia de auditoría.
Guías prácticas sobre infraestructura cloud, prácticas de DevOps y arquitectura de sistemas.
Cuéntenos algunos detalles y un consultor sénior le responderá en un día hábil.