Un squad real, no una bolsa de perfiles
Los mismos ingenieros en cada sprint. Aprenden su código, sus clientes y sus reglas de negocio, y permanecen el tiempo suficiente para que ese conocimiento se acumule.

Servicios
Contrate un equipo de desarrollo dedicado que entrega según su hoja de ruta, no la nuestra. YuSMP Group aporta ingenieros sénior ya validados desde Ereván, con jornada CET y un solapamiento garantizado de 9:00 a 13:00 ET para las dailies de la costa este de EE. UU. Precio mensual cerrado y todo incluido en USD por puesto nominal: equipo Mini desde $6,900 / mes, equipo Standard desde $13,800 / mes, equipo Product desde $27,600 / mes, sin recargo de selección y con la propiedad intelectual transferida el primer día. Las colaboraciones están alineadas con el RGPD y listas para ISO 27001, con entrega preparada para HIPAA en productos regulados.
Alineado con el RGPD · preparado para ISO 27001 · SOC 2 Type II en curso · apto para HIPAA · CCPA contemplada · jornada CET con solapamiento de 9:00–13:00 ET
Un equipo de desarrollo dedicado es un squad exclusivo y de larga duración (ingenieros full-stack, QA, DevOps y un delivery lead) que trabaja sobre su backlog y sus prioridades. Validamos cada incorporación con un proceso de cuatro fases: revisión del CV, dos entrevistas técnicas sobre su stack, una prueba práctica remunerada y una comprobación de encaje cultural antes de la asignación. Usted ve el mismo equipo mes tras mes, con facturas mensuales transparentes, puestos nominales y una política de sustitución sin preguntas. La antigüedad media de nuestros más de 80 ingenieros sénior supera los tres años, lo que mantiene el conocimiento del producto dentro de su equipo. Si lo que necesita es incorporar a un especialista en un squad existente, nuestro modelo de ampliación de equipos (staff augmentation) lo resuelve; y para validar primero un producto nuevo, consulte el desarrollo de MVP. Todas las colaboraciones se apoyan en nuestro modelo de entrega nearshore. Véalo en la práctica en el caso de éxito Building JoyJet.
Los mismos ingenieros en cada sprint. Aprenden su código, sus clientes y sus reglas de negocio, y permanecen el tiempo suficiente para que ese conocimiento se acumule.
Un squad típico está operativo en cuatro a seis semanas. Nosotros asumimos el coste y el riesgo de la selección; usted empieza a entregar mientras su proceso interno de contratación se pone al día.
Ingenieros con contrato en la UE, equipos con restricción de región, residencia de datos en la UE · opciones en EE. UU. bajo petición. DPA bajo petición, conformidad con la CCPA, preparación para HIPAA y plena alineación con sus obligaciones de ISO 27001 y SOC 2 Type II (en curso).
Informes semanales de velocidad, tableros de Jira compartidos y rotaciones de guardia conjuntas. Siempre sabe quién trabaja en qué y por qué.
Incorpore a un ingeniero backend sénior en tres semanas y reduzca el equipo con treinta días de preaviso. El equipo se adapta a su hoja de ruta, y no al revés.
Cada equipo dedicado incluye un EM que dirige la entrega, la mentoría y la retención. Su CTO gana capacidad de palanca, no un reporte directo más.
Analizamos su producto, su stack y los rituales de su equipo, y acordamos la forma del squad, la combinación de seniority y las métricas de éxito en un kickoff de una semana.
Definimos los itinerarios de incorporación, los accesos a repositorios, el modelo de seguridad y la definición de «hecho» para que los ingenieros entreguen tickets reales desde la primera semana.
El squad se integra en sus sprints, su CI y sus guardias. Medimos el cycle time y la calidad, y ajustamos la composición cada trimestre.
Las revisiones trimestrales de negocio, los planes de retención y la alineación con la hoja de ruta mantienen al equipo productivo y en sintonía con la evolución de su estrategia de producto.
Para líneas de trabajo acotadas dentro de un equipo dedicado, como una migración o un módulo regulado con fecha límite.
Modelo por defecto. Facturación mensual por rol y seniority, con total visibilidad de horas, capacidad y resultados.
Un squad de larga duración que usted trata como propio. Nosotros nos encargamos de la selección, la retención y los asuntos de RR. HH.; usted es dueño del producto, las prioridades y el código.
La mayoría de los proveedores se reserva la tarifa para una llamada comercial. A continuación figuran formatos mensuales de referencia para distintos tamaños de squad; el presupuesto exacto lo fijamos tras una evaluación de alcance gratuita. Cada puesto es una cuota mensual fija con todos los costes incluidos (salario, impuestos, equipamiento, vacaciones, gestión y gastos generales en una única partida), expresada en USD, sin recargo de selección, sin sobrecoste por herramientas y sin tamaño mínimo de equipo más allá de un solo ingeniero. Verá el presupuesto desglosado antes de escribir una sola línea de código y lo aprobará.
Equipo Mini
desde $6,900
/ mes · 2–3 puestos
Un squad enfocado que trabaja sobre su backlog: un ingeniero sénior, un QA y un delivery lead compartido. Cuota mensual fija, todo incluido por puesto nominal, operativo en cuatro a seis semanas.
Equipo Standard
desde $13,800
/ mes · 4–5 puestos
Un squad multidisciplinar (ingenieros full-stack, QA y un delivery lead) que lleva un producto desde el descubrimiento hasta versiones listas para publicar. Propiedad intelectual transferida el primer día.
Equipo Product
desde $27,600
/ mes · 6+ puestos
Un equipo multirrol de larga duración que se hace cargo de una plataforma en producción: engineering manager incluido, revisiones trimestrales y capacidad de ampliarse o reducirse según avance la hoja de ruta. Usted es dueño del producto, las prioridades y el código.
Lo que mueve la cifra: la combinación de seniority (solo incorporamos perfiles sénior, por lo que los puestos cuestan más que una bolsa mixta con perfiles júnior, pero entregan desde la primera semana); el tamaño y la forma del squad (incorpore a un ingeniero backend sénior en tres semanas y reduzca con treinta días de preaviso); el modelo de colaboración (por defecto, un equipo dedicado con facturación mensual continua; para una migración o un módulo regulado con fecha límite, una fase acotada de alcance cerrado); el alcance de cumplimiento (los squads de pagos trabajan dentro del ámbito de PCI DSS y se alinean con su QSA, los de salud están preparados para HIPAA, todos con controles alineados con ISO 27001 y SOC 2 Type II en curso); y el desplazamiento horario (a los clientes de la costa oeste se les trasladan dos ingenieros a un horario CET tardío sin tarifa adicional). GPU, herramientas de terceros, nube y viajes, cuando hacen falta, corren por sus propias cuentas para que usted conserve el control del gasto. Los precios son orientativos y se fijan en un presupuesto mensual por escrito para su squad concreto.

Plataforma social en producción, en App Store y Google Play, activa en EE. UU. y la UE, con Radar geolocalizado, mensajería cifrada y economía virtual.

Clientes nativos de firma electrónica para iOS y Android con un CRM en Symfony + React para un despacho de abogados internacional: onboarding con KYC y una cadena de evidencias defendible para asuntos de EE. UU. y la UE.
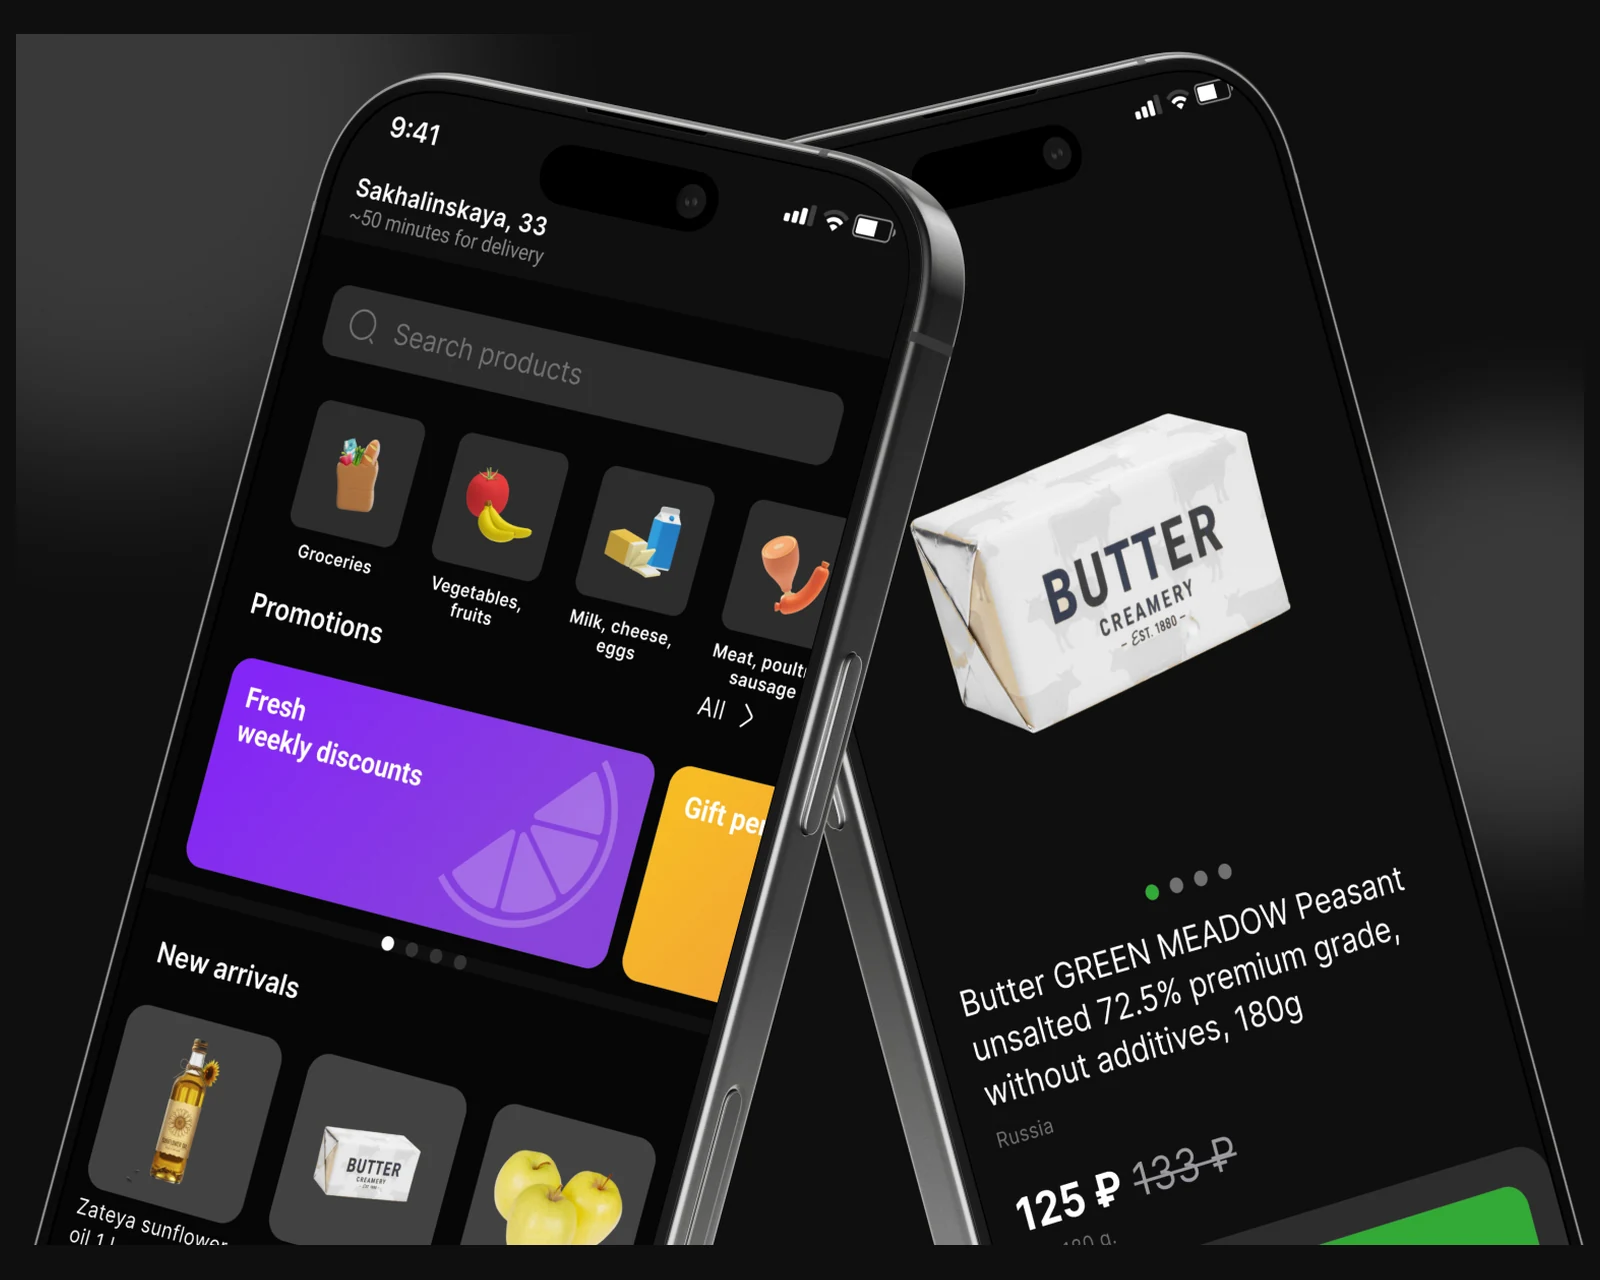
Cuatro productos coordinados sobre un único backend en Laravel (app de cliente, app de preparador y panel de administración) con una logística diseñada desde cero.
La ampliación de equipos funciona mejor cuando los ingenieros conocen desde el primer día el panorama de integraciones, los requisitos normativos y el contexto de producto del sector. Nuestros equipos se especializan por vertical.
Los equipos de ingeniería dedicados a plataformas de crédito, procesadores de pagos y productos de finanzas embebidas deben entender el ámbito de PCI DSS como un principio de partida, no como un trámite posterior. Los ingenieros de los squads de FinTech conocen los patrones de tokenización, el diseño de APIs de pago idempotentes, la integración de SCA de PSD2 y los requisitos de documentación que revisará su QSA.
En el plano de los datos, los equipos de FinTech trabajan con patrones de libro mayor basados en eventos, pipelines de conciliación e integraciones de puntuación antifraude en tiempo real: las partes del stack donde un error cuesta dinero y no solo experiencia de usuario. No incorporamos ingenieros júnior a los squads de FinTech; todos los puestos son de nivel sénior o superior.
Los equipos de ingeniería sanitaria trabajan por defecto dentro del ámbito del Business Associate Agreement de HIPAA. Los ingenieros entienden las restricciones del tratamiento de PHI a nivel de código: qué se puede registrar en logs, qué debe cifrarse en reposo y en tránsito, cómo se estructuran las pistas de auditoría de acceso y cómo implementar una desidentificación que cumpla Safe Harbor y no se limite a enmascarar campos visibles.
Los productos sanitarios de la UE añaden las obligaciones del artículo 9 del RGPD sobre categorías especiales de datos. Los equipos que desarrollan para el mercado alemán o el francés conocen las obligaciones adicionales de las leyes nacionales de datos de salud (legislación complementaria del RGPD, certificación HDS en Francia). Estas restricciones condicionan el diseño de las APIs, la arquitectura de almacenamiento y la elección de proveedores de maneras que pasan inadvertidas hasta una auditoría.
Los equipos dedicados de e-commerce trabajan con un conjunto muy concreto de integraciones: sistemas ERP (SAP, Dynamics, NetSuite), plataformas CRM (Salesforce, HubSpot), herramientas PIM y procesadores de pagos. Los ingenieros que no han construido nunca sobre estos sistemas se ralentizan en cada punto de integración. Los ingenieros de nuestro squad de retail han trabajado con los sistemas de back-office más habituales y saben dónde se esconden los casos límite sin documentar.
El retail tiene un segundo reto de ingeniería que los sectores de software puro no conocen: gestionar los picos de tráfico de temporada. Los equipos que han construido y operado autoescalado a escala de Black Friday saben distinguir entre sistemas teóricamente escalables y sistemas que realmente resisten un tráfico 10 veces mayor sin necesidad de una sala de crisis.
Los equipos de ingeniería logística trabajan con sistemas orientados a eventos, clientes móviles offline-first y cálculo geoespacial como dominios técnicos centrales. Los ingenieros que dominan los consumer groups de Kafka, la resolución de conflictos basada en CRDT para la sincronización offline y la indexación geoespacial (PostGIS, H3) pueden ser productivos desde el primer sprint. Los que tienen que aprender estos patrones sobre la marcha tardan de tres a seis meses en alcanzar su plena velocidad.
Los productos de movilidad y última milla añaden requisitos en tiempo real: asignación de despacho en menos de un segundo, predicción del ETA con tráfico variable y seguimiento en vivo con WebSocket o SSE. Formamos los squads de movilidad con ingenieros que han operado estos sistemas en producción, y no solo diseñado en teoría.
Los equipos dedicados de SaaS afrontan un reto estructural: cada cliente es un tenant, y el sistema debe aislar sus datos, su configuración y su facturación por uso sin contaminación cruzada. Los ingenieros que dominan los patrones de multitenencia (modelos silo, pool y bridge) y sus implicaciones en el diseño de bases de datos, el control de acceso y el seguimiento del coste por tenant toman mejores decisiones de arquitectura desde el principio.
Los productos B2B SaaS también deben superar revisiones de seguridad empresariales. Nuestros ingenieros implementan como práctica estándar OAuth 2.0 con PKCE, RBAC con extensiones basadas en atributos, exportación de logs de auditoría, limitación de tasa con cuotas visibles para el cliente e integraciones SAML/SCIM, y no como sprints adicionales cuando lo exige un cliente empresarial potencial.
Las plataformas de aprendizaje y los productos de medios comparten un núcleo técnico: distribución de contenido de alto rendimiento a bajo coste, sesiones síncronas en directo con garantías de calidad y analítica de uso a nivel de alumno o espectador. Los equipos dedicados de EdTech dominan la integración de SCORM y xAPI para informes en un LRS, la arquitectura de pipelines de vídeo con bitrate adaptativo y los patrones de motores de evaluación que distinguen un cuestionario de una evaluación justa.
Las plataformas de EdTech de EE. UU. deben cumplir las obligaciones de FERPA y los flujos de consentimiento de COPPA. Las plataformas de la UE añaden las obligaciones del RGPD específicas de los datos de los alumnos y, en las de financiación pública, requisitos de interoperabilidad con los estándares nacionales de LMS. No son requisitos de trámite: determinan el modelo de datos, el diseño de las APIs y la arquitectura de gestión del consentimiento del producto.
Alineados con el RGPD · preparados para ISO 27001 · SOC 2 Type II en curso · aptos para HIPAA · CCPA contemplada
Los ingenieros se unen a su standup de esta mañana, no al de ayer. Jornada CET con solapamiento con la costa este de EE. UU. (9:00 a 13:00 ET). Las revisiones y decisiones se cierran en un día hábil.
Sin júniors escondidos tras contratos sénior. Cada CV es real y cada ingeniero entrega desde la primera semana.
Residencia de datos en la UE · opciones en EE. UU. bajo petición, DPA bajo petición, controles alineados con ISO 27001 y SOC 2 Type II en curso. Ámbito preparado para PCI DSS y HIPAA disponible para squads de fintech y salud.
En los squads de pagos y crédito trabajamos dentro del ámbito de PCI DSS y nos alineamos directamente con su QSA en accesos, registros y segregación de funciones.
Crear una plataforma social desde cero es un trabajo de alto riesgo. YuSMP entregó el feed por intereses, el Radar geolocalizado, las Stories y la economía de monedas virtuales en plazo, con un código que nuestro equipo interno pudo asumir desde el primer día del traspaso.
Nuestras apps de iOS y Android habían divergido tras años de desarrollo por separado. YuSMP reconstruyó una única solución unificada con cámaras en vivo, control de dispositivos del hogar inteligente y acceso multiusuario basado en roles. Cero defectos críticos en los primeros seis meses tras el lanzamiento.
Un equipo dedicado no es un simple recuento de puestos. Así pensamos la composición, el tiempo de puesta en marcha y lo que influye en ambos.
Un squad de dos ingenieros (uno sénior y uno de nivel intermedio) es la configuración mínima capaz de mantener los estándares de revisión de código y de cubrir una baja sin detener el trabajo. Un squad de cuatro añade un tech lead y un ingeniero de QA, y es autosuficiente para la mayoría de las funcionalidades nuevas. Un squad de ocho sostiene dos líneas de trabajo en paralelo con revisión de código independiente y cobertura de guardias.
La mayoría de los clientes empieza con una configuración de dos a cuatro ingenieros y escala según señales de rendimiento, no por intuición. Medimos el cycle time de las historias y la profundidad de la cola de PR como indicadores adelantados de que el equipo necesita más capacidad, y le mostramos esas cifras antes de que el atasco del backlog sea visible.
Un ingeniero con experiencia que se incorpora a un código nuevo alcanza su plena velocidad en cuatro a seis semanas. Lo alargan las decisiones de arquitectura sin documentar, la falta de cobertura de pruebas (sin tests no hay forma segura de cambiar nada) y un lenguaje de dominio ambiguo en el código. Aplicamos una lista de control en las semanas uno, dos y cuatro: recorrido por la arquitectura, mapa de cobertura de pruebas, revisión del glosario de dominio y una primera PR en solitario. Las carencias en cualquiera de ellos se comunican como riesgos, no como sorpresas.
Mantenemos en su repositorio una base de conocimiento específica de la colaboración (registros de decisiones de arquitectura, runbooks, glosario de dominio y guía de incorporación) que reduce el tiempo de puesta en marcha de cada ingeniero posterior, sea de nuestro equipo o del suyo. Cuando más adelante contrate internamente, los nuevos miembros se incorporarán con esa misma documentación y no dependerán de la memoria institucional.
Dedicado significa que los ingenieros de su equipo trabajan únicamente en su producto. No rotan entre clientes, no llevan trabajo paralelo para otros clientes en segundo plano y no se les desvía para cubrir la incidencia de otra cuenta. Las direcciones de correo, los usuarios de Slack y los usernames de GitHub del equipo son suyos mientras dure la colaboración: aparecen en su directorio y en su historial de git como miembros de su organización.
Esto importa por dos razones más allá de la evidente atención exclusiva. Primero, la acumulación de contexto: un ingeniero que lleva 12 meses en su sistema toma decisiones más rápidas y mejores que uno que se incorporó el mes pasado. Segundo, la confianza: sus clientes tratan con sus nombres y sus caras en el soporte, y un modelo de bolsa con ingenieros rotatorios rompe esa continuidad. No trabajamos con un modelo de bolsa ni lo ofrecemos.
Cada candidato supera un proceso de cuatro fases: revisión del CV y del nivel de inglés, dos entrevistas técnicas adaptadas a su stack, una prueba práctica remunerada evaluada con sus criterios de aceptación y una entrevista de encaje cultural con su responsable de equipo. Usted entrevista a los finalistas y aprueba cada incorporación — nunca asignamos puestos de forma unilateral. Las pruebas no superadas no se facturan. El mismo proceso se aplica a perfiles intermedios, sénior y de liderazgo, y compartimos las fichas de evaluación si las solicita.
Puede solicitar una sustitución en cualquier momento, sin penalización y sin más preaviso que dos semanas de traspaso. Mantenemos una bolsa de candidatos ya validados en stacks equivalentes, por lo que una lista de candidatos de reemplazo suele llegarle en cinco días hábiles. El traspaso de conocimiento queda documentado en su repositorio y en los runbooks durante el periodo de solapamiento, de modo que el ingeniero saliente se desvincula por completo antes de que el nuevo puesto empiece a facturarse.
La entrega se realiza en horario CET desde Ereván, lo que garantiza cuatro horas de solapamiento síncrono con clientes de la costa este de EE. UU. (de 9:00 a 13:00 ET) y unas siete horas con cualquier oficina europea. Esa ventana cubre las dailies, las revisiones de código, las sesiones de diseño y la respuesta ante incidencias. Para clientes de la costa oeste, desplazamos a dos ingenieros por equipo a un horario CET tardío si lo solicita, sin tarifa adicional.
Facturamos una cuota mensual fija por puesto nominal, con todos los costes incluidos — salario, impuestos, equipamiento, vacaciones, gestión y gastos generales en una única partida. El precio es mensual, cerrado y todo incluido en USD, según el tamaño del squad: equipo Mini desde $6,900 / mes, equipo Standard desde $13,800 / mes y equipo Product desde $27,600 / mes. No hay recargo de selección, ni sobrecoste por herramientas, ni tamaño mínimo de equipo más allá de un ingeniero. La propiedad intelectual se transfiere el primer día y los costes de nube corren por sus propias cuentas, así que usted conserva el control del gasto. Verá el presupuesto desglosado al terminar el descubrimiento y lo aprobará antes de escribir una sola línea de código.
Usted. El equipo trabaja con su Jira, su cadencia de sprints y su product owner. Nuestro delivery lead reporta a su engineering manager, y no al revés, y se encarga de los rituales internos — revisión de código, pair programming, demos — para que usted se concentre en la hoja de ruta. Le informamos de los riesgos cada semana mediante una nota de estado escrita y una revisión de 30 minutos, y no introducimos alcance propio en su backlog.
Toda la propiedad intelectual se transfiere a usted desde su creación en virtud del contrato marco de servicios; los ingenieros firman cláusulas individuales de cesión de propiedad intelectual y de confidencialidad (NDA). Estamos alineados con el RGPD, listos para ISO 27001, preparados para HIPAA en cargas de trabajo sanitarias y con SOC 2 Type II en curso. Los ingenieros trabajan en equipos gestionados con discos cifrados, SSO, MFA y repositorios aislados. Reconocemos las obligaciones de aviso de la CCPA para los datos de consumidores de EE. UU.
Sí. Admitimos colaboraciones con un solo ingeniero para bases de código que necesitan un generalista sólido, o para clientes que quieren validar la relación de trabajo antes de comprometerse con un equipo mayor. La unidad mínima de facturación es un puesto a tarifa horaria. La salvedad práctica es que un único ingeniero no puede cubrir con seguridad vacaciones, bajas y guardias a la vez; para garantizar la continuidad recomendamos un mínimo de dos ingenieros en cualquier sistema que requiera fiabilidad 24/7. Cuando esté listo para crecer, el proceso es el mismo que para cualquier incorporación: una lista de candidatos en cinco días hábiles, su aprobación de cada uno y un periodo estándar de puesta en marcha de cuatro semanas que reducimos con la documentación del ingeniero existente.
Exigimos una colaboración mínima de tres meses. El primer mes es de puesta en marcha, el segundo es el primero a pleno ritmo y el tercero ofrece la primera señal significativa de rendimiento. Las colaboraciones de menos de tres meses rara vez producen resultados medibles en relación con la inversión de incorporación de ambas partes, y se resuelven mejor con un proyecto de desarrollo a medida de alcance cerrado. La mayoría de las colaboraciones duran entre 12 y 24 meses; la más larga activa en el momento de escribir esto lleva 38 meses. No atamos a los clientes a contratos anuales: la facturación es mensual, con un preaviso de rescisión de 30 días una vez superado el mínimo inicial de tres meses.
La incorporación sigue una lista de control de cuatro semanas. Semana uno: concesión de accesos, recorrido por la arquitectura, revisión del glosario de dominio y exploración del código en modo solo lectura. Semana dos: primera sesión de pair programming con su ingeniero sénior y primera PR (pequeña, en un área bien probada). Semana tres: funcionalidad en solitario con revisión de código por ambas partes. Semana cuatro: primer ciclo autónomo de ticket, merge y despliegue, más una retro de puesta en marcha donde sacamos a la luz las carencias. No facturamos la primera semana a plena capacidad si los accesos no están listos el primer día: el reloj empieza cuando el ingeniero puede abrir el código, no cuando entra en el espacio de trabajo de Slack.
En cada colaboración aportamos un delivery lead. Dirige los rituales internos del equipo (dailies, cadencia de revisión de código, sesiones de pair programming, retrospectivas de sprint) para que usted se centre en el producto y no en la higiene del equipo. También elabora una nota de estado semanal por escrito con velocidad, bloqueos, riesgos y avances, y preside una llamada de revisión semanal de 30 minutos con su product owner o su engineering manager. Puede gestionar directamente las prioridades y el backlog (lo hace la mayoría de los clientes) o delegarlo en nosotros (aportamos un PM como puesto adicional). El delivery lead no es un project manager en el sentido tradicional: no genera diagramas de Gantt ni gestiona dependencias entre equipos; es un líder de ingeniería que además asume la responsabilidad de la entrega.
Sí. En productos nuevos realizamos un taller de arquitectura de una semana antes del primer sprint: sus requisitos, nuestra propuesta de stack, las alternativas consideradas y un registro de decisiones que documenta por qué elegimos lo que elegimos. La recomendación se basa en tres criterios: la adecuación a la escala y a los requisitos de rendimiento del producto, la facilidad de mantenimiento con la mayor bolsa de ingenieros sénior que podrá contratar en ese stack dentro de tres años, y la carga operativa según la madurez de DevOps que probablemente tenga su equipo. No somos agnósticos en el sentido de no tener criterio: tenemos opiniones firmes respaldadas por experiencia en producción, pero siempre le diremos cuándo su preferencia actual de stack es razonable, en lugar de imponer una tecnología por sí misma.
Guías prácticas sobre modelos de externalización, selección de equipos y costes de desarrollo.
Cuéntenos algunos detalles y un consultor sénior le responderá en un día hábil.