Aplicaciones de LLM que se ganan el sueldo
Copilotos, búsqueda, resúmenes y flujos documentales vinculados a KPI medibles. Entregamos funcionalidades que mueven las métricas, no demos que se estancan en el piloto.

Servicios
Consultoría de inteligencia artificial: YuSMP Group desarrolla aplicaciones de IA generativa de nivel productivo, sistemas RAG, agentes de IA y los pipelines de datos que los alimentan, en niveles ajustados de alcance cerrado y no como un proyecto empresarial de seis cifras. Una PoC / piloto desde $2,900 en 4–6 semanas, RAG sobre su base de conocimiento desde $8,100, un agente de IA autónomo desde $10,400 y un modelo de ML en producción desde $13,800. Más de 80 ingenieros sénior en Ereván trabajan con solapamiento CET / costa este de EE. UU. sobre un stack neutral respecto a los proveedores de modelos entre OpenAI, Anthropic y Bedrock. Precios en USD de alcance cerrado y todo incluido, propiedad intelectual transferida a usted el primer día, alineado con el RGPD y estructurado desde el primer día para la preparación del Reglamento de IA de la UE, no añadido a posteriori.
Neutral respecto a proveedores de modelos · alineado con el RGPD · preparado para ISO 27001 · SOC 2 Type II en curso · apto para HIPAA · atento al Reglamento de IA de la UE y a NIST AI RMF · jornada CET con solapamiento de 9:00–13:00 ET
Entregamos un alcance conectado: aplicaciones de IA generativa, generación aumentada por recuperación, agentes de IA de varios pasos, aprendizaje automático clásico, la ingeniería de datos que hace fiable todo lo anterior y el MLOps que lo mantiene en marcha. Nuestros equipos son neutrales respecto a los proveedores de modelos (Anthropic, OpenAI, pesos abiertos mediante Bedrock o autoalojados) y eligen el stack según su residencia de datos, su latencia y su marco de costes. La gobernanza está integrada: RGPD, controles de ISO 27001, SOC 2 Type II en curso, entrega apta para HIPAA y un paso de clasificación de riesgo del Reglamento de IA de la UE en cada proyecto. Véalo en la práctica en nuestro caso de éxito ARIA.
Copilotos, búsqueda, resúmenes y flujos documentales vinculados a KPI medibles. Entregamos funcionalidades que mueven las métricas, no demos que se estancan en el piloto.
Recuperación híbrida, reranking, evaluación y observabilidad. Ajustamos con sus datos, sus consultas y sus criterios de aceptación, no con benchmarks de juguete.
Entrenamiento reproducible, registros de modelos, despliegues en sombra y monitorización de deriva y sesgo. Cada modelo tiene un camino claro del notebook a producción.
Stack de datos moderno sobre Snowflake, BigQuery o Databricks. ELT con dbt, contratos entre equipos y linaje en el que pueden confiar tanto sus auditores como sus analistas.
Clasificación de riesgos, avisos de transparencia, documentación técnica y supervisión humana integrados en el producto conforme al Reglamento de IA de la UE y al NIST AI Risk Management Framework, no añadidos justo antes de una auditoría. Atentos a las leyes estatales (Colorado AI Act 2026, NYC AEDT, normas ADM de la CCPA).
Conjuntos de datos de referencia, regresiones automatizadas y evaluaciones offline en cada cambio de prompt y de modelo. La calidad es un número, no una sensación.
¿Necesita un proyecto acotado en lugar de un desarrollo de extremo a extremo? Cada capacidad que figura a continuación es un servicio específico de YuSMP con su propio equipo sénior, su guía de entrega y su enfoque de cumplimiento para EE. UU. y la UE.
Integre la IA generativa en su producto existente: copilotos, resúmenes y flujos de contenido sobre un stack neutral respecto a los modelos.
Integración de IA generativa →Recuperación híbrida, reranking y evaluación sobre su propia base de conocimiento, con observabilidad y guardrails.
Implementación de RAG →Agentes de varios pasos que ejecutan acciones en sus herramientas, con supervisión humana (human-in-the-loop) en los caminos de alto riesgo.
Agentes de IA →Pipelines de detección, clasificación y OCR para equipos industriales y de producto, entrenados y monitorizados con sus datos.
Visión artificial →Ajuste fino, evaluaciones y el MLOps para desplegar y monitorizar modelos cuando el RAG por sí solo no alcanza sus objetivos de coste o latencia.
Ajuste fino y MLOps →Clasificación de riesgos, documentación técnica y diseño de supervisión humana para que su IA llegue a la UE lista para auditoría.
Cumplimiento del Reglamento de IA de la UE →Mapeamos los casos de uso según el valor de negocio, la preparación de los datos y la doble clasificación de riesgo (clase de riesgo del Reglamento de IA de la UE más el perfil Govern/Map/Measure/Manage de NIST AI RMF) y después elegimos los dos o tres con mayor retorno.
La arquitectura de referencia, el banco de evaluación, los pipelines de datos y los límites de la supervisión humana (human-in-the-loop) se diseñan antes de conectar ningún modelo al producto.
Sprints de dos semanas con evaluaciones offline, pruebas A/B con usuarios reales, control de versiones de prompts y modelos, y observabilidad de coste, latencia y calidad.
Paneles de deriva, sesgo y coste, reevaluaciones programadas y un backlog vinculado a los cambios de modelos y de normativa en la UE (Reglamento de IA), en EE. UU. (NIST AI RMF, leyes estatales) y entre los principales proveedores.
Para pruebas de valor de IA acotadas, pilotos de RAG y construcción de plataformas de datos con criterios de aceptación claros y una fecha límite fija.
Para productos de IA en evolución en los que los prompts, los modelos y las métricas cambian cada semana. Squad sénior, demos semanales y revisiones mensuales de capacidad.
Un squad de IA y datos de larga duración integrado en su organización de producto, responsable de la calidad de los datos, el ciclo de vida de los modelos y la documentación de cumplimiento.
La mayoría de los proveedores se reservan la cifra para una llamada comercial. Estos son nuestros niveles ajustados de alcance cerrado para que pueda presupuestar antes del descubrimiento. Todo va incluido, presupuestado en USD, con la propiedad intelectual transferida a usted el primer día, sin recargo por intermediación, sin sobrecostes por herramientas y sin tarifas ocultas. Usted ve el presupuesto desglosado antes de escribir una sola línea de código y lo aprueba. Los costes de la nube y de GPU corren por sus propias cuentas, de modo que conserva el control del coste.
PoC / piloto
desde $2,900
4–6 semanas · un caso de uso
Una prueba de concepto acotada con sus datos reales: un caso de uso, un prototipo funcional de extremo a extremo, un conjunto de evaluación y una decisión de seguir o no por escrito con una proyección de costes.
RAG sobre su base de conocimiento
desde $8,100
anclado en su corpus
Generación aumentada por recuperación sobre su propia base de conocimiento: ingesta y fragmentación, recuperación híbrida y reranking, un banco de evaluación en CI, guardrails y observabilidad.
Agente de IA (autónomo)
desde $10,400
de varios pasos, con uso de herramientas
Un agente de varios pasos que actúa en todas sus herramientas, con intervención humana en las rutas críticas, evaluaciones deterministas, filtros de salida y un runbook que gestiona su equipo.
Modelo de ML en producción
desde $13,800
del notebook a producción
Un modelo de ML a medida llevado a producción: pipelines de datos, entrenamiento y ablaciones, MLOps con monitorización de deriva y sesgo, y un camino documentado del notebook al servicio en producción.
Lo que mueve la cifra: cuántos casos de uso entrega y cuánta profundidad tiene cada corpus de RAG; el tamaño del conjunto de evaluación necesario para confiar en los resultados; los objetivos de latencia (un p95 por debajo de 500 ms condiciona la elección de modelo e infraestructura); y el alcance de cumplimiento: el RGPD está dentro del alcance por defecto, pero los flujos de datos aptos para HIPAA, la residencia exclusiva en la UE o los contratos de proveedor de retención cero añaden trabajo de controles. La GPU, las herramientas de terceros y el gasto en la nube corren por sus propias cuentas. Todo lo que quede fuera del alcance firmado pasa a una hoja de ruta con estimaciones dimensionadas, en lugar de una ampliación silenciosa del calendario. Los precios son orientativos y se fijan en un presupuesto escrito para su alcance concreto.
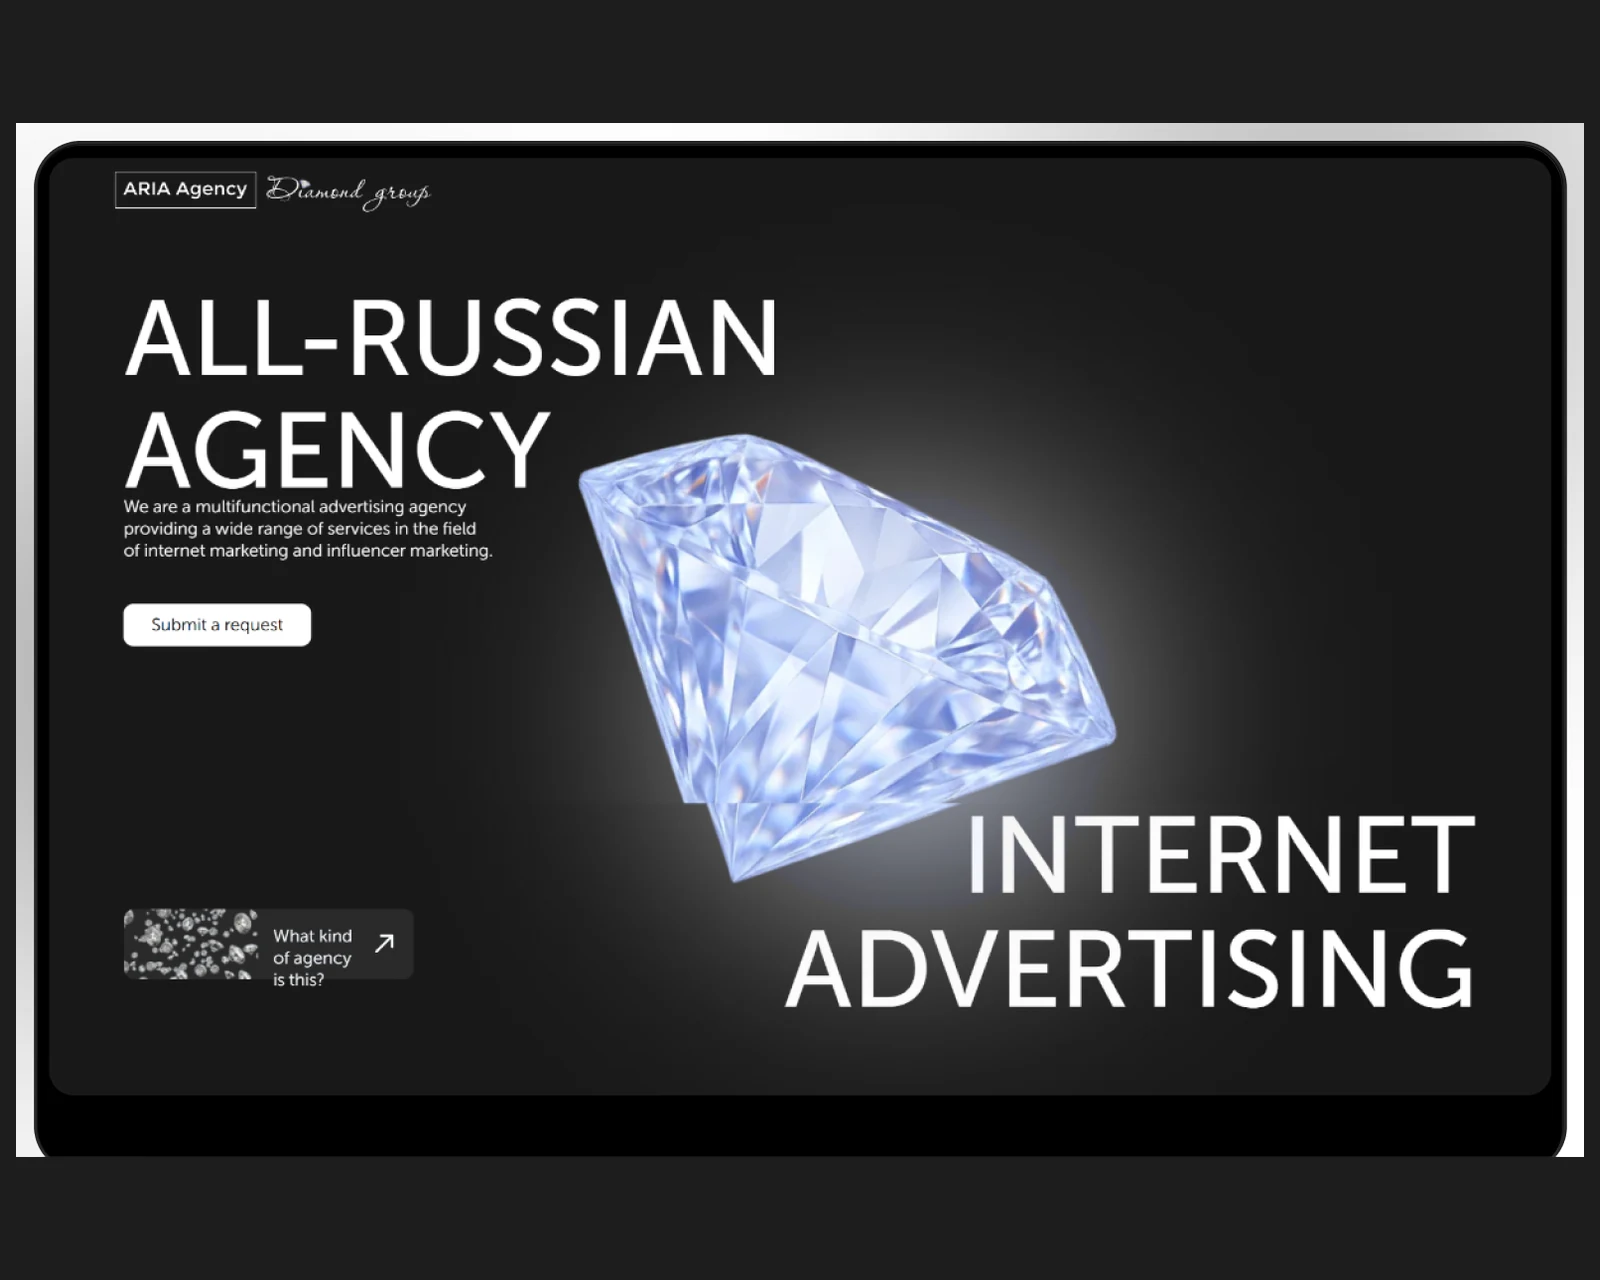
Landing de una sola página en Tilda con captación de leads mediante bot de Telegram para una agencia de publicidad: lanzada en dos semanas y lista para EE. UU. y la UE.
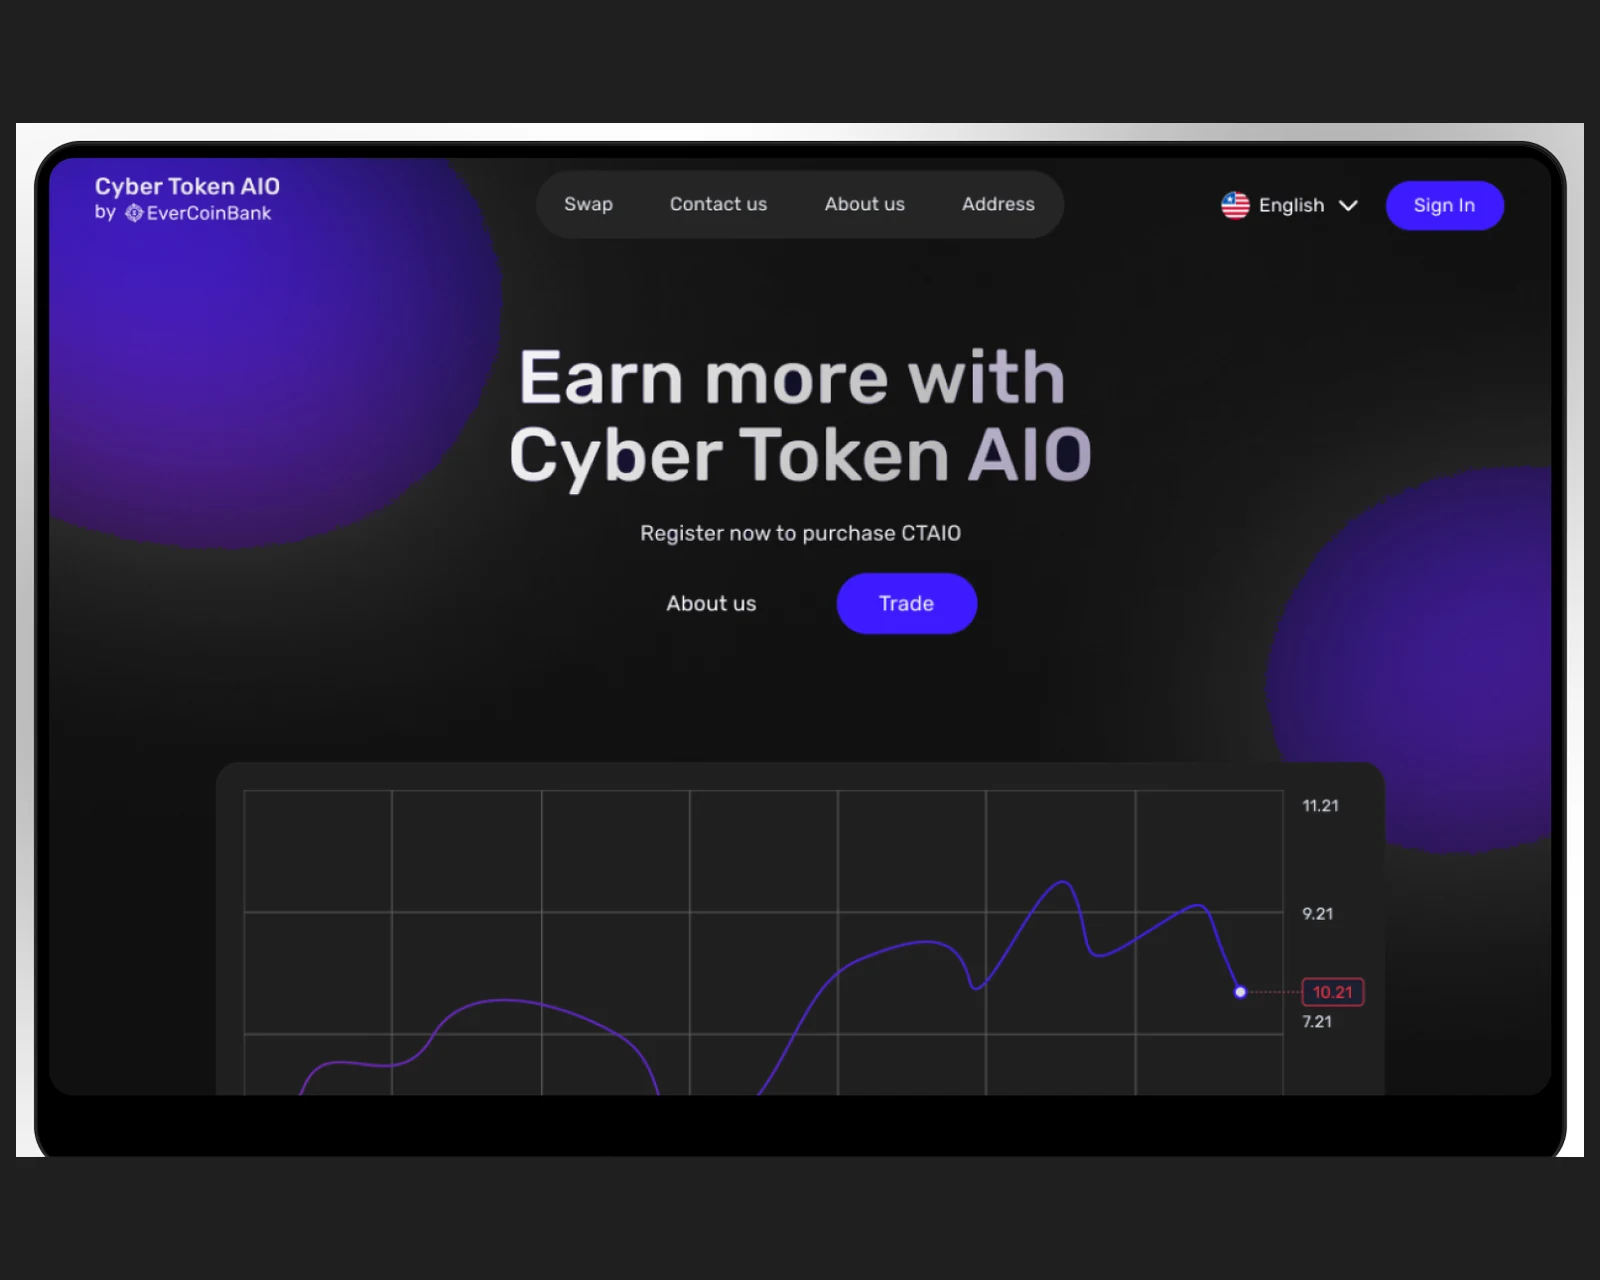
Lanzamiento integral de un token ERC-20: contrato en Solidity, auditoría de seguridad, listados en exchanges y pago con MetaMask en el sitio del proyecto.
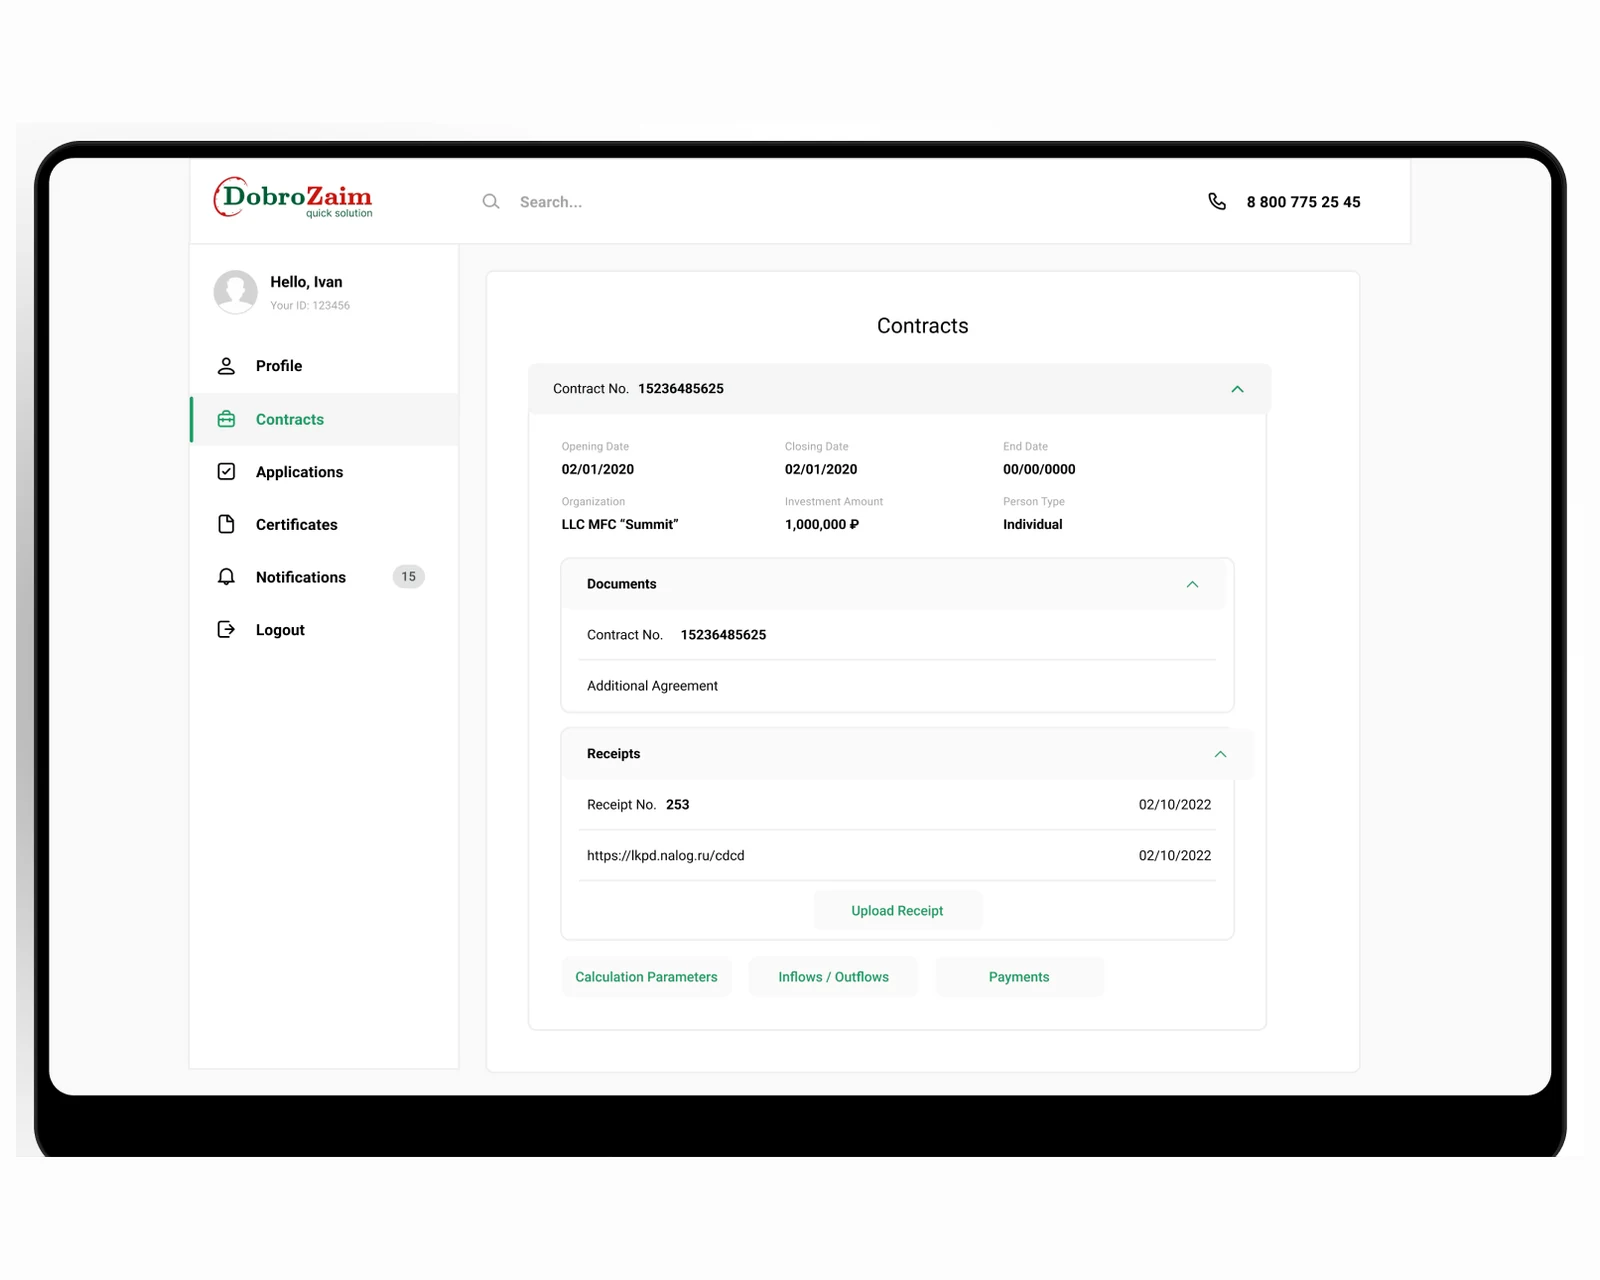
Motor de decisión de préstamos de alto rendimiento en Laravel: scoring automatizado, integración con burós de crédito y decisiones 10 veces más rápidas para prestamistas de EE. UU. y la UE.
La IA solo es útil cuando respeta la realidad de datos, latencia y regulación de su sector. Combinamos el ML y la ingeniería de datos con el cumplimiento específico de cada sector en los mercados de EE. UU. y la UE.
La puntuación de fraude en tiempo real exige modelos de ML que evalúen más de 200 variables por transacción en menos de 50 ms. Entrenamos modelos de gradient boosting (LightGBM, XGBoost) y redes neuronales con historiales de transacciones, huellas de dispositivo y biometría del comportamiento, y los desplegamos mediante feature stores (Feast) y servidores de inferencia de baja latencia (TorchServe, Triton) que cumplen los requisitos de SLA de las entidades financieras.
Modelos de riesgo crediticio para decisiones de préstamo, predicción del CLV para la segmentación de clientes y modelos de monitorización de transacciones AML que usan redes neuronales de grafos para detectar redes de blanqueo de capitales son aplicaciones de IA en producción que desarrollamos y mantenemos para clientes de FinTech. Diseñamos marcos de gobernanza de modelos con fichas de modelo (model cards), evaluación de sesgo sobre atributos protegidos y documentación de explicabilidad regulatoria para los requisitos de gestión del riesgo de modelos de la OCC y la FCA. Véase FinTech.
La IA de imagen médica para el triaje en radiología, el análisis de portaobjetos de patología y el cribado oftalmológico requiere pipelines de datos conformes con DICOM, planificación regulatoria de FDA SaMD y estudios de validación clínica antes del despliegue. Construimos pipelines de análisis de imagen con PyTorch sobre el framework MONAI, implementamos flujos de desidentificación conformes con los métodos Safe Harbor y Expert Determination de HIPAA, y diseñamos protocolos de estudios clínicos aprobados por un IRB para validar el rendimiento de la IA.
Los sistemas de PLN clínico extraen datos estructurados de notas clínicas no estructuradas para la codificación ICD-10, la analítica de salud poblacional y el reclutamiento en ensayos clínicos, con modelos adaptados al dominio y ajustados sobre texto clínico (BioBERT, ClinicalBERT). Implementamos pipelines de PLN conformes con HIPAA con preprocesamiento de desidentificación y registro de auditoría, y diseñamos flujos de anotación con revisión de expertos clínicos para garantizar la calidad de las etiquetas de referencia. Véase HealthTech.
Los sistemas de recomendación que generan entre el 35 y el 40 % de los ingresos del e-commerce requieren inferencia en tiempo real sobre las señales de comportamiento de la sesión, no solo sobre datos históricos de compra. Construimos arquitecturas de recuperación y ranking en dos etapas: una capa rápida de recuperación por vecinos más cercanos aproximados (ANN) con FAISS o ScaNN que recupera 100 candidatos en menos de 5 ms, seguida de un modelo de ranking que puntúa los candidatos con variables orientadas al negocio (margen, inventario, actualidad) antes de servir la lista final ordenada.
Los modelos de precios dinámicos optimizan el momento de las rebajas para inventario perecedero, la asignación de descuentos promocionales entre segmentos de clientes y la igualación de precios de la competencia en tiempo real mediante pipelines de scraping y modelos de elasticidad de precios. Implementamos infraestructura de pruebas A/B para experimentos de precios con grupos de control adecuados y pruebas de significación estadística, midiendo el impacto incremental en los ingresos y no el precio medio de venta. Véase E-commerce.
Los modelos de mantenimiento predictivo reducen entre un 30 y un 50 % las paradas imprevistas al detectar firmas de fallo de los equipos en series temporales de sensores antes de que se manifiesten como averías. Construimos modelos de detección de anomalías basados en LSTM y Transformer para flujos de sensores de vibración, temperatura y presión, desplegamos la inferencia en dispositivos edge (NVIDIA Jetson, PC industriales) para alertas en menos de un segundo sin la latencia de ida y vuelta a la nube, y los integramos con los CMMS (sistemas informatizados de gestión del mantenimiento) para generar automáticamente órdenes de trabajo cuando las puntuaciones de anomalía superan los umbrales.
Los sistemas de inspección de calidad con visión artificial sustituyen la inspección visual manual en las líneas de producción con matrices de cámaras que procesan más de 100 fotogramas por segundo mediante modelos de detección de defectos (YOLO, Detectron2) que detectan defectos superficiales, desviaciones dimensionales y errores de montaje que los inspectores humanos pasan por alto por fatiga. Diseñamos flujos de recopilación de datos de entrenamiento, herramientas de anotación y pipelines de aprendizaje activo que mejoran continuamente la precisión del modelo a medida que aparecen nuevos tipos de defecto.
Los modelos de previsión de demanda para la planificación de la cadena de suministro usan técnicas jerárquicas de series temporales (Temporal Fusion Transformer, Prophet, ARIMA con variables exógenas) que tienen en cuenta los calendarios promocionales, la estacionalidad y las señales externas de demanda (clima, indicadores económicos). Construimos pipelines de previsión que generan previsiones de demanda por artículo, ubicación y semana a escala (millones de SKU), integrados con sistemas ERP para generar automáticamente pedidos de compra cuando los niveles de inventario superan los puntos de reposición. Véase Logística.
La optimización de rutas con algoritmos de grafos potenciados por ML reduce el coste de entrega de última milla por paquete al identificar la secuencia óptima de paradas bajo restricciones del mundo real (ventanas horarias, capacidad del vehículo, pausas obligatorias de los conductores). Construimos API de optimización de rutas con OR-Tools y solvers comerciales (Gurobi), reforzadas con predicción mediante ML de las distribuciones de tiempo de entrega a nivel de dirección, lo que mejora la precisión de la hora estimada de llegada en las interfaces de seguimiento de cara al cliente.
La integración de IA generativa en productos SaaS (escritura asistida por IA, autocompletado de código, preguntas y respuestas sobre documentos, búsqueda inteligente) requiere una infraestructura sólida de orquestación de LLM, versionado de prompts y validación de salidas que va más allá de las llamadas directas a la API. Construimos capas de orquestación de LLM con LangChain y LlamaIndex con análisis de salidas estructuradas, implementamos sistemas de gestión de prompts con capacidad de pruebas A/B para la optimización continua y diseñamos pipelines RAG con bases de datos vectoriales (Pinecone, pgvector) que anclan las respuestas del LLM en las bases de conocimiento de la empresa.
Las funcionalidades de IA empresarial deben abordar la privacidad de los datos (los datos de los clientes no deben usarse para entrenar modelos de proveedores de LLM de terceros), la latencia (el tiempo de respuesta de la IA generativa no debe degradar la velocidad percibida del producto) y el coste (los costes de la API de LLM a escala pueden superar los de la infraestructura). Diseñamos arquitecturas de LLM optimizadas en costes con enrutamiento inteligente entre modelos de nivel GPT-4 para tareas complejas y modelos más pequeños (Llama 3, Mistral) para tareas rutinarias, con caché semántica para evitar llamadas redundantes y costosas a la API.
Alineados con el RGPD · preparados para ISO 27001 · SOC 2 Type II en curso · aptos para HIPAA · CCPA contemplada
Ingenieros de datos y responsables de ML con jornada CET y solapamiento con la costa este de EE. UU. (9:00–13:00 ET), presentes en sus standups, con decisiones en el mismo día sobre prompts, modelos y despliegues.
Ingenieros de ML y responsables de plataformas de datos con sistemas en producción entregados en EE. UU. y la UE. No aprendemos bases de datos vectoriales a costa de su hoja de ruta.
Endpoints alojados con bloqueo de región (residencia de datos en la UE · opciones en EE. UU. bajo petición), configuraciones de retención cero, DPA y BAA firmados, controles alineados con ISO 27001 y SOC 2 Type II en curso. Delimitación de PCI DSS donde el ML toca pagos; apto para HIPAA donde el ML toca información médica protegida (PHI).
La doble gobernanza de la IA forma parte de cada decisión de arquitectura: en la UE aplicamos el Reglamento de IA (clasificar cada caso de uso, documentar el sistema, fijar puntos de supervisión humana, preparar evidencias para escenarios de alto riesgo como la contratación, la puntuación crediticia y el tratamiento biométrico); en EE. UU. aplicamos las órdenes ejecutivas federales sobre IA, NIST AI RMF (Govern / Map / Measure / Manage), las expectativas de OMB M-24-10 y cribados de leyes estatales: Colorado AI Act (en vigor en 2026), NYC AEDT (Local Law 144), el NY AI Bill of Rights y las normas de toma de decisiones automatizadas de la CCPA / CPRA.
Un motor de decisión de créditos que aprueba diez veces más rápido no surge por casualidad. YuSMP construyó el flujo de scoring, la integración con burós de crédito y un back-office que a nuestros analistas de riesgos les gusta usar. El plazo de aprobación pasó de dos días a menos de cuatro horas.
Agregar precios en vivo de varios exchanges manteniendo la latencia por debajo de 500 ms es ingeniería realmente difícil. YuSMP integró el feed multi-exchange, los gráficos de tokens en tiempo real y el flujo de listados en una plataforma coherente. No hemos sufrido ninguna caída desde el lanzamiento.
La decisión correcta sobre infraestructura de IA depende de la sensibilidad de sus datos, el volumen de consultas, los requisitos de latencia y la capacidad de su organización para gestionar sistemas de IA en producción.
Usar la API de GPT-4 es la opción adecuada para tareas de propósito general en las que la precisión específica del dominio no es crítica, el time-to-market es primordial y el coste por consulta es aceptable con el volumen previsto. El ajuste fino de modelos de código abierto (Llama 3 70B, Mistral 7B) se justifica económicamente cuando se procesan más de 1 millón de tokens al día (el coste de la API supera el de alojar GPU), se necesita una latencia de inferencia inferior a 500 ms, se requiere que los datos permanezcan on-premise por motivos de cumplimiento o se necesita un formato de salida consistente que la ingeniería de prompts por sí sola no logra de forma fiable.
Las técnicas de ajuste fino eficiente en parámetros LoRA y QLoRA reducen entre un 80 y un 90 % la memoria de GPU y el tiempo de entrenamiento necesarios para ajustar modelos grandes, lo que hace accesible el ajuste fino en una sola GPU A100 o en instancias spot de la nube. Diseñamos pipelines de ajuste fino, curamos conjuntos de datos de entrenamiento específicos del dominio y realizamos evaluaciones comparativas sistemáticas del modelo ajustado frente a la referencia de GPT-4 en su tarea concreta antes de comprometer la inversión en infraestructura.
Los LLM de código abierto (Llama 3, Mistral, Falcon, Qwen) le dan control total sobre el tratamiento de los datos, permiten despliegues offline y aislados de la red (air-gapped), eliminan los costes de API por token a escala y pueden personalizarse sin permiso del proveedor. Los modelos propietarios (GPT-4, Claude, Gemini Ultra) ofrecen un rendimiento de vanguardia en tareas de razonamiento complejo, no requieren gestionar infraestructura y permiten llegar antes al piloto.
La decisión depende de los requisitos de sensibilidad de sus datos, el volumen de inferencia, los benchmarks de rendimiento en sus tareas concretas y la capacidad de IA de su organización. En sanidad y servicios financieros, con requisitos estrictos de residencia de datos, los modelos de código abierto desplegados en infraestructura privada suelen ser obligatorios. Para los equipos de producto que crean con rapidez funcionalidades asistidas por IA, las API propietarias con límites de uso sólidos y rendimiento consistente suelen ser el punto de partida pragmático.
La inferencia en GPU de la nube (AWS SageMaker, GCP Vertex AI, Azure ML) es óptima para cargas variables, proyectos piloto y equipos sin experiencia en la gestión de clústeres de GPU, con costes de $2–8/hora por GPU A100. La inferencia on-premise resulta rentable cuando la utilización de la GPU supera de forma constante el 60 %, cuando los requisitos regulatorios prohíben enviar datos a proveedores de nube o cuando los objetivos de latencia de inferencia no se pueden cumplir con los viajes de ida y vuelta de una API en la nube.
Analizamos su perfil de carga, sus requisitos de residencia de datos y la proyección de costes a 3 años para recomendar la estrategia de infraestructura adecuada. Para la mayoría de las aplicaciones de IA empresarial, un enfoque híbrido (GPU en la nube para el entrenamiento de modelos y la inferencia por lotes, y instancias on-premise o de nube dedicada para el servicio en tiempo real de los modelos en producción) equilibra la eficiencia de costes con los requisitos de latencia y el cumplimiento normativo.
Los proyectos son de alcance cerrado y ajustados, todo incluido y presupuestados en USD. Una PoC / piloto parte de $2,900 (4–6 semanas); RAG sobre su base de conocimiento, desde $8,100; un agente de IA autónomo, desde $10,400; un modelo de ML en producción, desde $13,800. La cifra exacta depende de cuántos casos de uso entregue, la profundidad del corpus y el tamaño del conjunto de evaluación, los objetivos de latencia y el alcance de cumplimiento. Usted recibe el presupuesto desglosado al final del descubrimiento y lo aprueba antes de escribir una sola línea de código. No hay recargo por intermediación ni sobrecostes por herramientas, y los costes de la nube y de GPU corren por sus propias cuentas, de modo que usted conserva el control del coste.
Evaluamos los modelos candidatos con sus tareas reales antes de recomendar. Mistral / Claude / OpenAI con bloqueo de región en Bedrock, Vertex o Azure OpenAI (alojados en la UE para clientes de la UE y en EE. UU. para clientes de EE. UU.) y los modelos de código abierto en clústeres de la UE o de EE. UU. suelen superar a la opción evidente en coste y residencia de datos cuando se mide la latencia y la precisión de extremo a extremo.
En la mayoría de los casos de uso basados en conocimiento, la generación aumentada por recuperación con evaluaciones sólidas supera al ajuste fino. Solo pasamos al ajuste fino o a LoRA cuando el RAG no puede alcanzar los objetivos de estilo, latencia o coste, y medimos la mejora.
Versionado de prompts, evaluaciones deterministas, prompts de red team, filtros de salida y supervisión humana (human-in-the-loop) en los caminos de alto riesgo. Cada versión se entrega con un panel medible de calidad y seguridad, no con una simple comprobación a ojo.
La mayoría de los productos SaaS usan la IA en funciones de riesgo limitado o mínimo, que requieren avisos de transparencia y un registro básico. Le ayudamos a clasificar sus casos de uso, documentar el sistema y prepararse para las obligaciones de alto riesgo si la contratación, el crédito o la biometría entran en el alcance.
En los despliegues en EE. UU. mapeamos los controles con el NIST AI Risk Management Framework (Govern / Map / Measure / Manage), nos alineamos con las órdenes ejecutivas federales sobre IA y las expectativas de OMB M-24-10, y cribamos previamente los casos de uso frente a las leyes estatales: el Colorado AI Act (en vigor en 2026), NYC AEDT (Local Law 144), el NY AI Bill of Rights y las normas de toma de decisiones automatizadas de la CCPA / CPRA. Documentamos la clase de riesgo, los avisos de transparencia, la supervisión humana y las evaluaciones de impacto en una única ficha de sistema de IA por despliegue.
Sí. Usamos endpoints con bloqueo de región de Bedrock, Vertex, Azure OpenAI y Mistral: alojados en la UE para clientes de la UE (residencia de datos en la UE) y en EE. UU. para clientes de EE. UU. (opciones en EE. UU. bajo petición, BAA disponibles para cargas de trabajo aptas para HIPAA). Modelos abiertos autoalojados en clústeres de la UE o de EE. UU. cuando la residencia es crítica. Los DPA, los BAA y las configuraciones de retención cero forman parte de cada revisión de arquitectura.
La ingeniería de prompts (optimizar las instrucciones y los ejemplos en el contexto del LLM) debe ser siempre el primer enfoque: no requiere infraestructura, solo cuesta llamadas a la API y puede mejorar drásticamente la precisión con prompts de sistema bien diseñados y ejemplos few-shot. El RAG (generación aumentada por recuperación) es adecuado cuando el LLM debe responder preguntas a partir de una base de conocimiento grande que supera la ventana de contexto, cuando las respuestas deben anclarse en documentos concretos con citas o cuando el conocimiento debe actualizarse con frecuencia sin reentrenar el modelo. El ajuste fino se justifica cuando se necesita un formato de salida consistente que el modelo no sigue ni siquiera con instrucciones, cuando la terminología del dominio o los patrones de razonamiento requieren adaptación, o cuando la tarea está bien definida y se dispone de datos de entrenamiento etiquetados. En la práctica, muchas aplicaciones de IA en producción combinan las tres: un modelo ajustado con prompts de sistema optimizados, reforzado con RAG para la recuperación de conocimiento.
Las instancias con GPU A100 de 80 GB cuestan aproximadamente $2.50–$4.50/hora en AWS (ml.p4d.24xlarge), GCP (a2-highgpu) y Azure (NC A100 v4), o $1.50–$2.50/hora en instancias spot/interrumpibles. Las instancias H100 (AWS p5.48xlarge, GCP a3) cuestan $12–$18/hora bajo demanda, lo que refleja su ventaja de 3 veces en rendimiento de entrenamiento sobre la A100 para modelos transformer. Estimaciones de costes de entrenamiento: el ajuste fino de un modelo de 7B de parámetros (LoRA, 3 épocas sobre 50,000 ejemplos) suele tardar de 2 a 4 horas en una sola A100 ($10–$20 en total); un ajuste fino completo de un modelo de 70B de parámetros en 8xA100 puede costar $200–$500; preentrenar desde cero un modelo de 1B de parámetros lleva de días a semanas en 32–128 GPU ($5,000–$50,000+). Entregamos estimaciones de costes de entrenamiento antes de definir el alcance del proyecto para asegurar que el presupuesto de GPU se planifique junto con los costes de ingeniería.
La mitigación de la alucinación en aplicaciones empresariales requiere un enfoque de defensa en profundidad. Primero, usar RAG para anclar el LLM en documentos recuperados: los modelos alucinan mucho menos cuando pueden citar una fuente en lugar de generar a partir de la memoria paramétrica. Segundo, implementar un análisis de salidas estructuradas (validación de esquemas JSON, modelos Pydantic) que obligue al modelo a producir datos estructurados verificables en lugar de texto libre, más difícil de comprobar. Tercero, añadir una capa de verificación de hechos para las salidas de alto riesgo: una segunda llamada a un LLM que verifique las afirmaciones frente a las fuentes recuperadas, o una verificación programática de las afirmaciones factuales (fechas, números, nombres) frente a una base de conocimiento. Cuarto, implementar umbrales de confianza que escalen a revisión humana cuando el modelo señale incertidumbre mediante puntuaciones de confianza bajas o respuestas explícitas de «no lo sé». Por último, definir límites de alcance claros: la alucinación es un riesgo mayor cuando se plantean al modelo preguntas ajenas a su distribución de entrenamiento; restrinja el caso de uso a tareas en las que el modelo haya demostrado precisión en la evaluación.
El Reglamento de IA de la UE (en vigor desde agosto de 2024, con las disposiciones de alto riesgo aplicables desde agosto de 2026) define los «sistemas de IA de alto riesgo» en las categorías del anexo III, entre ellas la IA usada en puntuación crediticia, decisiones de empleo, identificación biométrica, evaluación educativa y productos sanitarios. Para la IA de alto riesgo, el Reglamento exige: documentación técnica (especificaciones de diseño, descripción de los datos de entrenamiento, resultados de validación), evaluación de la conformidad antes de su comercialización, mecanismos de supervisión humana que permitan a una persona anular o desactivar la IA, requisitos de robustez y precisión con monitorización continua, registro en la base de datos de IA de la UE (para los proveedores) y vigilancia poscomercialización con obligaciones de notificación de incidentes. Los proveedores de IA de alto riesgo también deben implantar sistemas de gestión de la calidad similares a ISO 9001/13485. Las prácticas de IA prohibidas (identificación biométrica remota en tiempo real en espacios públicos, puntuación social) están prohibidas desde febrero de 2025. Ofrecemos evaluaciones de preparación para el Reglamento de IA de la UE, apoyo en la documentación técnica e implementación de los controles de supervisión humana exigidos para los sistemas de IA desplegados en los mercados de la UE.
La deriva de modelos se produce cuando la distribución estadística de los datos de entrada en producción se aleja de la de los datos de entrenamiento (deriva de variables) o cuando cambia la relación entre las entradas y la variable objetivo (deriva de concepto). La detección requiere monitorizar de forma continua las distribuciones de las predicciones (¿siguen las puntuaciones de fraude distribuidas normalmente en torno a la media histórica?), las distribuciones de las variables (¿está cambiando el importe medio de las transacciones?) y las métricas de resultados de negocio (¿está bajando la exhaustividad de la detección de fraude?). Implementamos Evidently para la monitorización de deriva de código abierto, configuramos alertas cuando el Population Stability Index (PSI) supera 0.2 en las variables clave y establecemos disparadores de reentrenamiento automático cuando las métricas de rendimiento del modelo caen por debajo de umbrales definidos. Estrategia de respuesta: ante la deriva de variables, reentrenar con una ventana móvil de datos recientes; ante la deriva de concepto, investigar si el entorno de negocio ha cambiado lo suficiente como para requerir redefinir la variable objetivo o reentrenar con nuevas etiquetas. Construimos pipelines de reentrenamiento automatizados con evaluación champion-challenger que exige que el nuevo modelo supere al modelo en producción en una prueba de reserva antes de la promoción automática.
Guías prácticas sobre IA, aprendizaje automático e ingeniería de datos para equipos empresariales.
Cuéntenos algunos detalles y un consultor sénior le responderá en un día hábil.