Elegir el índice adecuado
¿HNSW o IVFFlat? Elegir mal el tipo de índice y sus parámetros (m, ef_construction, lists, probes) supone construcciones lentas, memoria inflada o un recall deficiente.

pgvector PostgreSQL HNSW Vector Search
Como empresa de desarrollo con pgvector, ayudamos a equipos de EE. UU. y la UE a añadir a PostgreSQL una búsqueda por similitud vectorial de nivel de producción con la extensión pgvector, sin una base de datos vectorial aparte que aprovisionar, proteger o pagar. Sus embeddings viven junto a las filas relacionales que describen, de modo que las consultas híbridas, los joins y el control de acceso se quedan en un motor que ya opera. Desde el ajuste de índices hasta backends RAG completos, hacemos que pgvector sea rápido, preciso y fácil de mantener.
Como empresa de desarrollo con pgvector, ayudamos a equipos de EE. UU. y la UE a añadir a PostgreSQL una búsqueda por similitud vectorial de nivel de producción con la extensión pgvector, sin una base de datos vectorial aparte que aprovisionar, proteger o pagar. Sus embeddings viven junto a las filas relacionales que describen, de modo que las consultas híbridas, los joins y el control de acceso se quedan en un motor que ya opera. Desde el ajuste de índices hasta backends RAG completos, hacemos que pgvector sea rápido, preciso y fácil de mantener.
Retos
¿HNSW o IVFFlat? Elegir mal el tipo de índice y sus parámetros (m, ef_construction, lists, probes) supone construcciones lentas, memoria inflada o un recall deficiente.
La búsqueda aproximada cambia precisión por velocidad. Ajustar ese equilibrio a sus datos y a su carga de consultas no es evidente y es fácil equivocarse.
Millones de vectores de muchas dimensiones tensan la memoria y los tiempos de construcción de índices; sin una estrategia de particionado y dimensionado, el rendimiento se desploma.
Las consultas reales combinan similitud vectorial con filtros SQL, joins y búsqueda de texto completo. Los planes ingenuos escanean todo e ignoran sus índices.
Cambiar el modelo de embeddings o su dimensión invalida los vectores almacenados, y la deriva silenciosa del modelo degrada poco a poco la calidad de la recuperación.
Los embeddings deben actualizarse cuando cambian las filas de origen. Sin un pipeline fiable, el índice se queda obsoleto y devuelve resultados erróneos.
Soluciones
Instalamos y configuramos pgvector, elegimos HNSW o IVFFlat según la carga de trabajo y ajustamos los parámetros del índice con sus datos reales para lograr el recall y la velocidad que necesita.
Escribimos consultas que combinan la búsqueda por similitud con filtros SQL, joins y texto completo, con planes de consulta que realmente usan sus índices.
Construimos backends de generación aumentada por recuperación (chunking, embeddings, recuperación y reranking) íntegramente sobre su PostgreSQL con LlamaIndex o LangChain.
Dimensionamos la memoria, particionamos las tablas grandes y medimos la construcción de índices para que la búsqueda vectorial siga siendo rápida a medida que crece su corpus.
Construimos pipelines que vuelven a calcular los embeddings y a indexar automáticamente cuando cambian las filas de origen, manteniendo los vectores coherentes con sus datos.
Migramos cargas de bases de datos vectoriales independientes como Pinecone o Qdrant a pgvector y reducimos dos almacenes de datos a uno.
Stack
pgvector, PostgreSQL, índices HNSW e IVFFlat, embeddings, Supabase/Aurora/Cloud SQL, SQLAlchemy, LlamaIndex/LangChain, Docker.
Cumplimiento
RGPD · residencia de datos · preparado para HIPAA · SOC 2
Casos
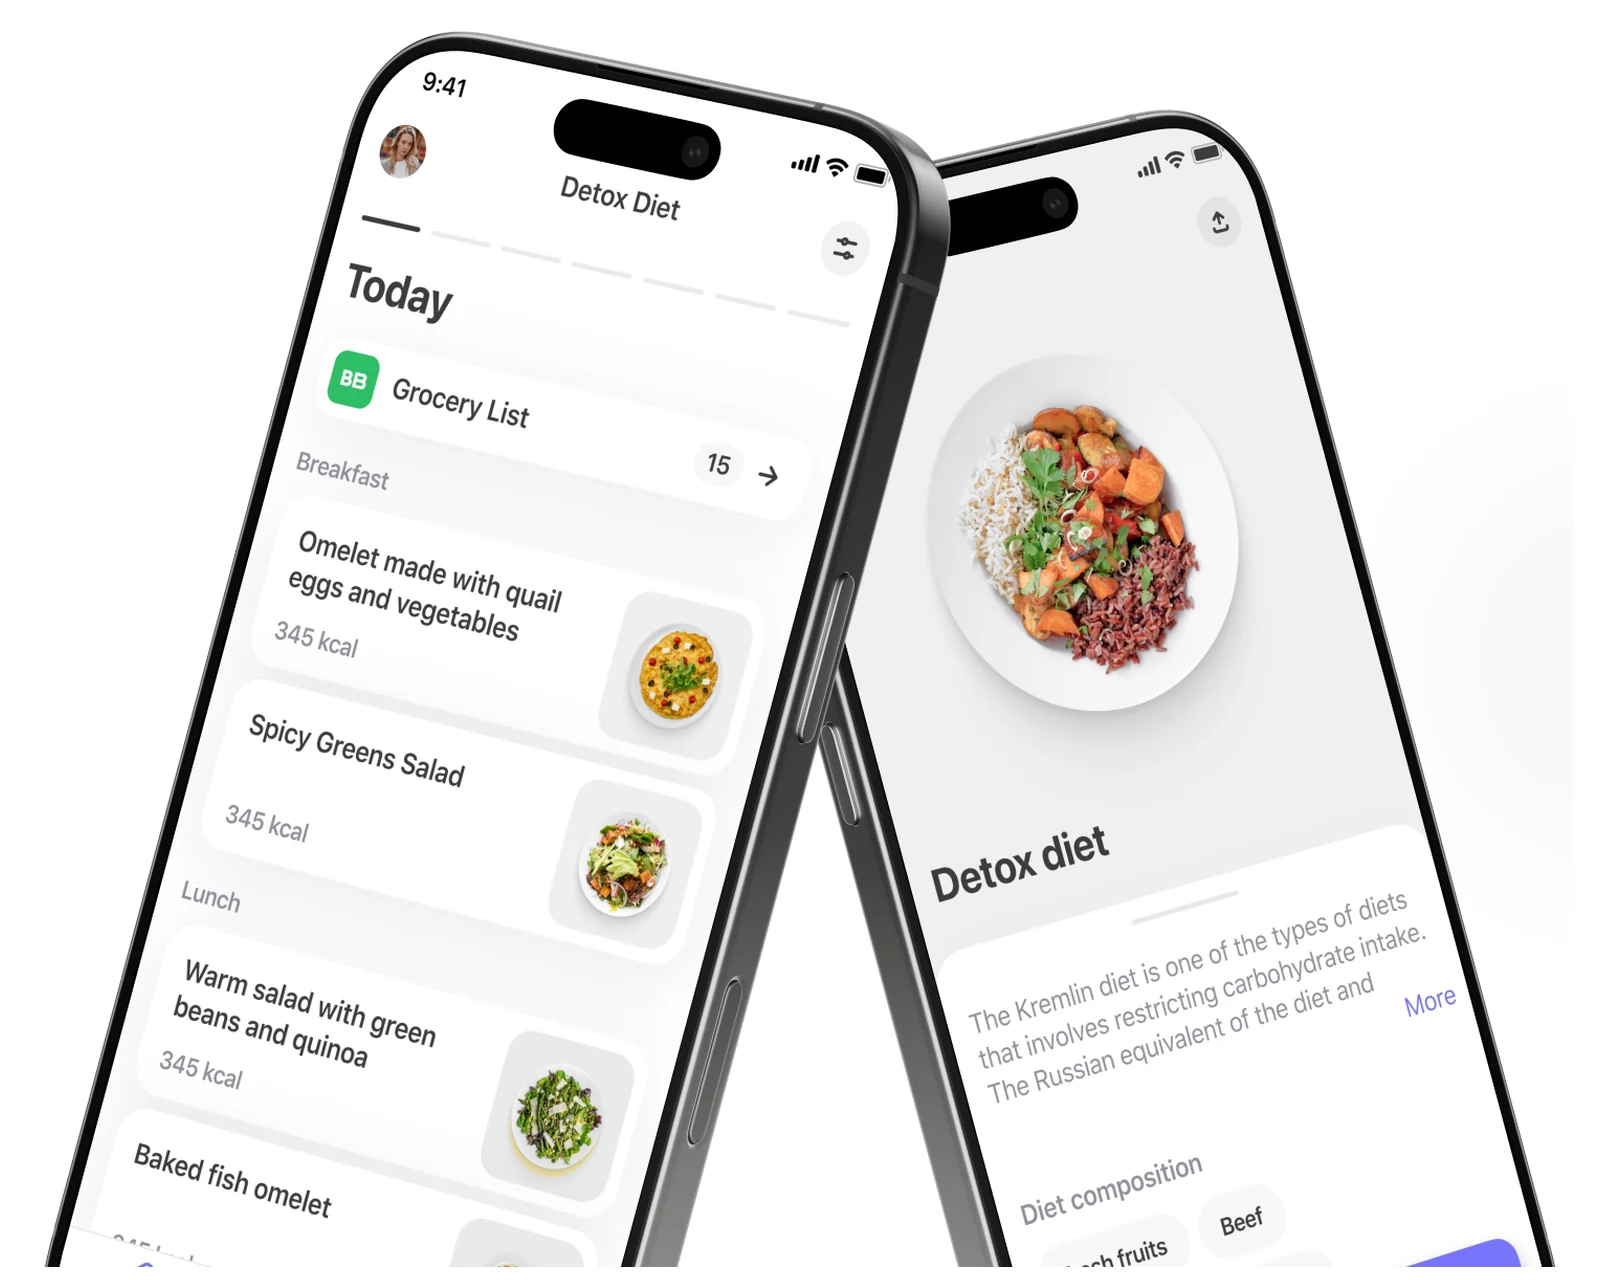
App multiplataforma de dieta y planificación de comidas en Flutter: motor de calorías, biblioteca de recetas, plan semanal de comidas y pedido de la compra.
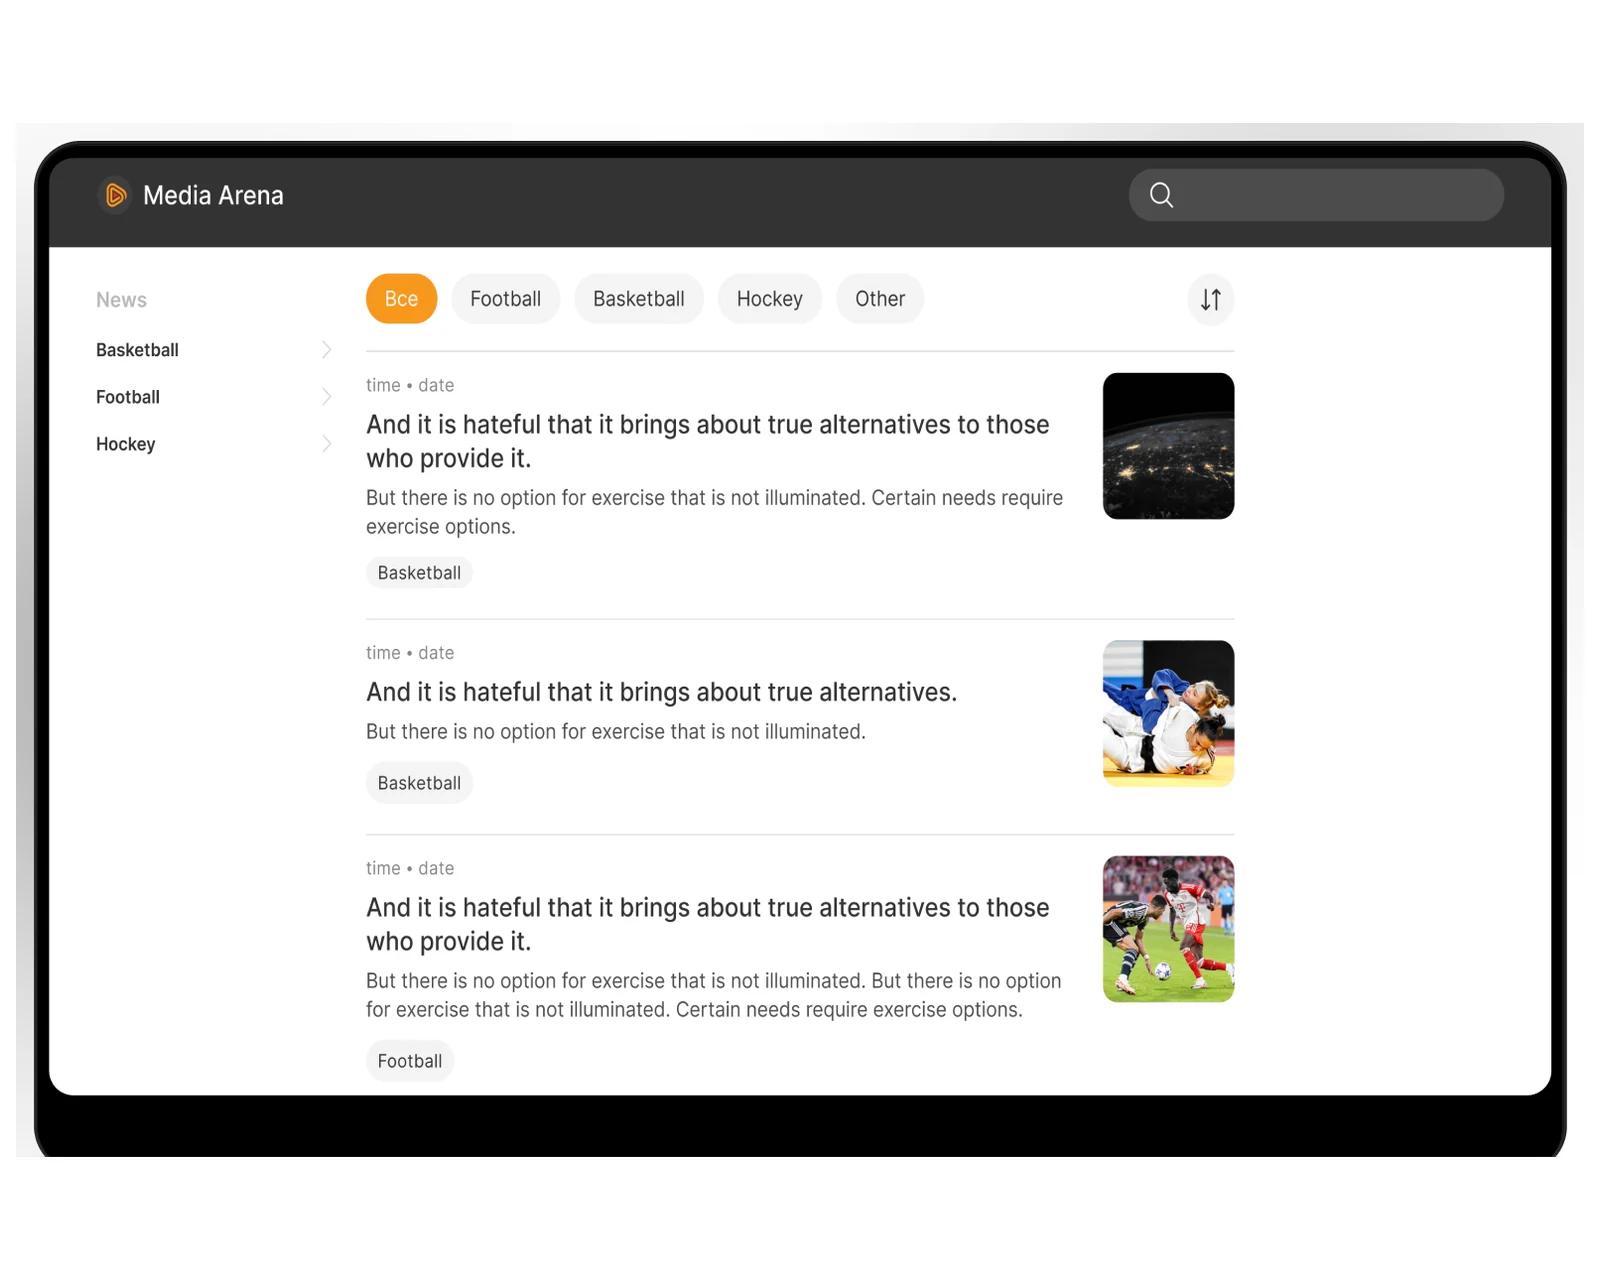
App multiplataforma de noticias deportivas y portal web: CMS mediante un bot de Telegram en lugar de un panel de administración a medida y un pipeline de publicación en Markdown.
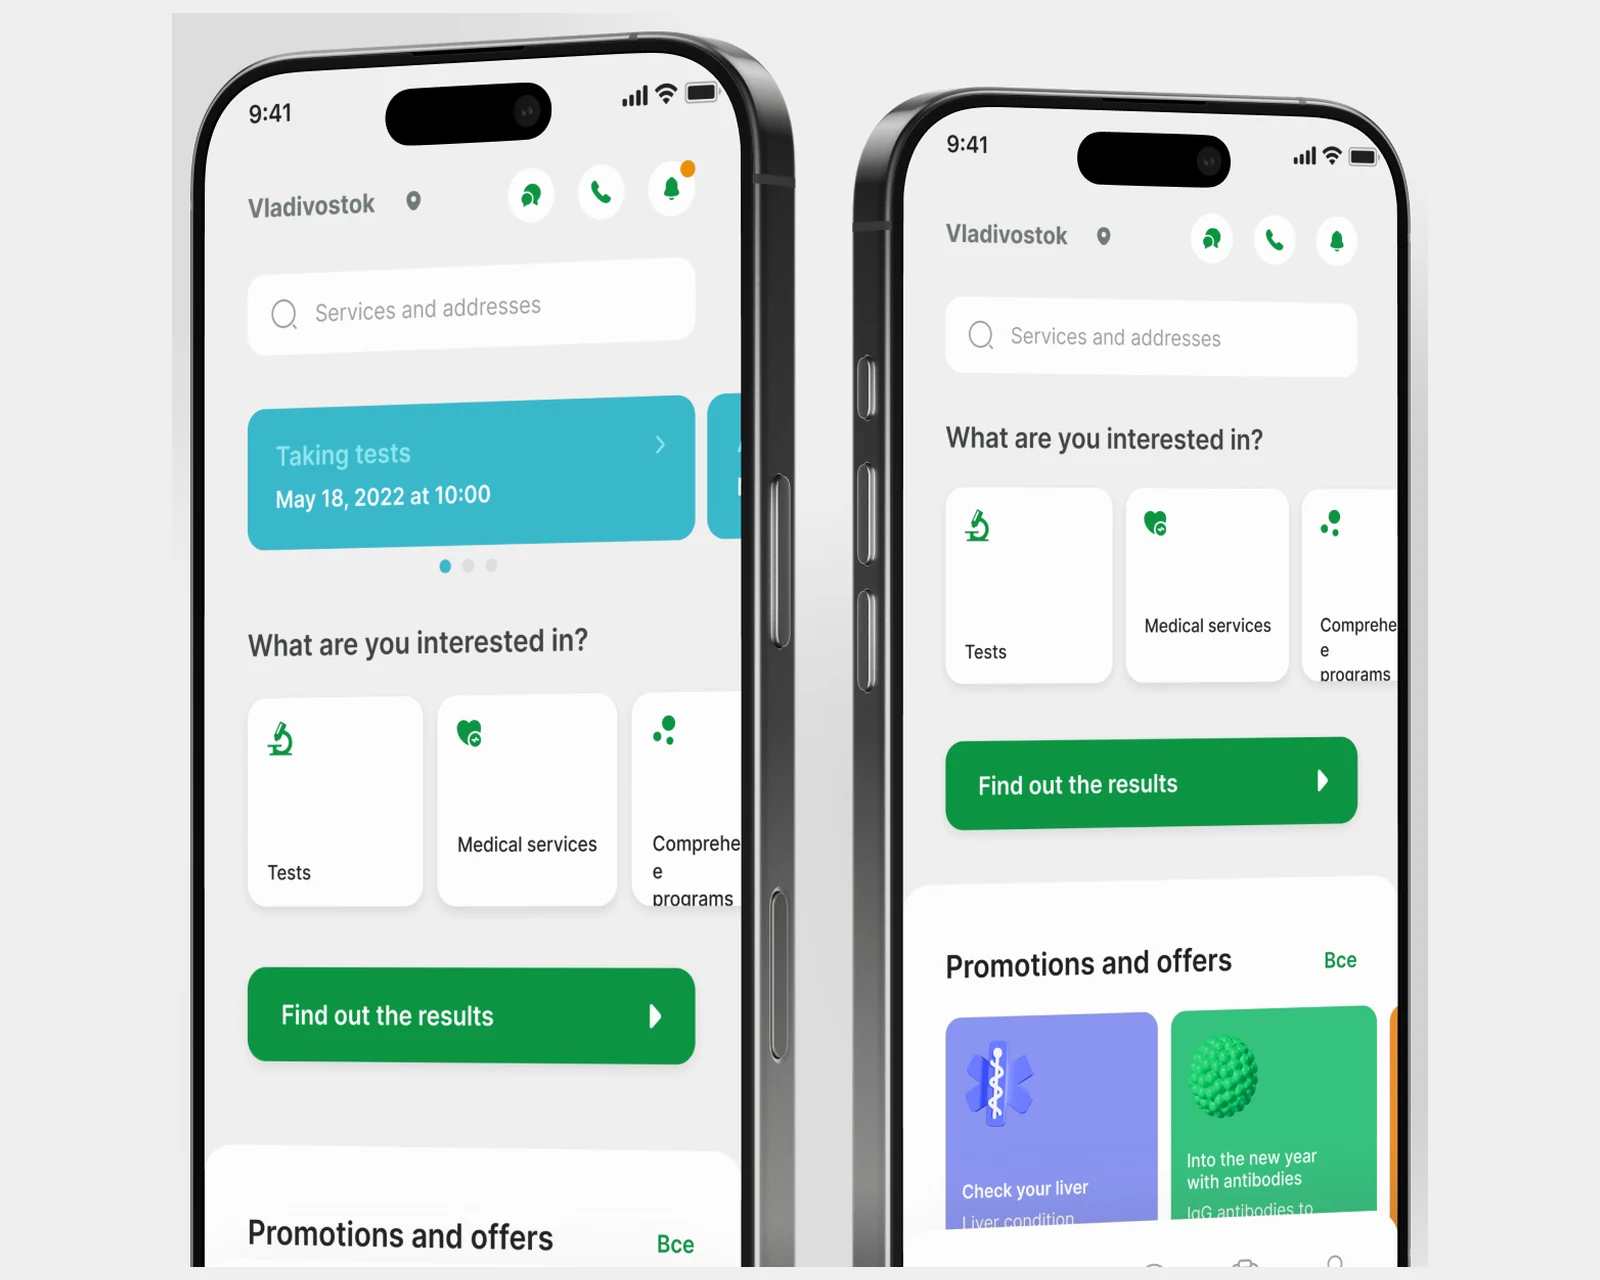
App para pacientes de una red de laboratorios en 40 ciudades: reserva de citas, resultados digitales, más de 2,500 pruebas e integraciones de agenda y contabilidad.
Por qué YuSMP
Sus vectores se quedan en el PostgreSQL que ya ejecuta, respalda y protege: sin una base de datos vectorial aparte que aprovisionar, monitorizar o pagar, y con un solo motor que dominar.
Ajustamos los índices, la memoria y los planes de consulta con sus datos y su carga reales, no con los valores por defecto, para que el recall y la latencia cumplan sus objetivos en producción.
Para los clientes de EE. UU. y la UE mantenemos los embeddings de datos regulados dentro de su región conforme, con los controles de acceso, el registro y las vías de supresión que esperan los auditores.
Preguntas frecuentes
Si sus datos ya viven en PostgreSQL, pgvector permite mantener los embeddings a su lado: las consultas híbridas, los joins, las transacciones, las copias de seguridad y el control de acceso se quedan en un solo motor. Eso elimina un almacén de datos entero que operar, proteger y pagar. Las bases de datos vectoriales dedicadas solo se justifican a una escala muy grande o con funciones especializadas, pero la mayoría de los equipos llegan a esos límites más tarde de lo que esperan.
HNSW ofrece un recall alto y consultas rápidas con construcciones más lentas y que consumen más memoria, y es la opción por defecto para la mayoría de las cargas de mucha lectura. IVFFlat se construye más rápido y usa menos memoria, pero necesita lists y probes ajustados y es más sensible a la distribución de los datos. Medimos ambos con sus datos antes de comprometernos.
pgvector gestiona con holgura millones de vectores en una instancia bien dimensionada, y decenas de millones con particionado y un ajuste cuidadoso de la memoria. Más allá, el tiempo de construcción del índice, la RAM y la latencia de las consultas pasan a ser las limitaciones; medimos su corpus para encontrar el techo real antes de que lo alcance.
Sí: es una de las razones principales para usar pgvector. Escribimos consultas híbridas que combinan la búsqueda por similitud con filtros WHERE, joins y búsqueda de texto completo, y ajustamos el plan de consulta para que tanto el índice vectorial como sus índices relacionales se usen de forma eficiente.
Ajustamos los parámetros del índice (ef_search en HNSW, probes en IVFFlat) y medimos el recall frente a una línea base de búsqueda exacta con sus datos. Usted fija el objetivo (por ejemplo, un recall del 95 % dentro de un presupuesto de latencia) y nosotros ajustamos para cumplirlo y después documentamos la configuración.
Construimos un pipeline de embeddings que detecta las filas de origen modificadas (mediante triggers, change data capture o una cola), recalcula sus embeddings y actualiza el índice, de modo que sus vectores nunca se desincronicen de las filas que describen.
Cuando la construcción de índices, la RAM o la latencia de las consultas dejan de cumplir los objetivos incluso tras el ajuste y el particionado, o cuando necesita funciones que pgvector no tiene. Le diremos con franqueza cuándo llega ese momento y planificaremos una migración a una base de datos vectorial dedicada, reutilizando el pipeline de embeddings que ya construimos.
Respuesta en 1 día hábil. NDA a petición.
Cuéntenos algunos detalles y un consultor sénior le responderá en un día hábil.