Confusión entre GIL y async
Mezclar threading, multiprocessing y asyncio sin un modelo mental claro produce interbloqueos y un rendimiento degradado. Diseñamos las estrategias de concurrencia de forma explícita y las documentamos.

FastAPI LangChain Reglamento de IA de la UE (AI Act) GDPR
Como empresa de desarrollo Python, lo tenemos por defecto en los proyectos de IA, ML y datos: FastAPI para gateways de inferencia de baja latencia, LangChain y LlamaIndex para RAG sobre corpus privados, PyTorch para el fine-tuning y Pydantic para APIs con contrato primero. Todo proyecto de IA incluye desde el primer día un documento de clasificación de riesgo del Reglamento de IA de la UE.
Ofrecemos ingeniería con Python para cuatro perfiles de cliente: equipos de producto de IA y LLM que crean pipelines de RAG, agentes y servicios de inferencia; equipos de ingeniería de datos que orquestan ETL desde bases de datos operativas hasta almacenes analíticos; equipos SaaS que eligen FastAPI para APIs de alto rendimiento o Django para portales con mucha administración; y sectores regulados —healthtech, fintech, legaltech— donde el cumplimiento del Reglamento de IA de la UE, el tratamiento de datos según el RGPD y las decisiones explicables de los modelos son requisitos de entrega.
Retos
Mezclar threading, multiprocessing y asyncio sin un modelo mental claro produce interbloqueos y un rendimiento degradado. Diseñamos las estrategias de concurrencia de forma explícita y las documentamos.
Las dependencias transitivas en conflicto rompen los despliegues sin avisar. Usamos Poetry para un bloqueo determinista, compilaciones Docker multietapa y un mirror privado de PyPI.
Los prompts de los usuarios suelen contener nombres, correos electrónicos y datos de salud. Implementamos el enmascaramiento de datos personales con presidio y la configuración de endpoints sin retención de datos antes de que cualquier prompt salga del perímetro.
La latencia de arranque en frío y de generación de tokens se dispara con solicitudes concurrentes. Agrupamos en lotes, hacemos streaming con SSE, implementamos caché semántica y desplegamos workers FastAPI asíncronos.
Los cambios en los prompts se publican sin comprobaciones de regresión y degradan las salidas sin que nadie lo note. Construimos arneses de evaluación basados en RAGAS antes de que el primer prompt llegue a producción.
pgvector, Qdrant, Pinecone, Weaviate: los equipos se retrasan porque el panorama está fragmentado. Elegimos según su infraestructura actual, sus requisitos de consistencia y sus patrones de consulta.
Soluciones
Pipelines de generación aumentada por recuperación sobre documentos internos, bases de conocimiento y bases de datos, con atribución de fuentes y controles de alucinaciones.
Servicios FastAPI que envuelven OpenAI, Anthropic o modelos autoalojados, con streaming, caché, limitación de tasa y respaldo entre varios proveedores.
Pipelines asíncronos con Celery o Dagster que trasladan datos de fuentes operativas a esquemas analíticos de Snowflake, BigQuery o PostgreSQL.
Aplicaciones Django full-stack con administración a medida, tareas en segundo plano con Celery y PostgreSQL, para CMS, puestos de trabajo de operadores y herramientas internas.
Entrenamiento y validación de modelos con Scikit-learn y PyTorch, seguimiento de experimentos con MLflow y servicio con FastAPI con enrutamiento A/B.
Puentes gRPC y REST que conectan los servicios de IA en Python con backends de producto en Node.js o .NET, con clientes generados y pruebas de contrato.
Stack
Python 3.12, FastAPI, Pydantic v2, SQLAlchemy 2, Celery, LangChain, LlamaIndex, PyTorch, MLflow, Ragas, Poetry, Docker, Kubernetes.
Cumplimiento
Alineado con el RGPD · preparado para el Reglamento de IA de la UE · apto para SOC 2 · apto para HIPAA · CCPA contemplada
Común: OWASP LLM Top 10, refuerzo frente a la inyección de prompts y SBOM en cada compilación.
Casos

Plataforma social en producción, en App Store y Google Play, activa en EE. UU. y la UE, con Radar geolocalizado, mensajería cifrada y economía virtual.

Clientes nativos de firma electrónica para iOS y Android con un CRM en Symfony + React para un despacho de abogados internacional: onboarding con KYC y una cadena de evidencias defendible para asuntos de EE. UU. y la UE.
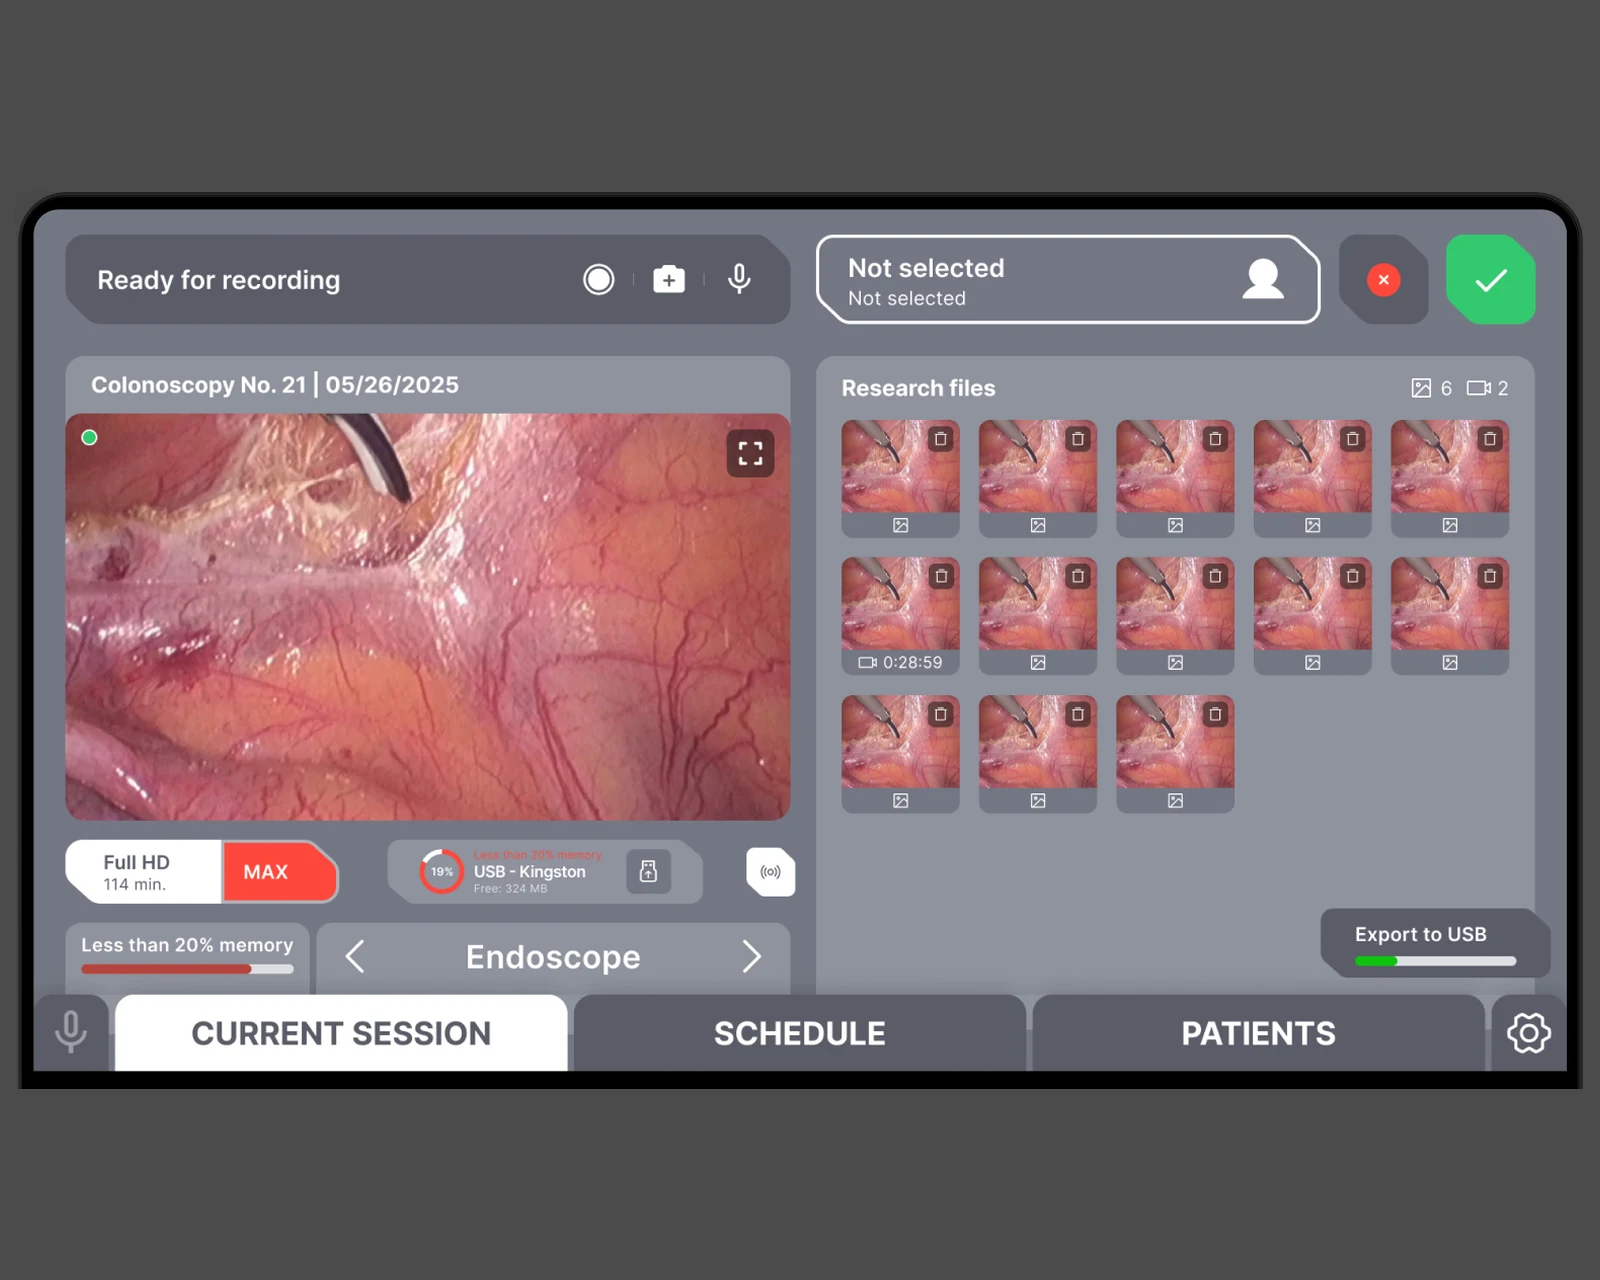
Grabación de endoscopias pensada para tabletas, historiales de pacientes y exportación DICOM/HL7, con Laravel + React y captura WebRTC en el navegador para clínicas de EE. UU. y la UE.
Por qué YuSMP
Integramos OpenAI, Anthropic, Mistral y modelos autoalojados mediante un router unificado, para que pueda cambiar de proveedor sin reescribir la lógica de la aplicación.
Ningún prompt se despliega sin una evaluación de regresión. Las métricas RAGAS, las comparaciones con conjuntos de referencia y los benchmarks específicos del negocio se ejecutan en CI en cada merge.
Toda colaboración de IA empieza con un taller de clasificación de riesgos. Los sistemas de alto riesgo reciben planes de evaluación de la conformidad; los de riesgo limitado, plantillas de información de transparencia.
Preguntas frecuentes
Realizamos un taller estructurado que abarca la finalidad prevista, la población de usuarios, la autonomía en la toma de decisiones y el sector para asignar el nivel de riesgo correcto (inaceptable, alto, limitado o mínimo). Los sistemas de alto riesgo reciben un plan completo de evaluación de la conformidad; los de riesgo limitado, los avisos de transparencia. Documentamos la clasificación en su documentación técnica.
FastAPI para APIs y gateways de inferencia donde importan la latencia y el rendimiento asíncrono. Django para aplicaciones con mucha administración, funciones de CMS y equipos que prefieren las convenciones de «baterías incluidas». A menudo los combinamos: Django para la autenticación y la administración, y FastAPI para los endpoints críticos para el rendimiento.
Implementamos la detección y el enmascaramiento de datos personales (presidio o NER a medida) antes de que los prompts salgan del perímetro, usamos endpoints de API sin retención de datos cuando existen (OpenAI ZDR, Azure OpenAI con configuración sin registro) y mantenemos los datos personales de la UE en endpoints de la región de la UE.
RAG es lo adecuado para corpus dinámicos y actualizados con frecuencia en los que importa la atribución de fuentes: documentos legales, catálogos de productos, bases de conocimiento de soporte. El fine-tuning es lo adecuado para lograr un tono, un formato o un vocabulario de dominio constantes que RAG por sí solo no puede producir de forma fiable. Recomendamos empezar por RAG y evaluar el fine-tuning solo cuando RAG se estanque.
Construimos un arnés de evaluación antes de escribir el primer prompt: preguntas y respuestas de referencia (golden set), métricas RAGAS para RAG (fidelidad, relevancia, recall del contexto) y métricas de negocio a medida. Cada cambio de modelo o de prompt ejecuta la evaluación antes del merge.
pgvector sobre PostgreSQL para equipos que ya usan Postgres: sin infraestructura nueva, con consistencia transaccional y joins SQL. Qdrant para despliegues independientes que necesitan búsqueda vectorial filtrada a gran escala. Tenemos experiencia en producción con ambos.
Poetry para el bloqueo de dependencias, compilaciones Docker multietapa para mantener las imágenes ligeras y un mirror privado de PyPI para entornos aislados de la red (air-gapped). Fijamos las dependencias directas y transitivas y ejecutamos pip-audit en el CI.
Aplicamos esquemas de salida estructurada (modo JSON / Pydantic), separamos el contenido del sistema y del usuario con delimitadores claros, validamos las salidas del modelo con los esquemas esperados y ejecutamos conjuntos de pruebas de inyección adversarial en el CI. Ninguna técnica es completa por sí sola: defensa en profundidad.
Respuesta en 1 día hábil. NDA a petición.
Cuéntenos algunos detalles y un consultor sénior le responderá en un día hábil.