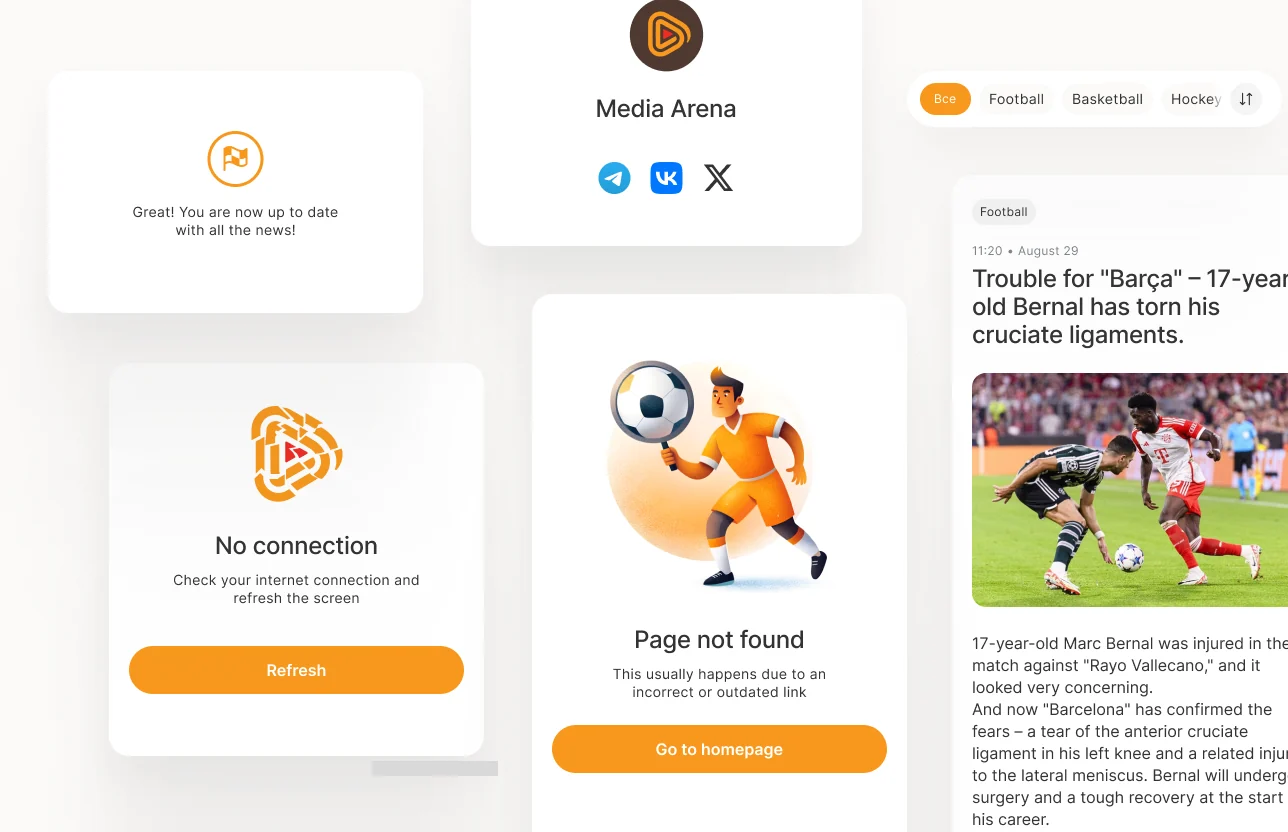
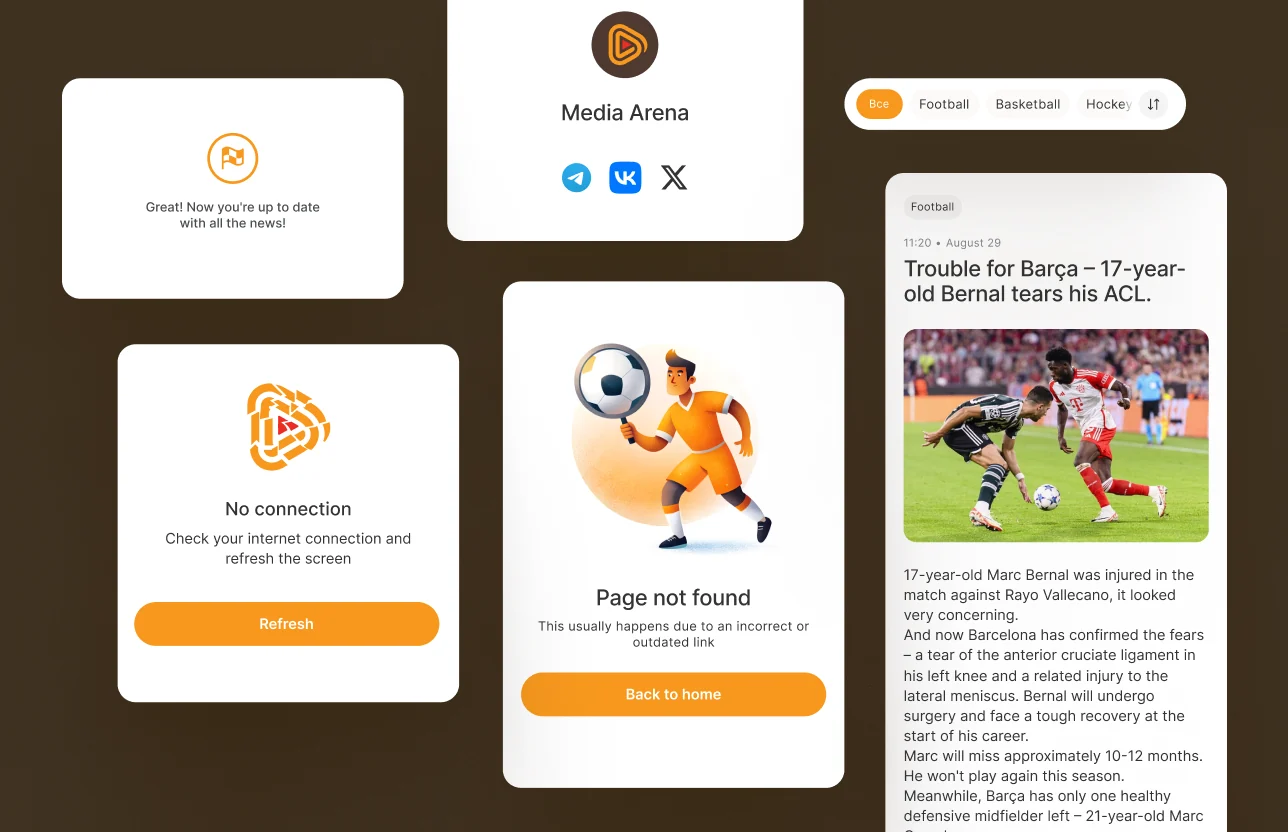
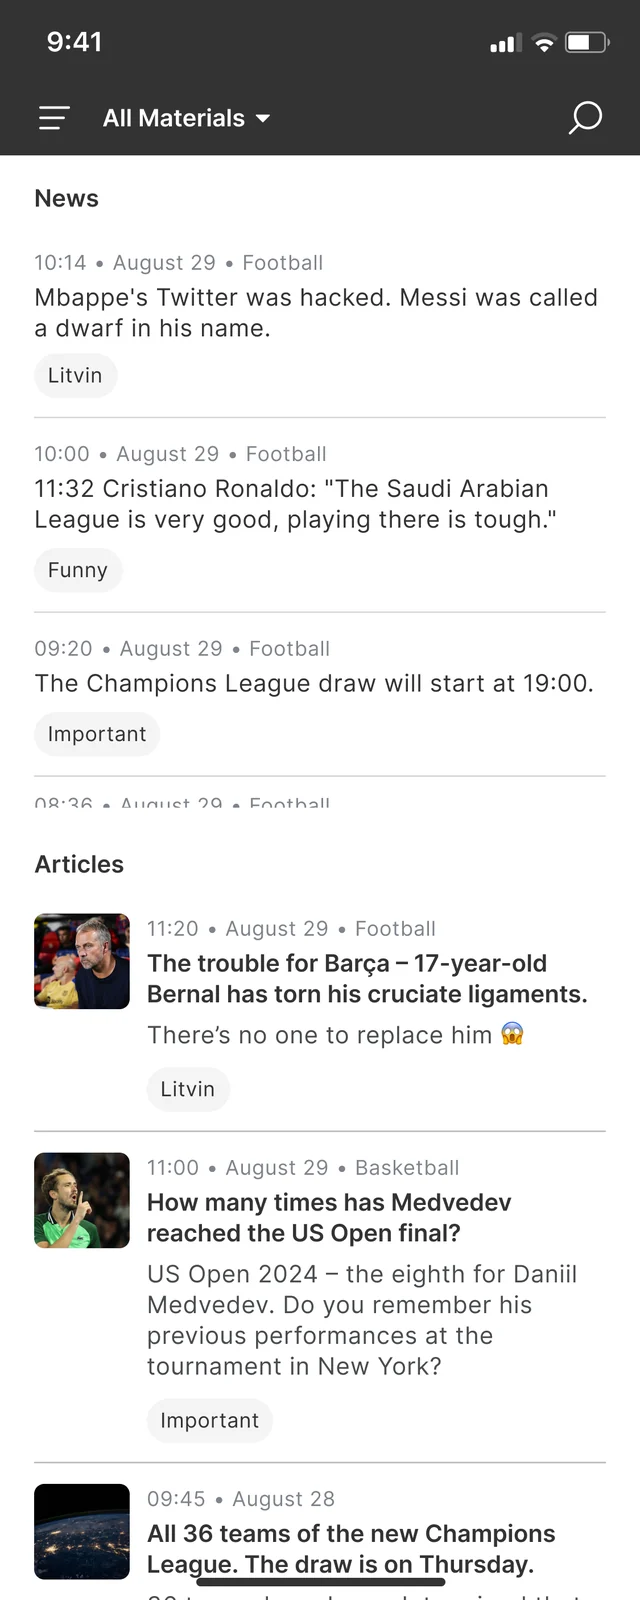
El pipeline editorial es el corazón del desarrollo. Los editores redactan borradores en Telegram, el bot valida la estructura (orden de los encabezados, presencia de texto alternativo en las imágenes, integridad de los enlaces) y, al publicar, un registro versionado del artículo llega a PostgreSQL. La entrada en Markdown 2.0 se analiza una vez en un árbol de sintaxis abstracta y luego se proyecta a HTML para el portal web, a Markdown 1.0 para cualquier feed descendente y a las formas de cadenas con atributos que consumen iOS y Android. Las imágenes subidas pasan por un pipeline WebP con variantes de tamaño y generación previa de tarjetas Open Graph y Twitter, de modo que un contenido compartido en redes sociales de Estados Unidos y la Unión Europea se muestra correctamente al pegarlo por primera vez.
La privacidad del lector está integrada en la plataforma desde el primer día. La analítica es anónima por defecto, la aceptación de notificaciones push es granular y el flujo de consentimiento depende de la región: los usuarios de la Unión Europea reciben la pantalla granular del RGPD, con interruptores separados para la analítica de producto; los usuarios de California reciben en el mismo flujo el aviso de la CCPA / CPRA, «No vender ni compartir mi información personal». Las acciones editoriales se escriben en un registro de auditoría que admite historial de correcciones, seguimiento de retractaciones y revisión de roles por usuario sin exponer la identidad del lector. El resultado es una superficie editorial que resiste el escrutinio en EE. UU. y la UE sin tener que adaptar el cumplimiento más tarde.
Enfoque de cumplimiento: alineado con el RGPD · preparado para ISO 27001 · SOC 2 Type II en curso · apto para HIPAA · CCPA contemplada.