Desajuste entre entrenamiento e inferencia
Las features calculadas de forma distinta en los notebooks y en producción degradan en silencio la precisión en vivo, y la deriva es difícil de detectar si no hay transformaciones compartidas.

PyTorch Deep learning MLOps ONNX
Nuestro desarrollo con PyTorch crea, entrena y publica modelos que resisten el contacto con la producción. Desde los pipelines de datos y el entrenamiento distribuido en GPU hasta las APIs de inferencia de baja latencia, nuestros ingenieros cubren todo el ciclo de vida. Los equipos de EE. UU. y la UE confían en nosotros para convertir notebooks de investigación en servicios gobernados y monitorizados, y no solo en experimentos puntuales. Cada despliegue es reproducible, observable y conforme a la normativa desde el diseño.
Nuestro desarrollo con PyTorch crea, entrena y publica modelos que resisten el contacto con la producción. Desde los pipelines de datos y el entrenamiento distribuido en GPU hasta las APIs de inferencia de baja latencia, nuestros ingenieros cubren todo el ciclo de vida. Los equipos de EE. UU. y la UE confían en nosotros para convertir notebooks de investigación en servicios gobernados y monitorizados, y no solo en experimentos puntuales. Cada despliegue es reproducible, observable y conforme a la normativa desde el diseño.
Retos
Las features calculadas de forma distinta en los notebooks y en producción degradan en silencio la precisión en vivo, y la deriva es difícil de detectar si no hay transformaciones compartidas.
Las ejecuciones sin registrar, las semillas aleatorias y las versiones de los datos hacen imposible reproducir o auditar los resultados meses después.
Las GPU inactivas, las instancias sobredimensionadas y el entrenamiento distribuido ingenuo queman presupuesto sin hacer ruido, mientras los trabajos siguen tardando demasiado.
Sin métricas en vivo ni detección de deriva, los modelos se deterioran frente a datos cambiantes y nadie lo nota hasta que se quejan los usuarios.
Los modelos de nivel de investigación suelen ser demasiado pesados para servirse con la latencia y el coste objetivo sin exportación a ONNX, cuantización o destilación.
Los datos personales se filtran en los corpus de entrenamiento, incumplen el RGPD y la CCPA y generan modelos que no pueden atender solicitudes de supresión.
Soluciones
Creamos pipelines de entrenamiento reproducibles con PyTorch y Lightning, con transformaciones de features compartidas, compatibilidad con GPU múltiple distribuida mediante Ray y datos versionados.
MLflow registra parámetros, métricas, artefactos y linaje de cada ejecución, de modo que los resultados son comparables, reproducibles y están listos para auditoría.
Exponemos los modelos con TorchServe o FastAPI, con batching, autoescalado y health checks, tras endpoints limpios y versionados.
La exportación a ONNX, la cuantización y la destilación reducen el tamaño y la latencia de los modelos, lo que permite alcanzar los objetivos de coste y de SLA en CPU o GPU.
El reentrenamiento automatizado, las puertas de evaluación y el despliegue se ejecutan a través de CI/CD, con monitorización en vivo de la deriva, la latencia y la calidad en producción.
Registramos la procedencia de los conjuntos de datos, imponemos controles sobre los datos personales (PII) e integramos la supresión en los pipelines para que los modelos sigan siendo conformes con la normativa de la UE y de EE. UU.
Stack
PyTorch, Lightning, TorchServe, ONNX, CUDA, Hugging Face, MLflow, Ray, FastAPI, Docker, Kubernetes.
Cumplimiento
Reglamento de IA de la UE · datos de entrenamiento y RGPD · gobernanza de modelos · SOC 2
Casos
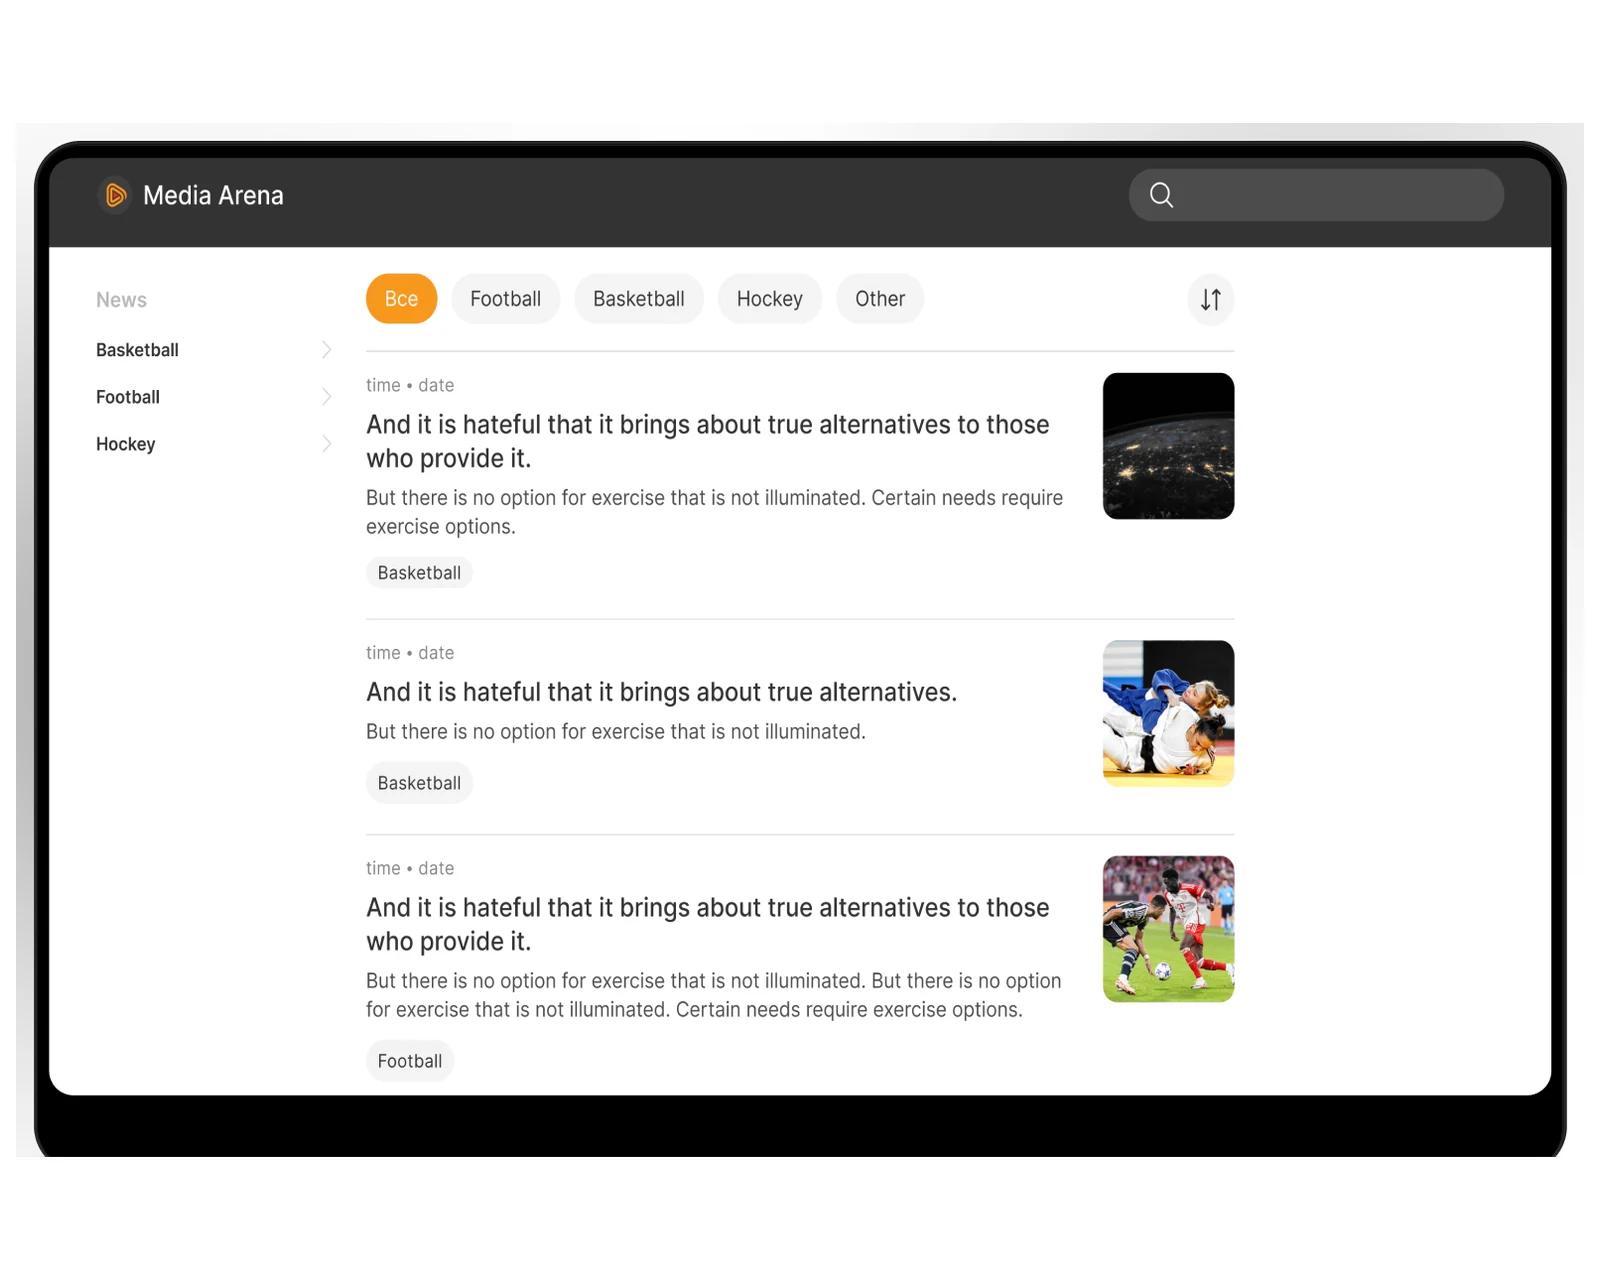
App multiplataforma de noticias deportivas y portal web: CMS mediante un bot de Telegram en lugar de un panel de administración a medida y un pipeline de publicación en Markdown.
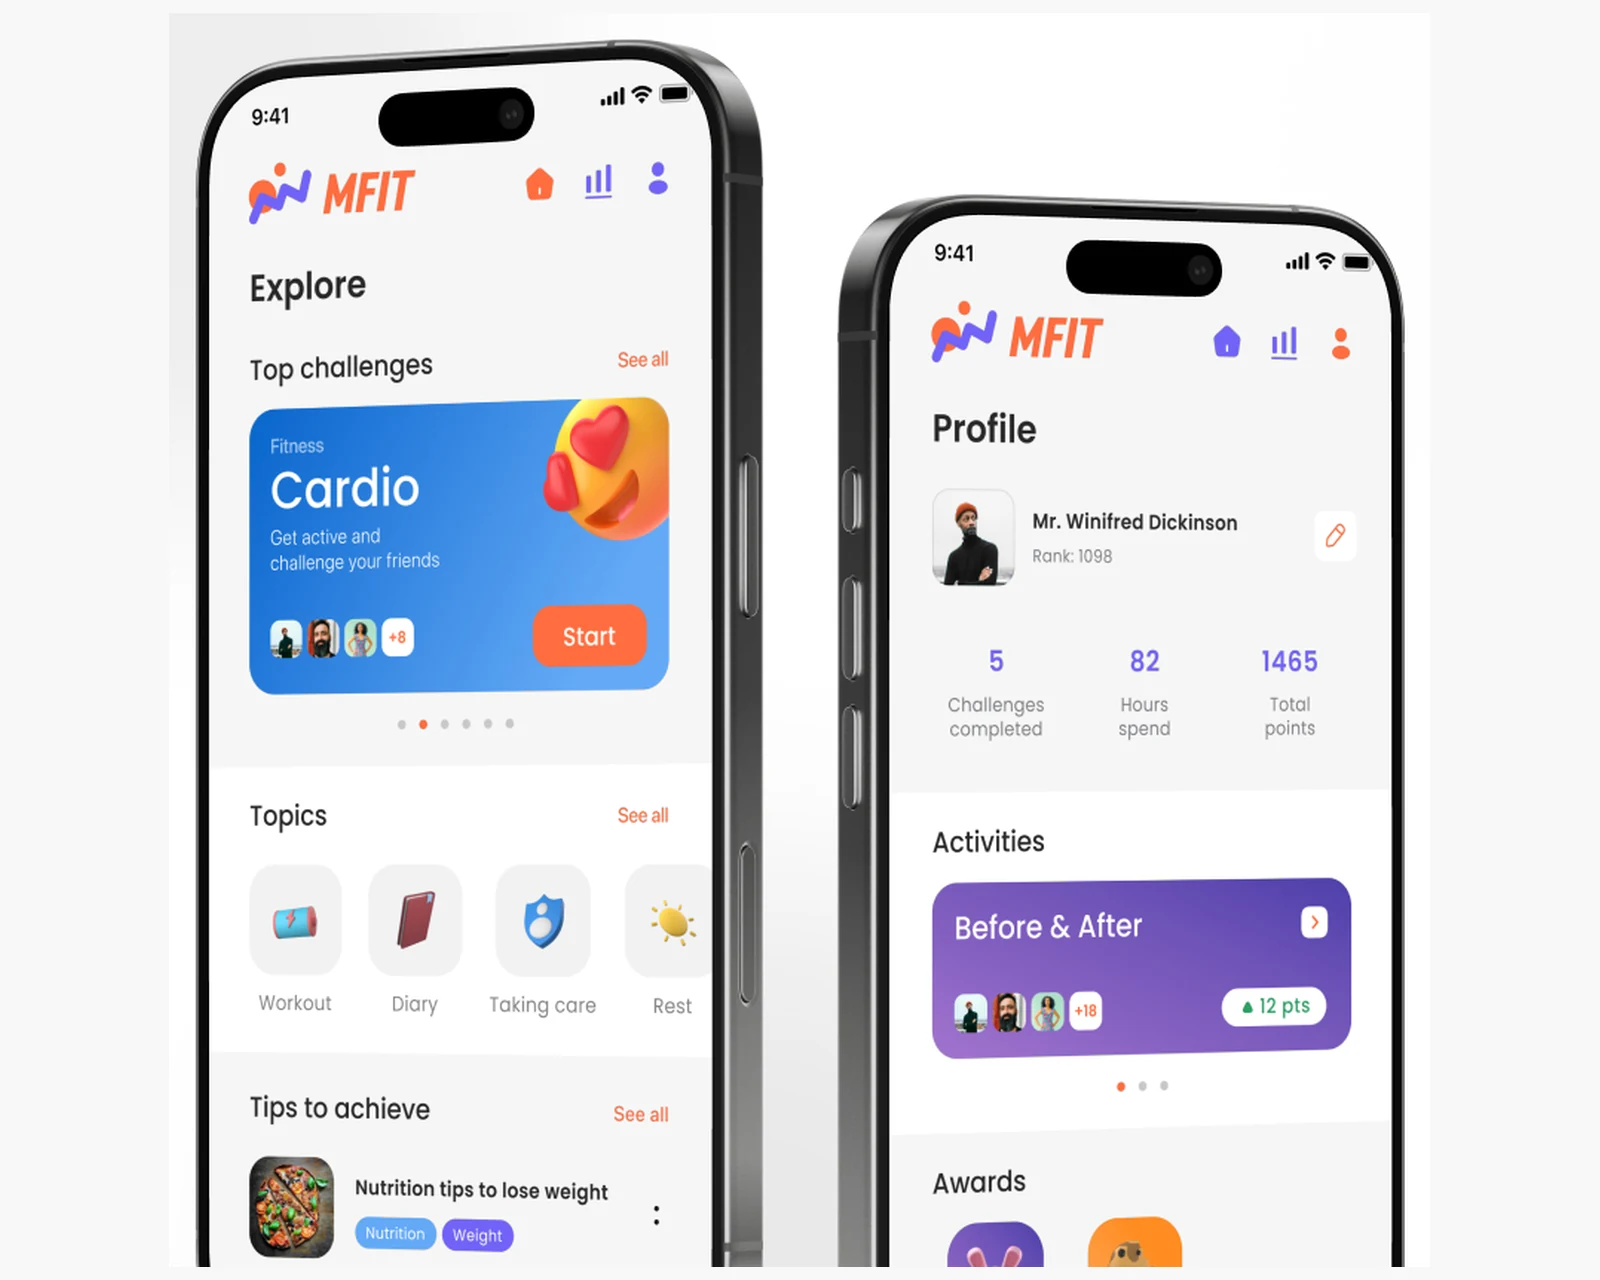
App nativa para iOS y Android de maratones y retos de fitness: programas, estadísticas y clasificaciones sobre un backend en Laravel, para EE. UU. y la UE.
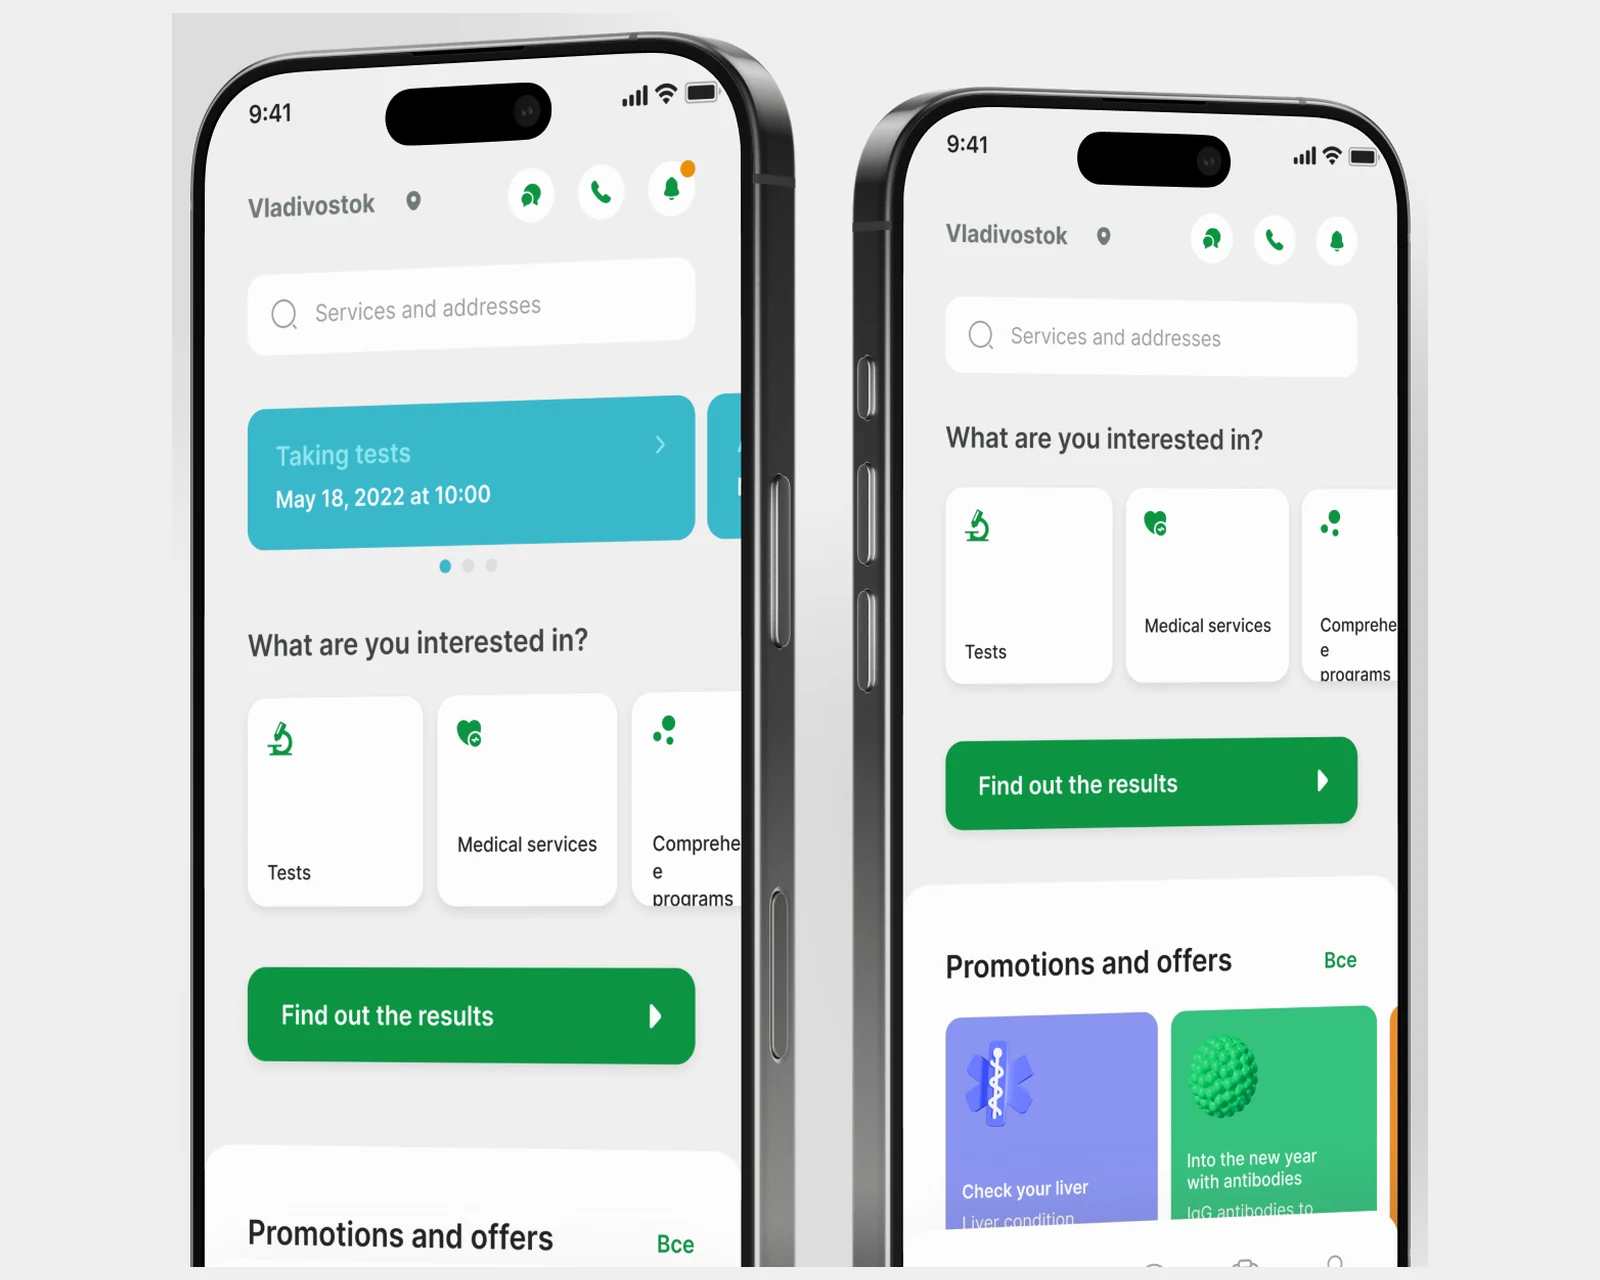
App para pacientes de una red de laboratorios en 40 ciudades: reserva de citas, resultados digitales, más de 2,500 pruebas e integraciones de agenda y contabilidad.
Por qué YuSMP
Desde la ingeniería de datos hasta el entrenamiento en GPU, el servicio y la monitorización, los mismos ingenieros sénior se encargan del modelo de principio a fin — sin lagunas en los traspasos.
Diseñamos teniendo en cuenta el Reglamento de IA de la UE, el RGPD, NIST AI RMF y SOC 2 desde el primer commit, no como algo de última hora antes del lanzamiento.
Los pipelines reproducibles, la inferencia optimizada y la monitorización en vivo hacen que sus modelos se mantengan rápidos, precisos y observables bajo carga real.
Preguntas frecuentes
Para la mayor parte del trabajo nuevo de deep learning recomendamos PyTorch: su ejecución eager, su experiencia de depuración y su ecosistema (Lightning, Hugging Face) hacen más rápidas la investigación y la iteración. TensorFlow aún tiene puntos fuertes en algunos stacks móviles y de servicio heredados. Estaremos encantados de evaluar sus activos actuales y de elegir el framework que minimice el riesgo y el coste total.
El entrenamiento es intermitente y exige mucha GPU — se necesita hardware potente, a menudo distribuido, durante horas o días y luego se libera. La inferencia es constante y sensible a la latencia, optimizada para el rendimiento y el coste por solicitud. Las diseñamos por separado para que nunca pague GPU de entrenamiento inactivas para servir predicciones, y dimensionamos cada una de forma independiente.
Los caminos habituales son TorchServe, para un servicio nativo de PyTorch con batching y métricas integrados, o un servicio FastAPI que envuelva el modelo para un control más preciso y una lógica a medida. Para un alto rendimiento añadimos ONNX Runtime o Triton. Elegimos según sus objetivos de latencia, su escala y su plataforma actual.
ONNX es un formato de modelo portable que permite ejecutar modelos de PyTorch en runtimes optimizados sobre distintos hardware. Cuando un modelo es lo bastante preciso, lo exportamos a ONNX y aplicamos cuantización o destilación para reducirlo y recortar la latencia. Si se hace con cuidado, esto suele reducir de forma sustancial el coste de inferencia con una pérdida mínima de precisión.
Estandarizamos MLflow para el seguimiento de experimentos y el registro de modelos, Ray para las cargas distribuidas, Docker y Kubernetes para el despliegue y pipelines de CI/CD que condicionan las versiones a las métricas de evaluación. La monitorización cubre la deriva de los datos, la calidad de las predicciones y la latencia. Las herramientas concretas se adaptan a su nube y a su infraestructura actual.
Usamos instancias spot o interrumpibles para el entrenamiento, autoescalado y escalado a cero para la inferencia, entrenamiento de precisión mixta y optimización de modelos para que quepan en un hardware más pequeño. También perfilamos los trabajos para eliminar cuellos de botella y que las GPU terminen antes. En conjunto, esto suele reducir de forma notable el gasto de cómputo sin sacrificar el rendimiento.
El Reglamento clasifica los sistemas de IA por riesgo e impone obligaciones — documentación técnica, gobernanza de datos, supervisión humana y evaluación de la conformidad — principalmente a los usos de alto riesgo. Le ayudamos a clasificar cada modelo, a documentarlo correctamente y a incorporar supervisión y registro en la ruta de inferencia para cumplir los requisitos sin frenar la entrega.
Respuesta en 1 día hábil. NDA a petición.
Cuéntenos algunos detalles y un consultor sénior le responderá en un día hábil.