Una estructura de proyecto que escala
Sin una estratificación deliberada de staging → intermediate → marts, los proyectos de dbt se dispersan en cientos de modelos interdependientes que nadie sabe recorrer ni refactorizar con seguridad.

dbt Ingeniería analítica ELT SQL
Como empresa de desarrollo dbt, construimos la capa de transformación de su stack de datos moderno — convertimos las tablas en bruto del almacén de datos en productos de datos gobernados, probados y documentados. Nuestros ingenieros analíticos trabajan con equipos de datos de EE. UU. y la UE que necesitan marts fiables, un linaje claro y ejecuciones rápidas y con control de costes. Desde proyectos dbt nuevos hasta el rescate de SQL enmarañado, entregamos modelos mantenibles en los que analistas y partes interesadas confían de verdad.
Como empresa de desarrollo dbt, construimos la capa de transformación de su stack de datos moderno — convertimos las tablas en bruto del almacén de datos en productos de datos gobernados, probados y documentados. Nuestros ingenieros analíticos trabajan con equipos de datos de EE. UU. y la UE que necesitan marts fiables, un linaje claro y ejecuciones rápidas y con control de costes. Desde proyectos dbt nuevos hasta el rescate de SQL enmarañado, entregamos modelos mantenibles en los que analistas y partes interesadas confían de verdad.
Retos
Sin una estratificación deliberada de staging → intermediate → marts, los proyectos de dbt se dispersan en cientos de modelos interdependientes que nadie sabe recorrer ni refactorizar con seguridad.
Las ejecuciones ingenuas con full-refresh reprocesan todo el histórico en cada compilación y consumen créditos del almacén de datos; elegir la estrategia incremental adecuada y gestionar los datos que llegan tarde es realmente difícil.
Los modelos sin probar rompen en silencio los paneles posteriores; los equipos tienen dificultades para decidir qué probar, dónde y con qué rigor sin ralentizar cada ejecución hasta el extremo.
El Jinja demasiado ingenioso y el SQL copiado y pegado vulneran DRY y se vuelven ilegibles; infrautilizar las macros deja la lógica duplicada en decenas de modelos.
Ejecutar y probar solo lo que ha cambiado (slim CI) en entornos efímeros o aislados no es trivial, y sin ello cada pull request pone en riesgo todo el almacén de datos.
A medida que se multiplican los modelos, el linaje se vuelve turbio, la documentación se pudre y nadie es responsable de un mart concreto — lo que hace imposibles el análisis de impacto y la confianza.
Soluciones
Estructuramos los proyectos en capas de staging, intermediate y mart, con nomenclatura, sources y convenciones de carpetas coherentes para que el proyecto siga siendo legible a medida que crece.
Implementamos las materializaciones y estrategias incrementales adecuadas (merge, insert-overwrite, microbatch), gestionamos los datos tardíos y la política de full-refresh y reducimos el gasto del almacén de datos.
Añadimos pruebas genéricas y singulares, contratos de esquema, comprobaciones de actualidad y paquetes para que los fallos salgan a la luz en el CI — no en el panel de una parte interesada.
Extraemos la lógica compartida a macros bien documentadas y adoptamos paquetes contrastados (dbt_utils, codegen, dbt_expectations) para mantener el código DRY y coherente.
Configuramos slim CI en las pull requests, destinos de dev/CI/prod separados y compilaciones automatizadas para que solo se ejecuten y se prueben, antes de fusionar, los modelos modificados y sus dependientes.
Generamos dbt docs con linaje completo, añadimos descripciones, exposures y metadatos de titularidad y definimos un modelo de gobernanza en el que todo su equipo pueda apoyarse.
Stack
dbt Core, dbt Cloud, adaptadores de Snowflake/BigQuery/Databricks/Redshift, macros de Jinja, pruebas y snapshots, exposures, dbt docs/linaje, Git, CI.
Cumplimiento
RGPD · calidad de datos probada · linaje/gobernanza · SOC 2
Casos
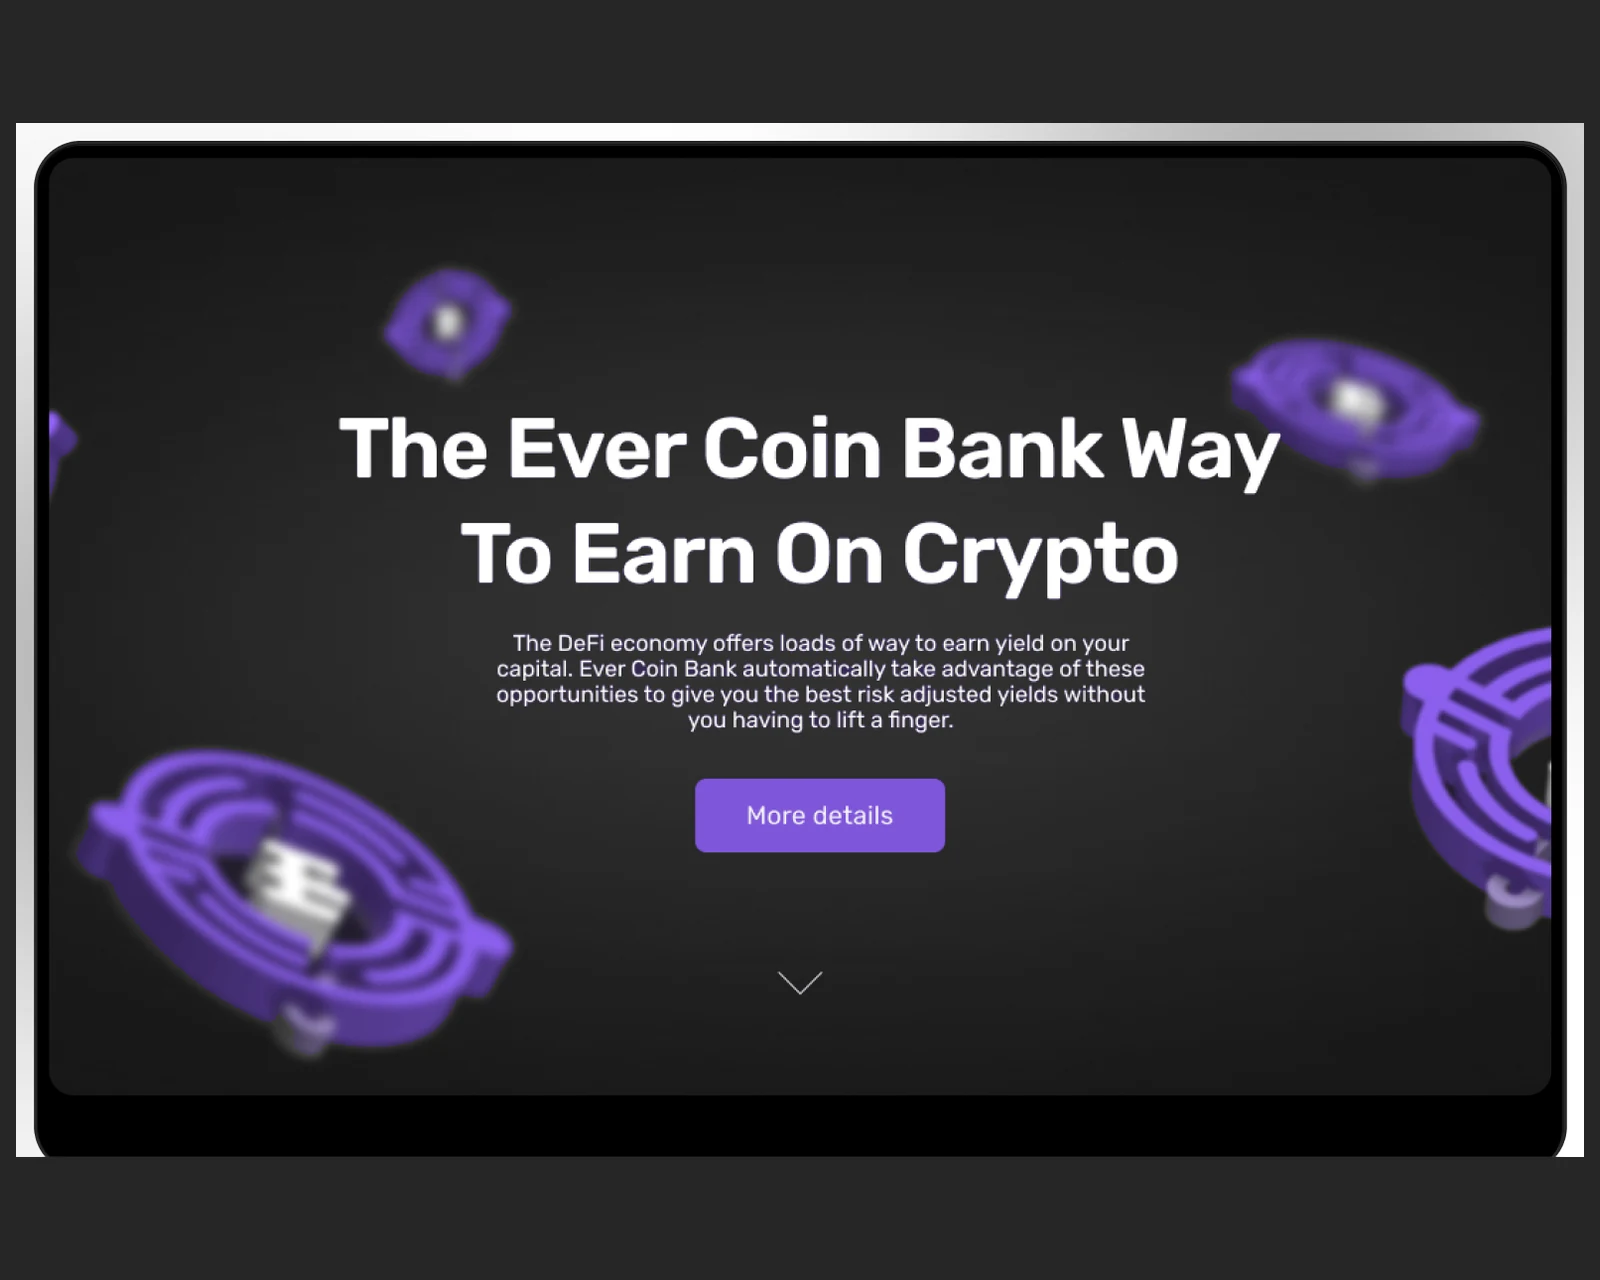
Hub unificado de un ecosistema cripto que agrega varios tokens: datos de exchanges en vivo, búsqueda, gráficos y punto de entrada directo para la compra.

B2B e-commerce y configurador de producto para un fabricante mundial de polímeros, con precios por región, stock y flujos de trabajo para distribuidores.
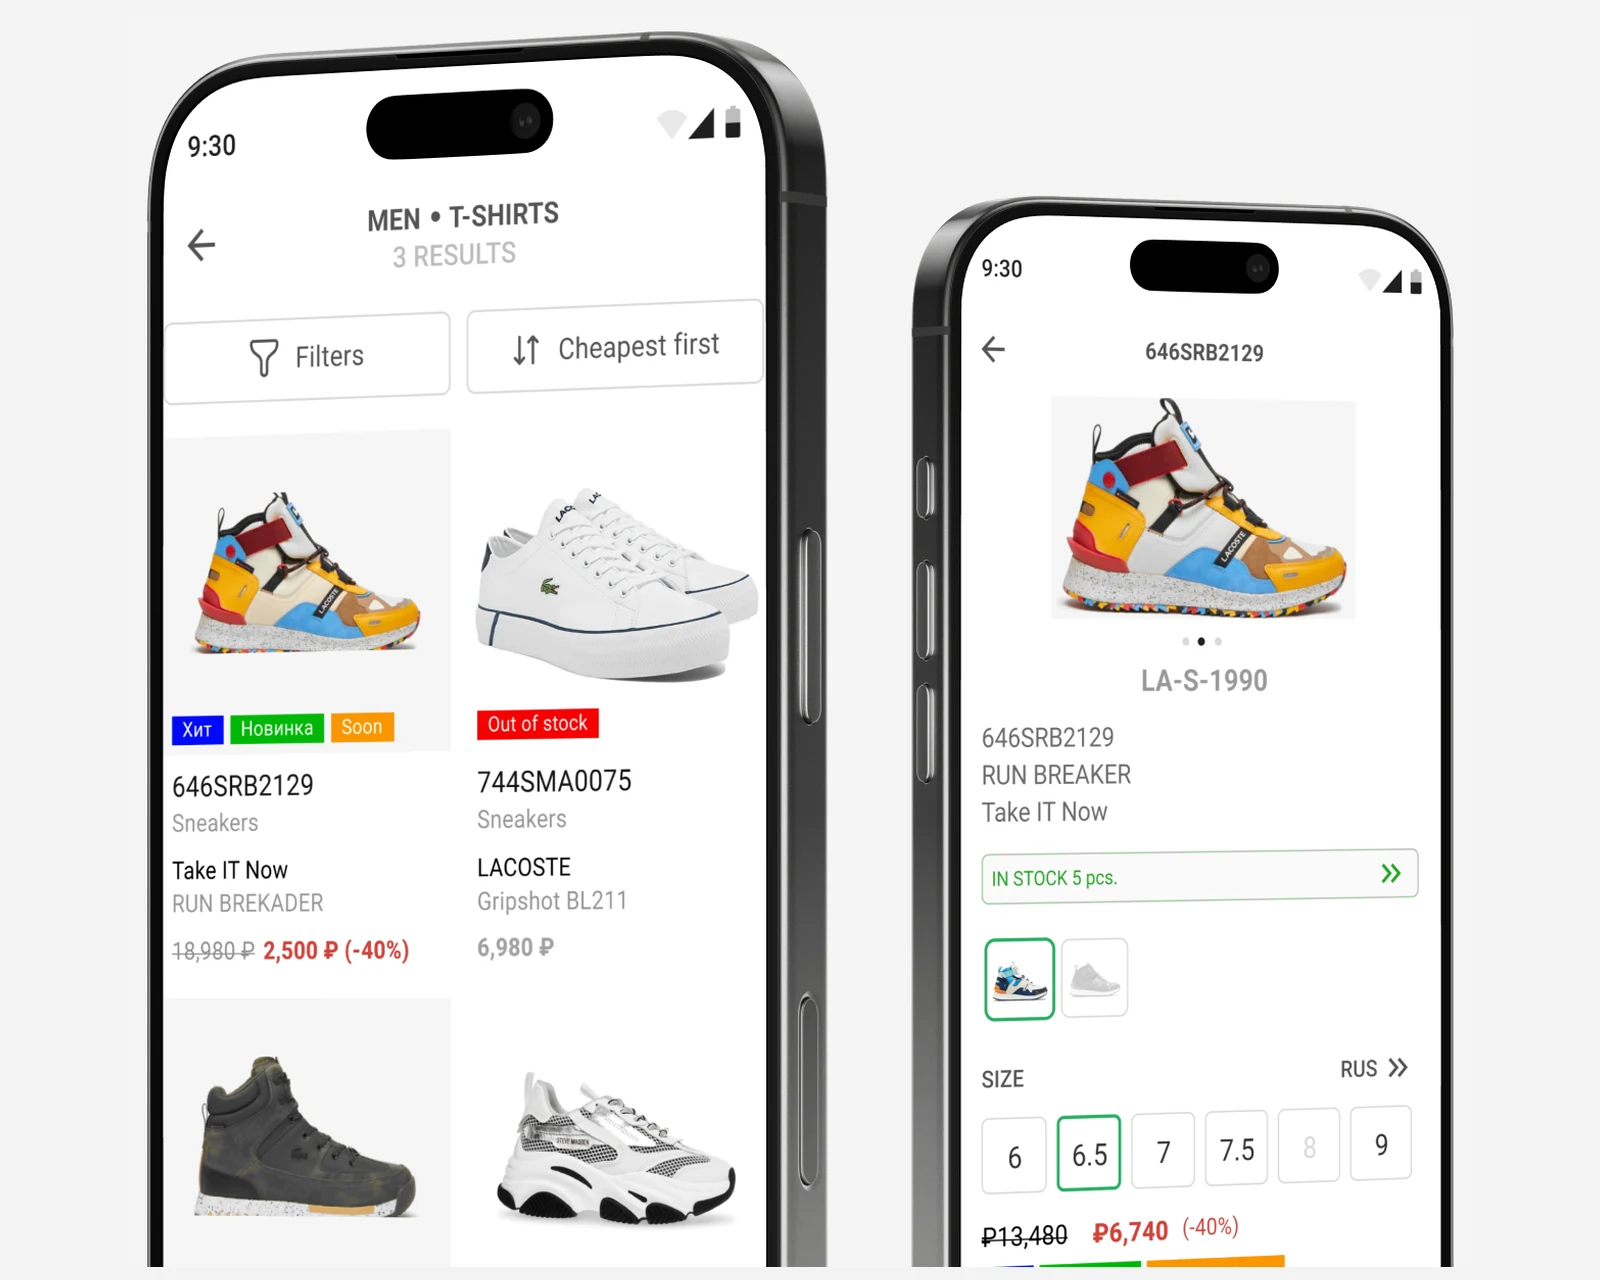
App complementaria de TPV para una cadena de boutiques multimarca: búsqueda de inventario entre tiendas con ElasticSearch e integración con el sistema 1C.
Por qué YuSMP
Sabemos que dbt hace la T de ELT — transforma datos que ya están en su almacén de datos, no es una herramienta de ingesta ni un orquestador —, así que diseñamos pipelines que se ajustan a la realidad.
Cada modelo que entregamos incluye pruebas, documentación y linaje, para que analistas, directivos y sistemas posteriores puedan fiarse de las cifras.
Snowflake, BigQuery, Databricks o Redshift — ajustamos las materializaciones, los costes y las particularidades de cada adaptador a su plataforma, en lugar de aplicar una plantilla única para todos.
Preguntas frecuentes
dbt (data build tool) se encarga del paso de transformación en ELT. Una vez cargados los datos en bruto en su almacén de datos, dbt ejecuta modelos SQL para limpiarlos, combinarlos y agregarlos en tablas y vistas listas para analítica. No ingiere datos ni es un orquestador — transforma datos que ya residen en el almacén de datos.
dbt Core es la herramienta de línea de comandos gratuita y de código abierto que usted mismo ejecuta en su propia infraestructura o en el CI. dbt Cloud es el producto comercial alojado que añade un scheduler gestionado, un IDE, integraciones de CI y una capa alojada de documentación y metadatos. Trabajamos con ambos y le ayudamos a elegir según el tamaño del equipo, las necesidades de gobernanza y el presupuesto.
Los modelos incrementales construyen solo las filas nuevas o modificadas en cada ejecución, en lugar de reconstruir toda la tabla. Reducen drásticamente el coste y el tiempo de ejecución del almacén de datos en conjuntos de datos grandes y con muchas inserciones. Añaden complejidad en torno a los datos que llegan tarde y a los full-refresh, por lo que los aplicamos donde el volumen lo justifica y mantenemos los modelos más pequeños como simples materializaciones de tabla o vista.
dbt permite declarar pruebas — genéricas como not-null, unique y relationships, además de pruebas singulares personalizadas — que se ejecutan en cada compilación. Combinado con comprobaciones de actualidad de las fuentes y paquetes como dbt_expectations, detecta los datos erróneos antes de que lleguen a los paneles. Diseñamos un conjunto de pruebas exhaustivo sin que las ejecuciones se vuelvan prohibitivamente lentas.
El almacén de datos (Snowflake, BigQuery, etc.) almacena y calcula los datos; dbt define y ejecuta dentro de él las transformaciones SQL; y un orquestador como Airflow programa y lanza las ejecuciones de dbt junto con la ingesta y otras tareas. dbt no programa pipelines por sí mismo — lo invoca un orquestador o el scheduler de dbt Cloud.
dbt admite todos los principales almacenes de datos en la nube mediante adaptadores, entre ellos Snowflake, Google BigQuery, Databricks, Amazon Redshift, Postgres y otros. Ajustamos las materializaciones, el rendimiento y el coste a su plataforma concreta, ya que cada adaptador tiene su propio dialecto SQL y sus propias palancas de optimización.
Para un conjunto de datos diminuto con una o dos tablas sencillas y sin lógica de transformación real, un par de vistas SQL o un script ligero pueden bastar — la estructura de proyecto, las pruebas y el CI de dbt añaden una sobrecarga que quizá aún no necesite. dbt compensa cuando hay varios modelos, varios colaboradores, problemas de calidad recurrentes o necesidad de linaje y documentación.
Respuesta en 1 día hábil. NDA a petición.
Cuéntenos algunos detalles y un consultor sénior le responderá en un día hábil.