Servicios

Servicios de integración de IA generativa para equipos de software

Servicios de consultoría e integración de IA generativa para operadores B2B que necesitan sistemas entregados y no presentaciones — con precios en niveles ajustados y de alcance cerrado, no en un proyecto empresarial de seis cifras. Puntuamos los casos de uso según el impacto en ingresos, elegimos el LLM adecuado para cada tarea sobre un banco de evaluación real, construimos pipelines de RAG y de prompts que resisten el contacto con usuarios reales y entregamos un MLOps que su equipo puede asumir. Una prueba de concepto desde $2,900 en 4–6 semanas, RAG sobre su base de conocimiento desde $8,100, un agente de IA autónomo desde $10,400 y un modelo de ML en producción desde $13,800. Ingenieros sénior que han operado cargas de LLM en producción a escala — no prompt engineers que leen Twitter. Alcance cerrado y precio todo incluido en USD, con la propiedad intelectual transferida a usted el primer día.

Servicios de integración de IA generativa para empresas de EE. UU. y la UE
9+Años en el mercado
80+Ingenieros sénior en plantilla
120+Proyectos entregados
71NPS de clientes

Alineado con el RGPD · preparado para ISO 27001 · SOC 2 Type II en curso · apto para HIPAA · CCPA contemplada · jornada CET con solapamiento de 9:00–13:00 ET

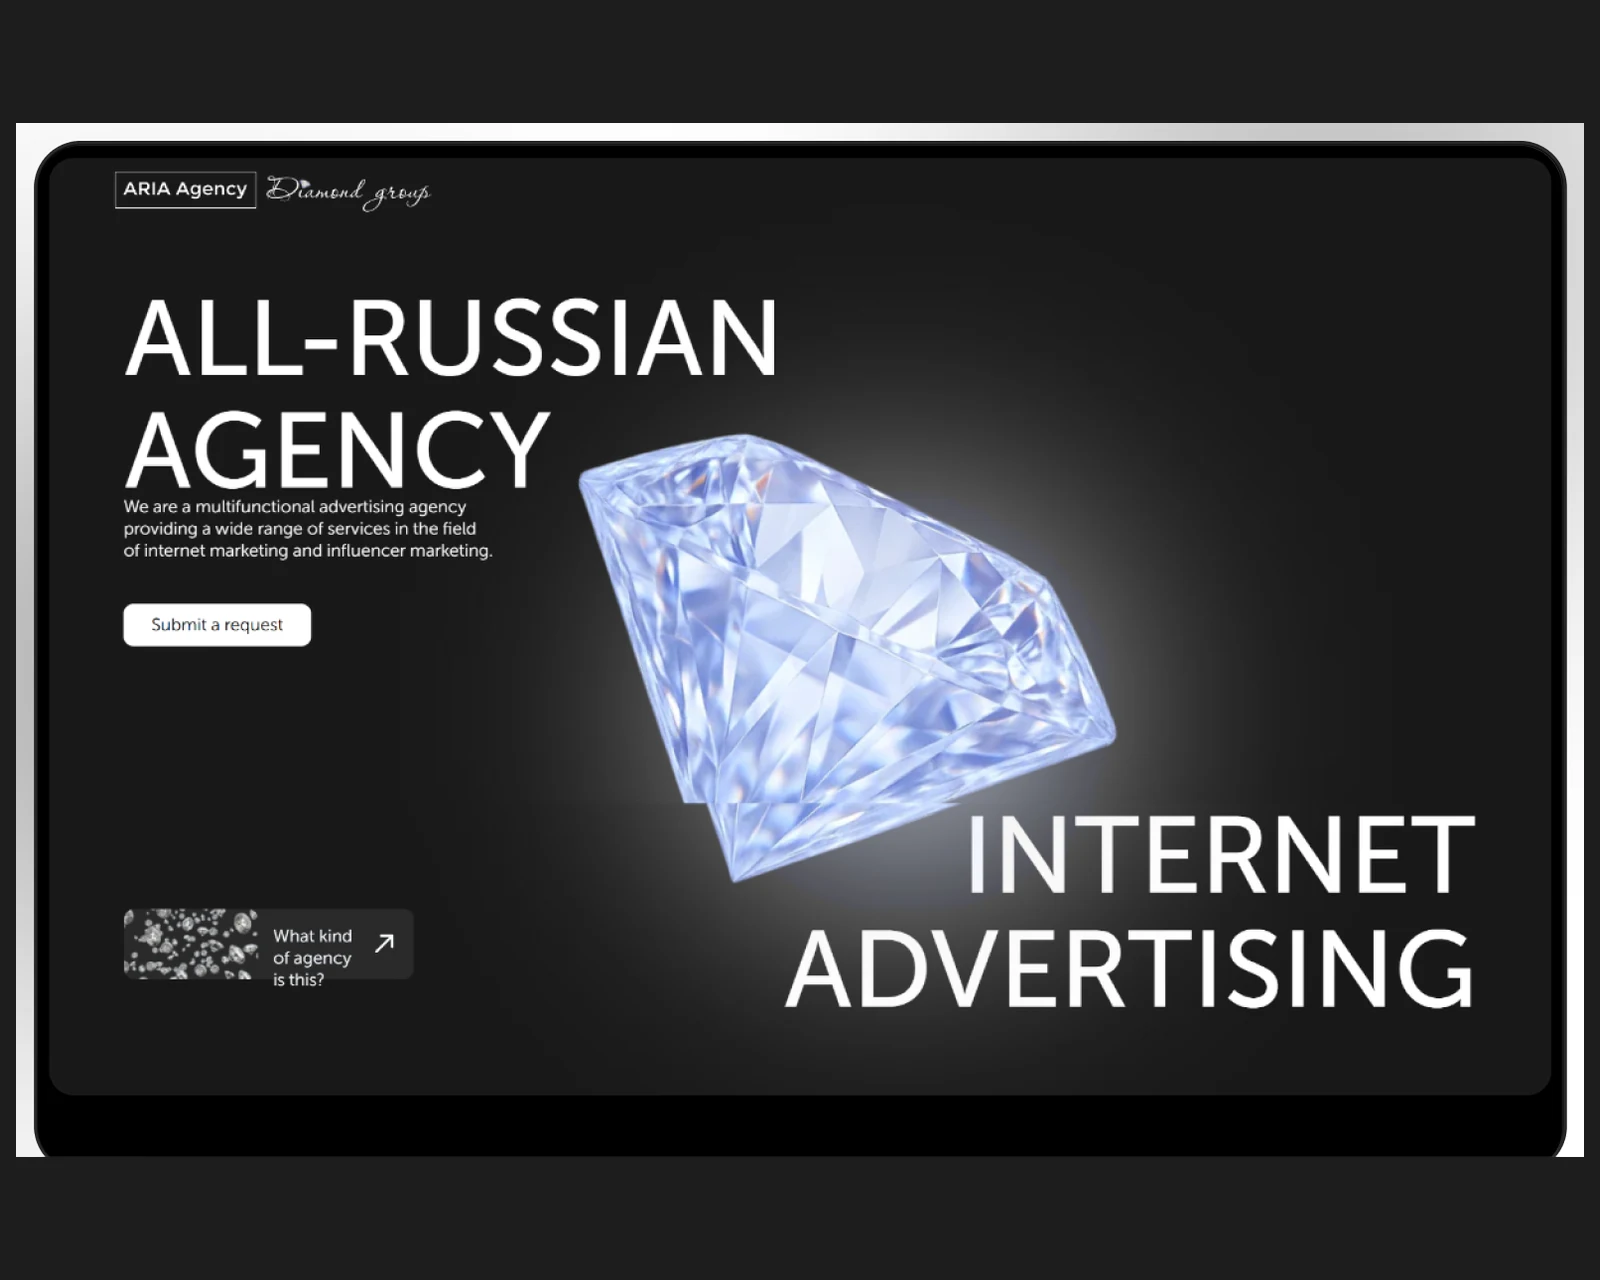
La mayoría de los proyectos de IA generativa fracasan por las mismas tres razones. El caso de uso equivocado — un chatbot que sustituye a una barra de búsqueda que nadie usaba. La evaluación equivocada — «se ve bien con cinco ejemplos» hasta que los usuarios de producción encuentran el sexto. La arquitectura equivocada — un agente de LangChain de 14 pasos donde dos llamadas a funciones habrían bastado. Empezamos con un modelo de ROI escrito y un conjunto de evaluación de 200 elementos antes de escribir una sola línea de código de orquestación. Elegimos los proveedores de LLM por latencia, calidad y coste por 1k peticiones medidos con su mix de tráfico — no por la demo que se hizo viral la semana pasada. En la semana 10 dispone de un sistema funcionando, un banco de regresión, observabilidad y un runbook que su equipo asume. Véalo en la práctica en nuestro caso de éxito de ARIA.

Qué entregamos en un proyecto de IA generativa

Descubrimiento de casos de uso y puntuación de ROI

Entrevistamos a producto, operaciones y soporte y puntuamos de 8 a 15 casos de uso candidatos según el impacto en ingresos, el coste de desarrollo, la viabilidad y el riesgo. Recibe una lista corta priorizada, un modelo de ROI escrito para cada uno de los tres primeros y una lista clara de «no construir esto» con su razonamiento.
Selección de proveedor de LLM

Selección guiada por evaluación entre OpenAI, Anthropic, Bedrock y Vertex. Medimos calidad, latencia p50/p95 y coste sobre un conjunto de evaluación específico de la tarea de 150 a 400 elementos. El resultado es un ADR con el modelo elegido, un modelo de reserva y el desencadenante para volver a evaluar.

RAG y pipelines de datos

Ingesta del corpus, estrategia de chunking calibrada a la distribución de sus documentos, selección del modelo de embeddings, dimensionado del almacén de vectores y recuperación híbrida. Dimensionamos según la tasa real de crecimiento de su corpus, no una demo por defecto de 100k vectores.

Prompt engineering y evaluaciones

Prompts versionados en git, conjuntos de evaluación de regresión que se ejecutan en CI, rúbricas de Ragas y DeepEval, LLM-as-judge con comprobación humana por muestreo. Nos negamos a fusionar cambios de prompt que empeoren una métrica de nivel 1, incluso los nuestros.

Seguridad y tratamiento de PII

Eliminación de PII en la entrada (Presidio o un clasificador ajustado), contratos de proveedor de retención cero, endpoints de la UE para datos de la UE y análisis de salida para detectar PII alucinada. DPA y listas de subencargados alineados con los contratos de sus clientes.

MLOps para LLM

Observabilidad con LangSmith, Langfuse o Helicone. Registro por petición de la versión del prompt, el modelo, los tokens, la latencia y el coste. Alertas de coste, SLO de latencia, pruebas A/B automatizadas de prompts y un runbook escrito para actualizaciones de modelo y caídas de proveedores.

Herramientas que utilizamos

OpenAI Anthropic Bedrock Vertex AI LangChain LlamaIndex Pinecone Weaviate Qdrant Chroma OpenSearch pgvector Ragas DeepEval LangSmith Helicone Phoenix MLflow vLLM Ollama Guardrails Pydantic

Cómo se desarrolla un proyecto de integración de IA generativa

  1. 01

    Descubrimiento

    Semanas 1–3: entrevistas con las partes interesadas, puntuación de casos de uso, modelo de ROI y diseño del conjunto de evaluación. El resultado es una lista corta priorizada y una propuesta de arquitectura que el fundador y el consejo pueden leer.

  2. 02

    Evaluación de proveedores

    Semanas 4–5: construimos el banco de evaluación, ejecutamos los modelos candidatos sobre el conjunto específico de la tarea y redactamos el ADR con el modelo elegido, el modelo de reserva y el desencadenante de reevaluación. Prompts versionados en git.

  3. 03

    Desarrollo del piloto

    Semanas 6–10: sistema de extremo a extremo, orquestación de RAG o de agentes, observabilidad, tratamiento de PII y despliegue customer-zero tras un feature flag. Evaluaciones de regresión en CI antes de fusionar cualquier prompt.

  4. 04

    Despliegue a producción

    Semanas 11+: ampliamos el conjunto de evaluación, añadimos modelos de reserva, formamos a su equipo en el runbook, fijamos SLO de coste y latencia y hacemos la primera revisión trimestral de actualización de modelo. Nos retiramos cuando su equipo lo opera.

Modelos de colaboración

Prueba de concepto

4–6 semanas. Un caso de uso, puntuación del caso de uso y modelo de ROI, un conjunto de evaluación, un prototipo funcional y un go/no-go por escrito con una proyección de costes. Ideal para equipos que aún no saben qué apuesta de IA generativa merece la pena. Desde $2,900.

RAG sobre su base de conocimiento

Generación aumentada por recuperación sobre su propio corpus: ingesta y chunking, recuperación híbrida y reranking, banco de evaluación en CI, tratamiento de PII, guardrails y observabilidad. Desde $8,100.

Agente de IA (autónomo)

Un agente de varios pasos que actúa en todas sus herramientas, con intervención humana en las rutas críticas, evaluaciones deterministas, filtros de salida y un runbook que gestiona su equipo. Desde $10,400.

Modelo de ML en producción

Un modelo a medida o ajustado entregado a producción: pipelines de datos, entrenamiento y ablaciones, MLOps con monitorización de deriva y un camino documentado del notebook al serving. Desde $13,800.

Todos los proyectos empiezan con un NDA mutuo, la cesión de la propiedad intelectual y un DPA. El precio es todo incluido y en USD, con la propiedad intelectual transferida a usted el primer día, sin recargo por intermediación ni sobrecostes por herramientas. El gasto en nube y en tokens corre por sus propias cuentas, de modo que usted conserva el control del coste.

Cuánto cuesta integrar IA generativa y qué determina el precio

Niveles ajustados y de alcance cerrado para que pueda presupuestar antes del descubrimiento. Todo es todo incluido, presupuestado en USD, con la propiedad intelectual transferida a usted el primer día, sin recargo por intermediación, sin sobrecostes por herramientas y sin costes ocultos. Usted ve el presupuesto desglosado antes de que se escriba una sola línea de código y lo aprueba. El gasto en nube y en tokens corre por sus propias cuentas, de modo que usted conserva el control del coste. ¿Quiere dimensionar primero la factura de tokens? Modélela con nuestra calculadora gratuita de gasto en LLM.

Prueba de concepto

desde $2,900

4–6 semanas · un caso de uso

Puntuación de casos de uso, modelo de ROI, diseño del conjunto de evaluación, un prototipo funcional y un go/no-go por escrito — antes de comprometerse con un desarrollo.

RAG sobre su base de conocimiento

desde $8,100

anclado en su corpus

Pipeline de RAG o de prompts sobre su propio corpus, banco de evaluación en CI, observabilidad y tratamiento de PII — un despliegue customer-zero que sus ingenieros asumen.

Agente de IA (autónomo)

desde $10,400

de varios pasos, con uso de herramientas

Un agente de varios pasos que actúa sobre sus herramientas, con supervisión humana en las rutas de alto riesgo, evaluaciones deterministas y filtros de salida.

Modelo de ML en producción

desde $13,800

del notebook a producción

Un modelo a medida o ajustado entregado a producción: pipelines de datos, entrenamiento y ablaciones, MLOps con monitorización de deriva.

Lo que mueve la cifra: cuántos casos de uso entrega y la profundidad de cada corpus de RAG; el tamaño del conjunto de evaluación necesario para confiar en las salidas (150 a 400 elementos por tarea); los objetivos de latencia, porque un p95 por debajo de 500ms obliga a elegir modelo e infraestructura; y el alcance de cumplimiento — alineado con el RGPD, apto para HIPAA o contratos de proveedor de retención cero elevan el listón. Un único asistente anclado en un corpus estable se sitúa en la parte baja; un sistema multimodelo que escribe en producción bajo un DPA, en la parte alta. El gasto en nube y en tokens corre por sus propias cuentas, de modo que usted conserva el control del coste. ¿Necesita personalizar el modelo en lugar de integrarlo? Consulte ajuste fino de LLM y RAG como servicio.

Sectores para los que integramos IA generativa

Una función de IA generativa solo es tan segura como su encaje con su realidad regulatoria y operativa. Combinamos la integración de LLM con cumplimiento específico de cada sector en los mercados de EE. UU. y la UE, y sumamos a nuestros equipos hermanos de IA, ML y datos, desarrollo de agentes de IA y cumplimiento del Reglamento de IA de la UE cuando una carga de trabajo los necesita.

FinTech

Asistentes anclados para preguntas y respuestas sobre pólizas y contratos, resumen de disputas y copilotos para analistas — con eliminación de PII en la entrada y tratamiento de datos en el ámbito de PCI DSS.

IA generativa para FinTech →

HealthTech

RAG apto para HIPAA y alineado con el RGPD sobre historiales y protocolos, resumen de admisiones y redacción de operaciones asistenciales — con flujos de datos documentados y análisis de salida para detectar PII alucinada.

IA generativa para HealthTech →

E-commerce y retail

Enriquecimiento de catálogo, generación de respuestas de soporte y copilotos de merchandising anclados en su propio corpus de productos, bajo estrictas puertas de evaluación y topes de coste por petición.

IA generativa para Retail →

Logística y movilidad

Resúmenes de gestión de excepciones, preguntas y respuestas sobre envíos y ETA y redacción de back-office sobre un estado operativo cambiante — con contratos de proveedor de retención cero y endpoints de la UE para datos de la UE.

IA generativa para Logística →

LegalTech

Revisión de contratos y extracción de cláusulas, preguntas y respuestas regulatorias ancladas en su corpus de jurisdicción y asistentes de redacción de documentos — con el secreto profesional entre abogado y cliente preservado mediante contratos de retención cero y estrictos controles de residencia de datos. La salida siempre lleva una puerta de revisión humana; no entregamos conclusiones jurídicas autónomas.

IA generativa para LegalTech →

EdTech y RR. HH.

Generación de itinerarios de aprendizaje personalizados, creación automática de cuestionarios y evaluaciones y emparejamiento de currículos con puestos a escala — ancladas en su corpus de currículo académico o de descripciones de puestos, con puertas de evaluación que detectan sesgos y credenciales alucinadas antes de que la salida llegue a candidatos o estudiantes.

IA generativa para EdTech →

Ver todos los sectores →

Por qué los equipos de EE. UU. y la UE eligen YuSMP para trabajos de IA generativa

Alineados con el RGPD · preparados para ISO 27001 · SOC 2 Type II en curso · aptos para HIPAA · CCPA contemplada

Primero evaluaciones, no primero demos

Todos los proyectos empiezan con un conjunto de evaluación de 150 a 400 elementos antes de cerrar la arquitectura. Nos negamos a entregar prompts que nunca han pasado una ejecución de regresión. Las demos no son evidencia.

Ingenieros sénior, no prompters

Nuestros responsables de LLM entregaron ML en producción antes de que los transformers se pusieran de moda — ranking, clasificación, relevancia de búsqueda. Discuten presupuestos de latencia y planes de consulta de Postgres, no hilos de Twitter.

Dominio del cumplimiento normativo

RGPD, SOC 2, HIPAA, CCPA — hemos negociado contratos de retención cero con OpenAI y Anthropic, redactado DPA que resisten las revisiones de clientes y acompañado a auditores en el ámbito de los LLM.

Tratamos la elección del proveedor de LLM como una decisión trimestral, no como una religión. Cuando se mueva la frontera, lo dirán sus evaluaciones — no la presentación trimestral de resultados de un proveedor.

Lo que dicen nuestros clientes

Un motor de decisión de créditos que aprueba diez veces más rápido no surge por casualidad. YuSMP construyó el flujo de scoring, la integración con burós de crédito y un back-office que a nuestros analistas de riesgos les gusta usar. El plazo de aprobación pasó de dos días a menos de cuatro horas.
Gregory Lawson, CTO de LoanFlowVer el caso →

Preguntas frecuentes

¿Cómo eligen el proveedor de LLM adecuado para nuestra carga de trabajo?

La selección de proveedor es un problema de evaluación, no de marketing. Construimos un conjunto de evaluación específico de la tarea de 150 a 400 entradas representativas con salidas de referencia calificadas y puntuamos los modelos candidatos en calidad (LLM-as-judge más comprobación humana por muestreo sobre un subconjunto de 50 elementos), latencia en los p50/p95/p99 que realmente necesitamos y coste por 1k peticiones con nuestro mix de tokens. Alineación típica: GPT-4o o Claude 3.7 Sonnet para razonamiento, GPT-4o-mini o Claude 3.5 Haiku para clasificación, gpt-4o-realtime para voz y un modelo de pesos abiertos en vLLM para batch sensible al coste. Repetimos la evaluación cada trimestre porque la frontera se mueve.

¿Cuándo es RAG la respuesta correcta y cuándo no?

RAG es lo correcto cuando las respuestas viven en un corpus que se actualiza más rápido de lo que se puede ajustar un modelo (políticas, documentación de producto, tickets, contratos). Es la respuesta equivocada cuando el modelo ya conoce el dominio (código general, conocimiento general), cuando la latencia está por debajo de 500ms p95 o cuando se necesitan salidas deterministas que el ajuste fino produce con más fiabilidad. A menudo combinamos: RAG para anclar en datos del cliente, un modelo pequeño ajustado para la estructura de la salida o el vocabulario del dominio y prompt engineering para la orquestación. El RAG puro es raro en producción. El ajuste fino puro es más raro aún.

¿Cómo gestionan los PII, el RGPD y los datos de clientes?

Tres capas. En la entrada, un detector de PII (Microsoft Presidio o un clasificador ajustado) elimina o tokeniza correos, nombres, teléfonos e ID de cuenta antes de que el prompt salga de nuestra infraestructura. En el proveedor, contratamos retención cero de datos con OpenAI, Anthropic y Bedrock (con BAA firmados cuando proceda) y preferimos endpoints alojados en la UE para datos de la UE. En la salida, se analiza la respuesta para detectar PII alucinada antes de mostrarla al usuario. Los DPA se firman antes del inicio y mantenemos una lista de subencargados alineada con los contratos de cara al cliente.

¿Cómo son el versionado y la evaluación de prompts en producción?

Los prompts son código. Viven en el control de versiones, se revisan en pull requests y se etiquetan con versiones semánticas que se registran en cada inferencia. Cada cambio de prompt se ejecuta contra un conjunto de evaluación de regresión en CI (Ragas para la calidad de RAG, DeepEval o una rúbrica a medida para métricas específicas de la tarea) y no fusionamos si alguna métrica de nivel 1 empeora más de un 2 %. En producción registramos la versión del prompt, el modelo, la latencia y el coste en tokens por petición con LangSmith, Helicone o Langfuse para que pueda hacer pruebas A/B de prompts igual que de funcionalidades.

¿Pueden integrarlo con nuestro stack y nuestro equipo actuales?

Sí. La mayoría de los proyectos se integran en un backend existente (Node, Python, Go, Java) y en una infraestructura existente (AWS, GCP, Azure) en lugar de ejecutarse en una plataforma aparte. No le empujamos a un orquestador específico de un proveedor si no lo necesita. Trabajamos en pareja con sus ingenieros, hacemos revisiones de código juntos y escribimos ADR para las decisiones de arquitectura, de modo que las elecciones sobrevivan a nuestro proyecto. La transferencia de conocimiento es contractual: al final del piloto, su equipo es dueño de la base de código, de las evaluaciones y del runbook.

¿Cuánto cuesta una integración de IA generativa con YuSMP?

Los proyectos son de alcance cerrado y ajustados, todo incluido y presupuestados en USD. Una prueba de concepto cuesta desde $2,900 (4–6 semanas); RAG sobre su base de conocimiento, desde $8,100; un agente de IA autónomo, desde $10,400; un modelo de ML en producción, desde $13,800. La cifra exacta depende de cuántos casos de uso entregue, la profundidad del corpus y el tamaño del conjunto de evaluación, los objetivos de latencia y el alcance de cumplimiento. Usted ve el presupuesto desglosado al final del descubrimiento y lo aprueba antes de que se escriba una sola línea de código. No hay recargo por intermediación ni sobrecostes por herramientas, y el gasto en nube y en tokens corre por sus propias cuentas, de modo que usted conserva el control del coste.

¿Qué casos de uso NO encajan bien con la IA generativa?

Tres categorías malgastan presupuesto de forma constante. Primero, las consultas deterministas: si la respuesta correcta es siempre una consulta a una base de datos o la salida de un motor de reglas, añadir un LLM aporta latencia y riesgo de alucinación sin ventaja. Segundo, las decisiones de bajo volumen y alto riesgo sin bucle de retroalimentación: un modelo que escribe una decisión de suscripción de seguros por semana y nunca se corrige no puede mejorar, y el coste del error es demasiado alto para aceptarlo. Tercero, los chatbots de vanidad: un wrapper de GPT-4 delante de una página de preguntas frecuentes que nadie lee sigue siendo una página de preguntas frecuentes que nadie lee. Incluimos una lista de «no construir esto» con su razonamiento en cada resultado de descubrimiento y le diremos cuándo un caso de uso pertenece a ella.

¿Cuánto tarda un proyecto típico de IA generativa desde el inicio hasta producción?

Una prueba de concepto lleva 4–6 semanas: descubrimiento, banco de evaluación, prototipo funcional y memorando go/no-go. Un sistema de RAG sobre su base de conocimiento, desde el inicio hasta un despliegue customer-zero tras un feature flag, suele llevar 10–14 semanas, incluidas la ingesta del corpus, el ajuste de la recuperación, el tratamiento de PII y la observabilidad. Un agente de IA autónomo suma 2–4 semanas más para el diseño de la orquestación, los puntos de supervisión humana y el runbook. Un modelo de ML en producción a partir de una línea base en notebook son 14–20 semanas según la preparación de los datos. La mayor variable son siempre sus datos: datos limpios, etiquetados y accesibles recortan semanas en cada fase.

¿Trabajan con modelos de código abierto o autoalojados?

Sí, y a menudo los mezclamos. Los modelos de pesos abiertos en vLLM (Mistral, Llama, Qwen) tienen sentido económico para clasificación batch de alto volumen y sensible a la latencia, donde un modelo de frontera alojado costaría 10 veces más con la misma calidad. Evaluamos el código abierto sobre el mismo conjunto de evaluación específico de la tarea que GPT-4o y Claude — si la diferencia de calidad es aceptable con el rendimiento y la latencia que necesita, entregamos la opción más barata. El autoalojamiento en su propio clúster de GPU o en un endpoint de inferencia gestionado (AWS SageMaker, GCP Model Garden, Azure AI) es algo que podemos diseñar y traspasar. No fingimos que el código abierto sea siempre la respuesta: en tareas de razonamiento complejo la diferencia de calidad es real y la evaluación la mostrará.

¿Cómo gestionan las alucinaciones y la calidad de la salida en producción?

Tratamos la alucinación como un problema de ingeniería con cuatro palancas. Anclaje (grounding): RAG sustituye la memoria paramétrica por recuperación de un corpus verificado, de modo que el modelo cita una fuente en lugar de inventarla. Evaluaciones: un banco de regresión en CI detecta las regresiones de calidad antes de que lleguen a los usuarios — cazamos la alucinación en las pruebas, no en producción. Filtrado de salida: los esquemas de salida estructurada (Pydantic, instructor) restringen el formato de la respuesta; para campos de alto riesgo, un clasificador secundario o un motor de reglas valida la salida antes de mostrarla. Supervisión humana: en decisiones por encima de un umbral de confianza o en categorías de alto riesgo, derivamos a una persona en lugar de autocompletar. La combinación hace que la tasa de alucinación en producción sea un SLO medible y no una situación de «esperamos que funcione».

¿Tiene un caso de uso de IA generativa que merezca llegar a producción? Puntuémoslo con una evaluación real.

Reservar una llamada inicial

Pedir propuesta

Cuéntenos algunos detalles y un consultor sénior le responderá en un día hábil.