Diseño del esquema y de los módulos
Modelar clases, propiedades y los módulos vectorizadores adecuados para que la recuperación se ajuste a su dominio es fácil de hacer mal y costoso de refactorizar después.

Weaviate Base de datos vectorial Búsqueda híbrida Multi-tenancy
Diseñamos, creamos y operamos despliegues de la base de datos vectorial Weaviate para empresas de EE. UU. y la UE que necesitan búsqueda semántica e híbrida de nivel productivo. Desde el diseño del esquema y de los módulos hasta los backends RAG multi-tenant, entregamos Weaviate en su propia infraestructura o en Weaviate Cloud. Nuestros ingenieros ajustan la calidad de la recuperación, aíslan a los tenants y mantienen los datos residentes en la jurisdicción adecuada para el RGPD y HIPAA.

Diseñamos, creamos y operamos despliegues de la base de datos vectorial Weaviate para empresas de EE. UU. y la UE que necesitan búsqueda semántica e híbrida de nivel productivo. Desde el diseño del esquema y de los módulos hasta los backends RAG multi-tenant, entregamos Weaviate en su propia infraestructura o en Weaviate Cloud. Nuestros ingenieros ajustan la calidad de la recuperación, aíslan a los tenants y mantienen los datos residentes en la jurisdicción adecuada para el RGPD y HIPAA.
Retos
Modelar clases, propiedades y los módulos vectorizadores adecuados para que la recuperación se ajuste a su dominio es fácil de hacer mal y costoso de refactorizar después.
Equilibrar la puntuación de palabras clave BM25 con la similitud vectorial y ajustar la ponderación alpha es crítico para la relevancia, pero rara vez está bien ajustado de fábrica.
Miles de tenants aislados exigen un sharding cuidadoso, una estrategia de activación y una gestión del ciclo de vida por tenant para evitar el efecto del vecino ruidoso y los desbordamientos de memoria.
Los índices HNSW consumen mucha memoria; sin la caché de vectores, la cuantización y el dimensionamiento de nodos adecuados, los costes y la latencia se disparan a medida que crecen los datos.
Elegir entre ejecutar Weaviate en Docker/Kubernetes y usar Weaviate Cloud afecta al coste, al control, a la residencia y a la carga operativa.
Seleccionar los modelos de embeddings y mantener los vectores sincronizados cuando cambian los datos de origen y los modelos es una fuente frecuente de resultados de búsqueda obsoletos o desajustados.
Soluciones
Diseñamos el esquema de su colección, configuramos los módulos vectorizadores y de reranking y validamos la recuperación con consultas reales antes de la puesta en producción.
Combinamos BM25 y búsqueda vectorial, ajustamos la ponderación alpha y añadimos reranking para que los resultados sigan siendo precisos tanto para intenciones de palabras clave como semánticas.
Implementamos el multi-tenancy nativo de Weaviate con activación, aislamiento y controles de ciclo de vida de los tenants que escalan limpiamente a grandes cantidades de tenants.
Dimensionamos los nodos, configuramos los parámetros de HNSW, la cuantización de vectores y la caché, y hacemos benchmarks de latencia y recall para controlar el coste a escala.
Desplegamos Weaviate en Docker o Kubernetes en su VPC, o en Weaviate Cloud, con copias de seguridad, monitorización y actualizaciones sin tiempo de inactividad.
Conectamos Weaviate a sus backends de RAG y de aplicación, gestionamos los pipelines de embeddings y mantenemos los vectores sincronizados con sus sistemas de origen.
Stack
Weaviate, módulos vectorizadores, búsqueda híbrida (BM25 + vectorial), multi-tenancy, GraphQL/REST, Weaviate Cloud, autoalojamiento (Docker/K8s), embeddings.
Cumplimiento
RGPD · residencia de datos autoalojada · preparado para HIPAA · SOC 2
Casos
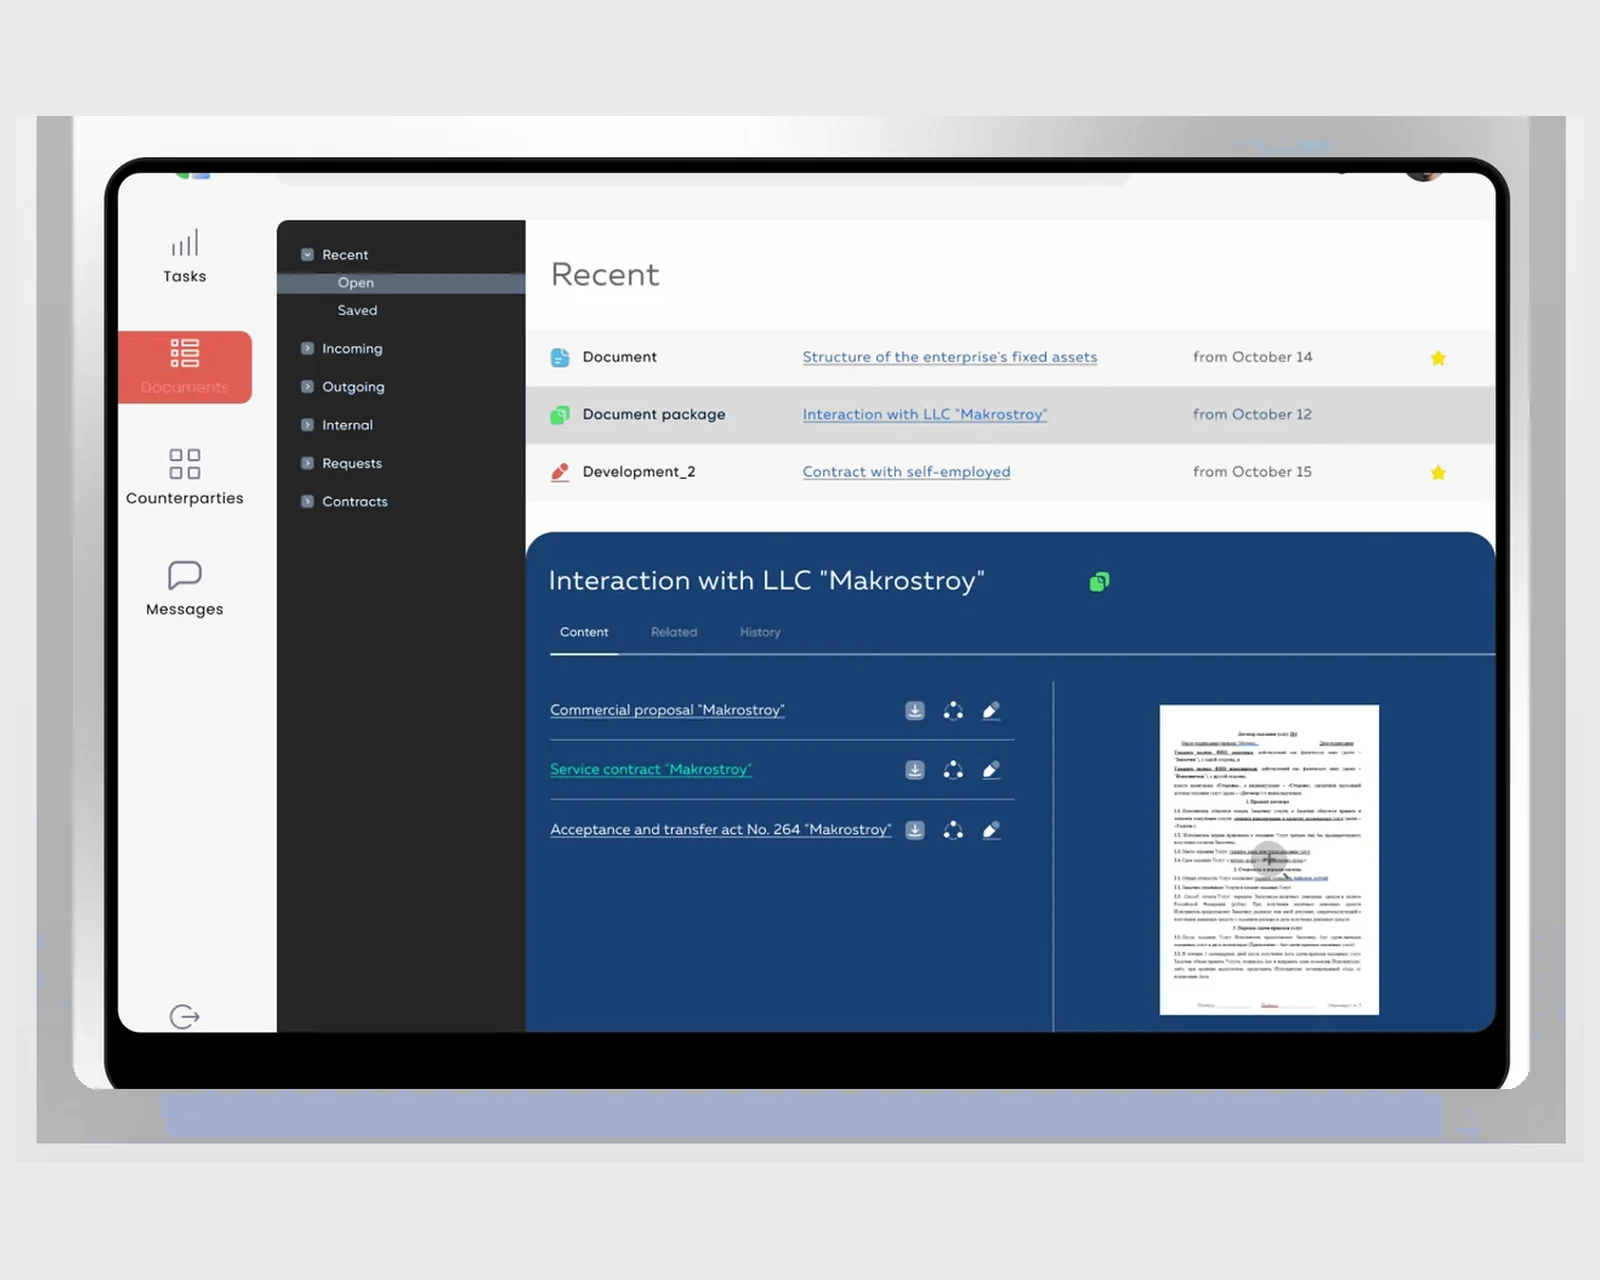
Un sistema interno de gestión documental para una cadena minorista: firmas electrónicas, circuitos de aprobación, contrapartes y tareas con React + Laravel, pensado para operaciones en EE. UU. y la UE.
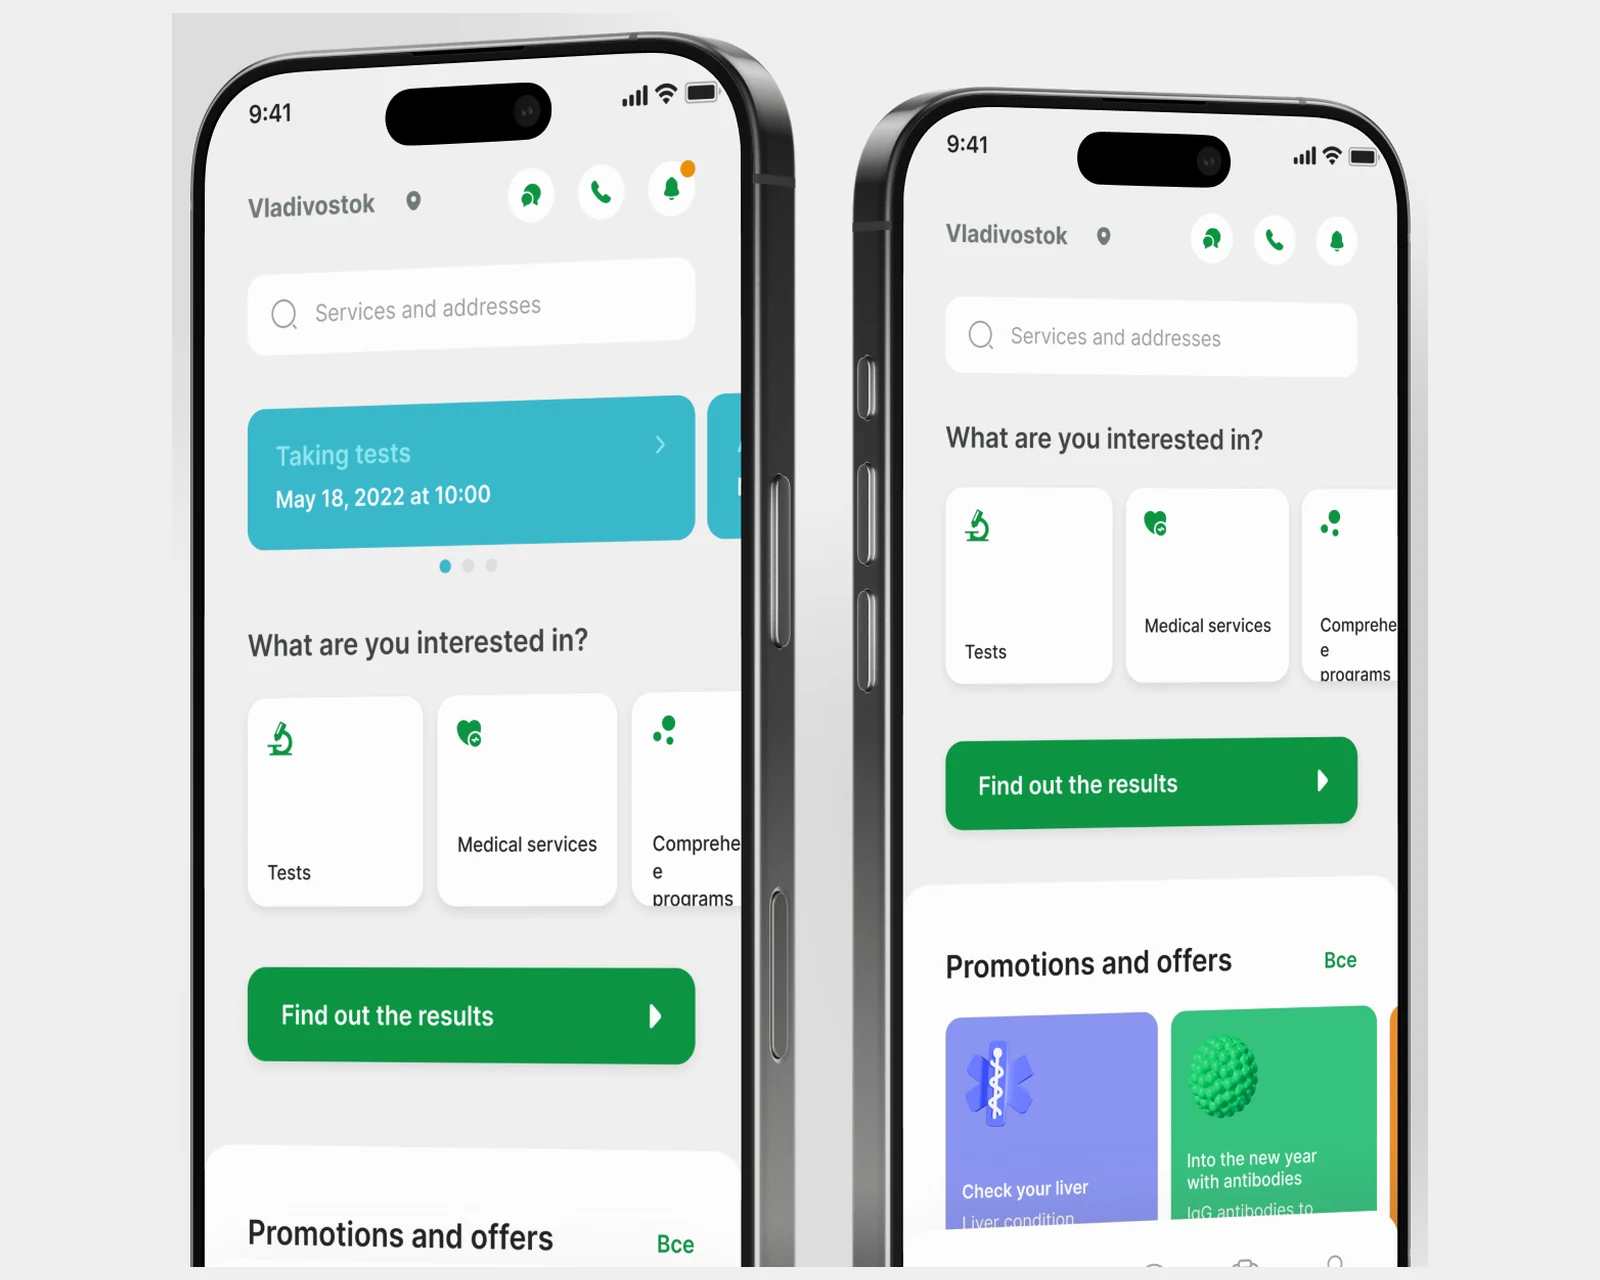
App para pacientes de una red de laboratorios en 40 ciudades: reserva de citas, resultados digitales, más de 2,500 pruebas e integraciones de agenda y contabilidad.
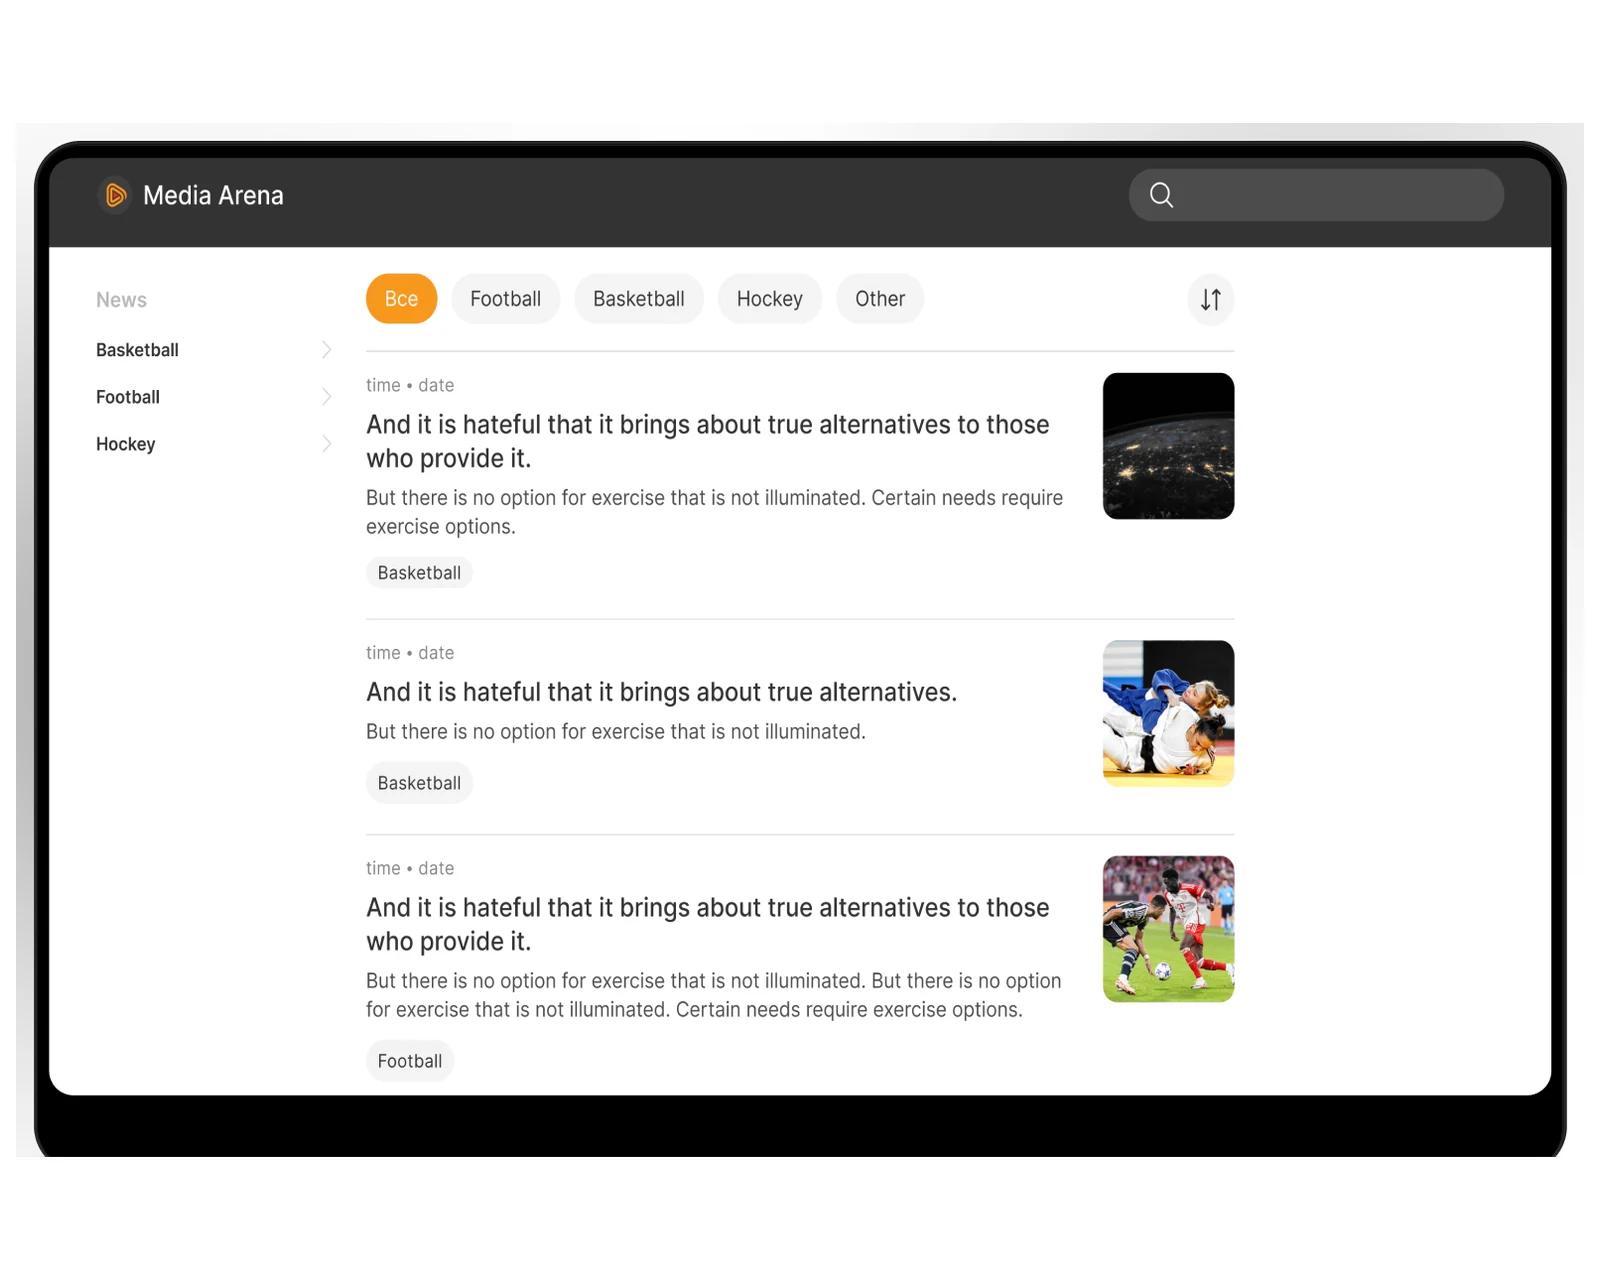
App multiplataforma de noticias deportivas y portal web: CMS mediante un bot de Telegram en lugar de un panel de administración a medida y un pipeline de publicación en Markdown.
Por qué YuSMP
Por defecto autoalojamos en su región o VPC, de modo que los requisitos de RGPD, HIPAA y residencia de datos se cumplen por diseño y no se añaden después.
Hacemos benchmarks de recall, precisión y latencia y ajustamos la búsqueda híbrida y HNSW para que su búsqueda y su RAG mejoren de verdad, y no solo se publiquen.
Un único equipo se hace cargo del esquema, los módulos, el multi-tenancy, el escalado y la integración — sin traspasos entre la estrategia y las personas que escriben el código.
Preguntas frecuentes
pgvector es excelente cuando ya se usa PostgreSQL y los volúmenes de vectores son modestos. Qdrant y Pinecone son bases de datos vectoriales dedicadas, como Weaviate. Weaviate destaca por sus módulos vectorizadores integrados, su búsqueda híbrida de primer nivel y su multi-tenancy nativo, además de poder elegir entre autoalojamiento o Weaviate Cloud. Le ayudamos a elegir según la residencia de datos, la escala y las preferencias operativas, y no según la moda.
La búsqueda híbrida combina la puntuación de palabras clave BM25 con la similitud vectorial en una sola consulta, de modo que se obtienen tanto las coincidencias exactas de términos como el significado semántico. Al ajustar la ponderación alpha y añadir reranking, ofrecemos una relevancia que ni la búsqueda puramente por palabras clave ni la puramente vectorial pueden igualar, especialmente en la búsqueda de productos, documentos y bases de conocimiento.
Weaviate puede generar embeddings por usted mediante módulos conectables para proveedores y modelos autoalojados, de modo que los vectores se crean en la importación y en la consulta sin un pipeline aparte. Configuramos el módulo adecuado para su dominio o conectamos sus propios embeddings cuando necesita un control total sobre el modelo.
Sí. Weaviate tiene un multi-tenancy nativo que aísla los datos de cada tenant dentro de una colección, con activación y eliminación por tenant. Diseñamos el modelo de tenants, gestionamos la estrategia de activación y nos aseguramos de que el aislamiento y la supresión por tenant escalen a grandes cantidades de clientes.
El autoalojamiento en Docker o Kubernetes da un control total sobre la residencia de datos, el coste y el ajuste, y es nuestra opción por defecto en los casos de HIPAA y de RGPD estricto. Weaviate Cloud reduce la carga operativa y encaja muy bien cuando la residencia lo permite. Evaluamos ambas opciones según su cumplimiento, su escala y la capacidad de su equipo, y podemos migrar en cualquier dirección.
Weaviate escala horizontalmente con sharding y replicación, mientras que el ajuste de HNSW, la cuantización de vectores y la caché mantienen bajo control la memoria y la latencia. Hacemos benchmarks de recall y latencia con su volumen objetivo, dimensionamos los nodos en consecuencia y planificamos una vía de escalado para que el rendimiento se mantenga a medida que crecen los datos y los tenants.
Autoalojar Weaviate dentro de la UE mantiene todos los objetos y embeddings en la jurisdicción que usted elija, de modo que los datos personales nunca salen de su control. Combinado con el aislamiento multi-tenant y la eliminación por tenant, esto respalda la residencia de datos, el derecho de supresión y el conjunto de sus obligaciones del RGPD.
Respuesta en 1 día hábil. NDA a petición.
Cuéntenos algunos detalles y un consultor sénior le responderá en un día hábil.