Diseño de índices y namespaces
Elegir de antemano dimensiones, métricas y límites de namespaces es difícil, y una mala elección obliga a una costosa reindexación una vez en producción.

Pinecone Serverless Base de datos vectorial Gestionado
La base de datos vectorial Pinecone da a su capa de recuperación un servicio serverless totalmente gestionado, sin shards, réplicas ni planificación de capacidad de los que ocuparse. Diseñamos y entregamos sistemas de búsqueda y RAG sobre Pinecone para empresas de EE. UU. y la UE: multi-tenancy basada en namespaces, búsqueda híbrida con filtros por metadatos y pipelines de embeddings integrados en su producto. Tanto si necesita cobertura HIPAA en EE. UU. como un índice en una región de la UE por la residencia de datos, lo construimos para que sea preciso, rápido y esté listo para auditoría.
La base de datos vectorial Pinecone da a su capa de recuperación un servicio serverless totalmente gestionado, sin shards, réplicas ni planificación de capacidad de los que ocuparse. Diseñamos y entregamos sistemas de búsqueda y RAG sobre Pinecone para empresas de EE. UU. y la UE: multi-tenancy basada en namespaces, búsqueda híbrida con filtros por metadatos y pipelines de embeddings integrados en su producto. Tanto si necesita cobertura HIPAA en EE. UU. como un índice en una región de la UE por la residencia de datos, lo construimos para que sea preciso, rápido y esté listo para auditoría.
Retos
Elegir de antemano dimensiones, métricas y límites de namespaces es difícil, y una mala elección obliga a una costosa reindexación una vez en producción.
Los filtros de metadatos pesados o mal indexados pueden ralentizar las consultas y sesgar el recall, sobre todo a medida que crecen la cardinalidad y el tamaño del corpus.
Es fácil gastar de más en unidades de lectura y escritura serverless cuando los patrones de consulta, el top-k y la frecuencia de actualización no se ajustan a la carga de trabajo.
Servir a muchos clientes o espacios de trabajo desde un mismo índice exige un aislamiento estricto para que ningún inquilino pueda ver o alterar jamás los vectores de otro.
Mantener el índice coherente con una fuente de verdad cambiante (registros nuevos, actualizados y eliminados) es una fuente recurrente de resultados obsoletos o ausentes.
Una capa de recuperación acoplada estrechamente a un proveedor resulta difícil de mover, de auditar o de comparar con alternativas más adelante.
Soluciones
Aprovisionamos índices serverless con la métrica y las dimensiones adecuadas y modelamos los namespaces en torno a inquilinos o dominios para que el crecimiento nunca obligue a reconstruir.
Combinamos vectores densos y dispersos con filtros de metadatos selectivos y bien diseñados para aumentar la precisión sin elevar la latencia de las consultas.
Cada cliente se aísla por namespace con claves de API acotadas y salvaguardas en las consultas, de modo que los datos nunca puedan cruzar los límites entre inquilinos.
Ajustamos el top-k, el batching, la cadencia de actualización y la granularidad del índice, y monitorizamos las unidades de lectura y escritura para que el gasto siga al valor real y no al desperdicio.
Construimos pipelines de ingesta idempotentes que calculan embeddings, hacen upsert y eliminan al ritmo de sus datos de origen, manteniendo el índice actualizado y coherente.
Exponemos la recuperación mediante un servicio FastAPI limpio y una capa de LangChain/LlamaIndex, e integramos Pinecone de extremo a extremo en su RAG o en el backend de su producto.
Stack
Pinecone serverless, namespaces, filtrado por metadatos, búsqueda híbrida, embeddings, LlamaIndex/LangChain, regiones de AWS/GCP/Azure, FastAPI.
Cumplimiento
RGPD · región de la UE · HIPAA (BAA) · SOC 2
Casos

Clientes nativos de firma electrónica para iOS y Android con un CRM en Symfony + React para un despacho de abogados internacional: onboarding con KYC y una cadena de evidencias defendible para asuntos de EE. UU. y la UE.
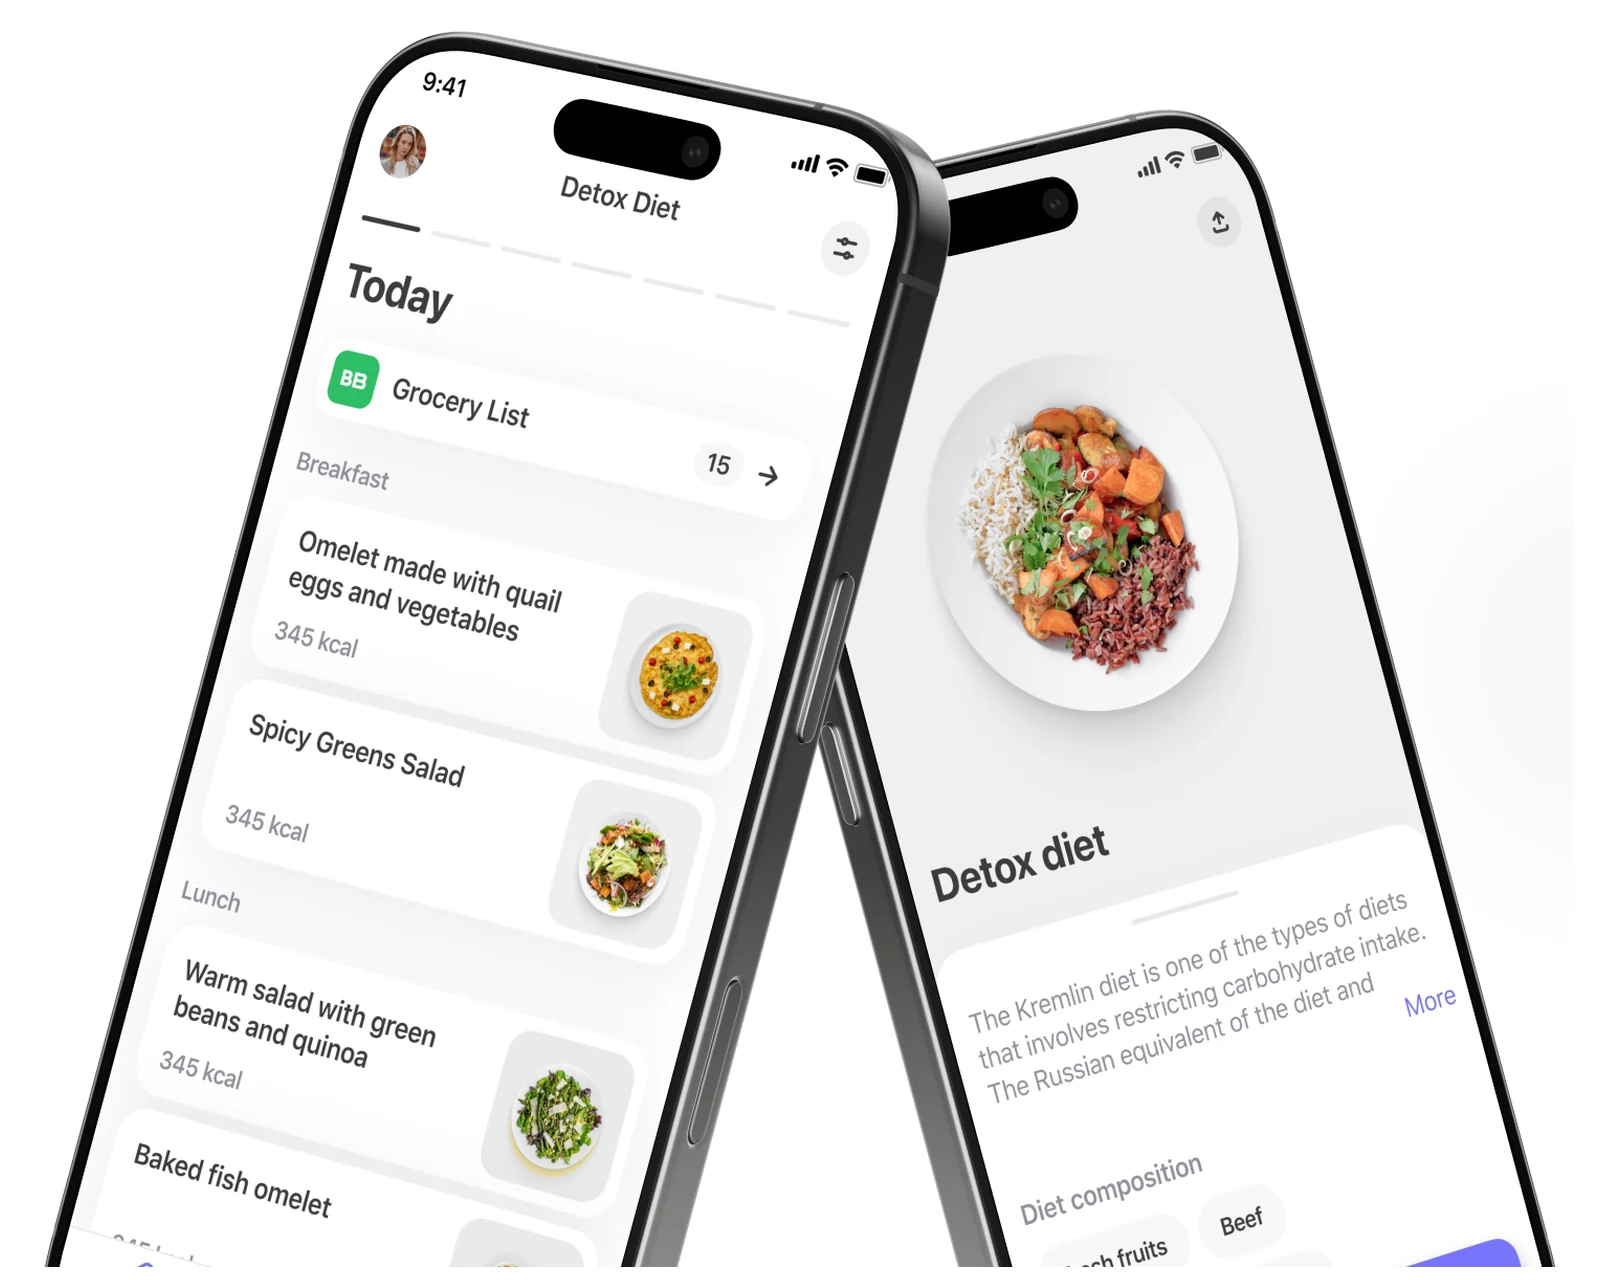
App multiplataforma de dieta y planificación de comidas en Flutter: motor de calorías, biblioteca de recetas, plan semanal de comidas y pedido de la compra.
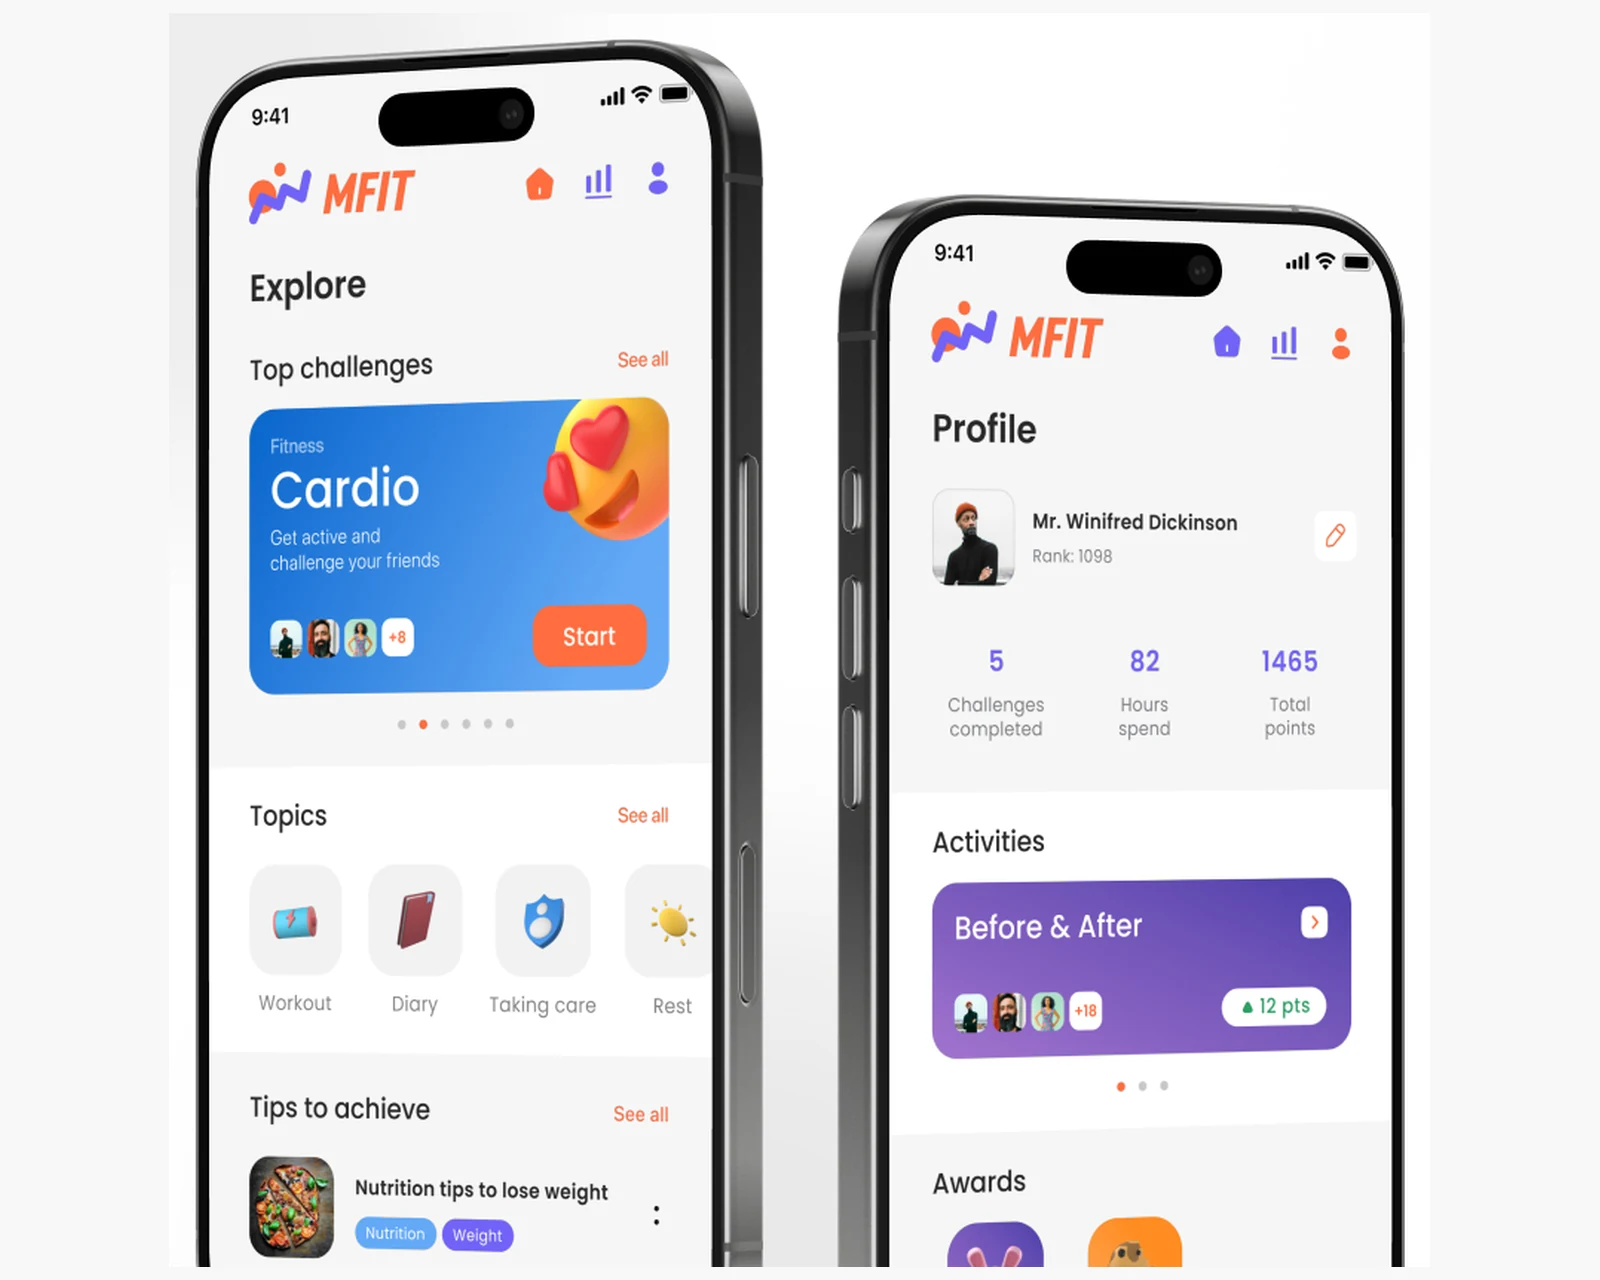
App nativa para iOS y Android de maratones y retos de fitness: programas, estadísticas y clasificaciones sobre un backend en Laravel, para EE. UU. y la UE.
Por qué YuSMP
Diseñamos los índices en torno al RGPD, los BAA de HIPAA, SOC 2 y la residencia de datos en la UE desde el primer día, no como un añadido cuando preguntan los auditores.
Pinecone serverless elimina la gestión de shards, réplicas y capacidad, de modo que su equipo escala la recuperación sin operar un clúster vectorial; nosotros lo mantenemos ajustado y eficiente en costes.
Trabaja con ingenieros sénior que han entregado sistemas de recuperación y RAG en producción, no con generalistas que aprenden vectores a su costa.
Preguntas frecuentes
Pinecone gana cuando se quiere un índice serverless totalmente gestionado, sin clúster que operar y con un escalado predecible. pgvector es excelente si sus datos ya viven en Postgres y los volúmenes son modestos; Qdrant y Weaviate encajan con equipos que quieren autoalojamiento y un control profundo. Le ayudamos a sopesar la carga operativa, la escala y el cumplimiento y construimos sobre la opción que mejor encaje, incluida una abstracción portable si quiere tener opciones.
Pinecone serverless factura por unidades de lectura, unidades de escritura y datos almacenados en lugar de pods fijos, así que se paga por uso. El coste depende del volumen de consultas, el top-k, la frecuencia de actualización y el tamaño del corpus. Ajustamos esas palancas y monitorizamos el consumo de unidades para que el gasto se mantenga proporcional al valor y no derive al alza.
Los namespaces particionan un único índice para que los vectores de cada inquilino se consulten de forma aislada, sin sobrecarga adicional de índices. Los combinamos con claves de API acotadas y salvaguardas en el momento de la consulta para que un cliente solo pueda leer y escribir en su propio namespace, lo que mantiene el SaaS multi-tenant limpio y eficiente en costes.
Cada vector puede llevar metadatos (inquilino, idioma, tipo de documento, fecha, permisos) y las consultas pueden filtrar por ellos en el servidor. Así se acotan los resultados a lo que un usuario tiene permitido y probablemente quiere, y combinado con la búsqueda híbrida mejora mucho la precisión.
Sí: en los planes enterprise, Pinecone firma un BAA. Diseñamos los índices que contienen PHI con cifrado, claves de mínimo privilegio, segregación por namespace y registro de auditoría, de modo que la recuperación en el sector sanitario cumpla HIPAA, y mantenemos la PII en metadatos controlados en lugar de dejar que se filtre a los embeddings.
Sí. Aprovisionamos índices en una región cloud de la UE (AWS o GCP) para que los vectores y los metadatos permanezcan dentro de la jurisdicción elegida, lo que respalda los requisitos del RGPD y de residencia de datos. También mantenemos la PII filtrable para poder atender las solicitudes de supresión por registro o por namespace.
Mantenemos la recuperación tras una interfaz limpia y somos dueños del pipeline de embeddings, de modo que los vectores puedan reingestarse en otro almacén si cambian las necesidades. Usar abstracciones de LangChain/LlamaIndex y una ingesta independiente del proveedor hace que cambiar sea una migración, no una reescritura.
Respuesta en 1 día hábil. NDA a petición.
Cuéntenos algunos detalles y un consultor sénior le responderá en un día hábil.