Ir al contenido principal

Postgres 17 pgvector Preparado para el RGPD PITR

Servicios de PostgreSQL para sistemas de producción de alto rendimiento

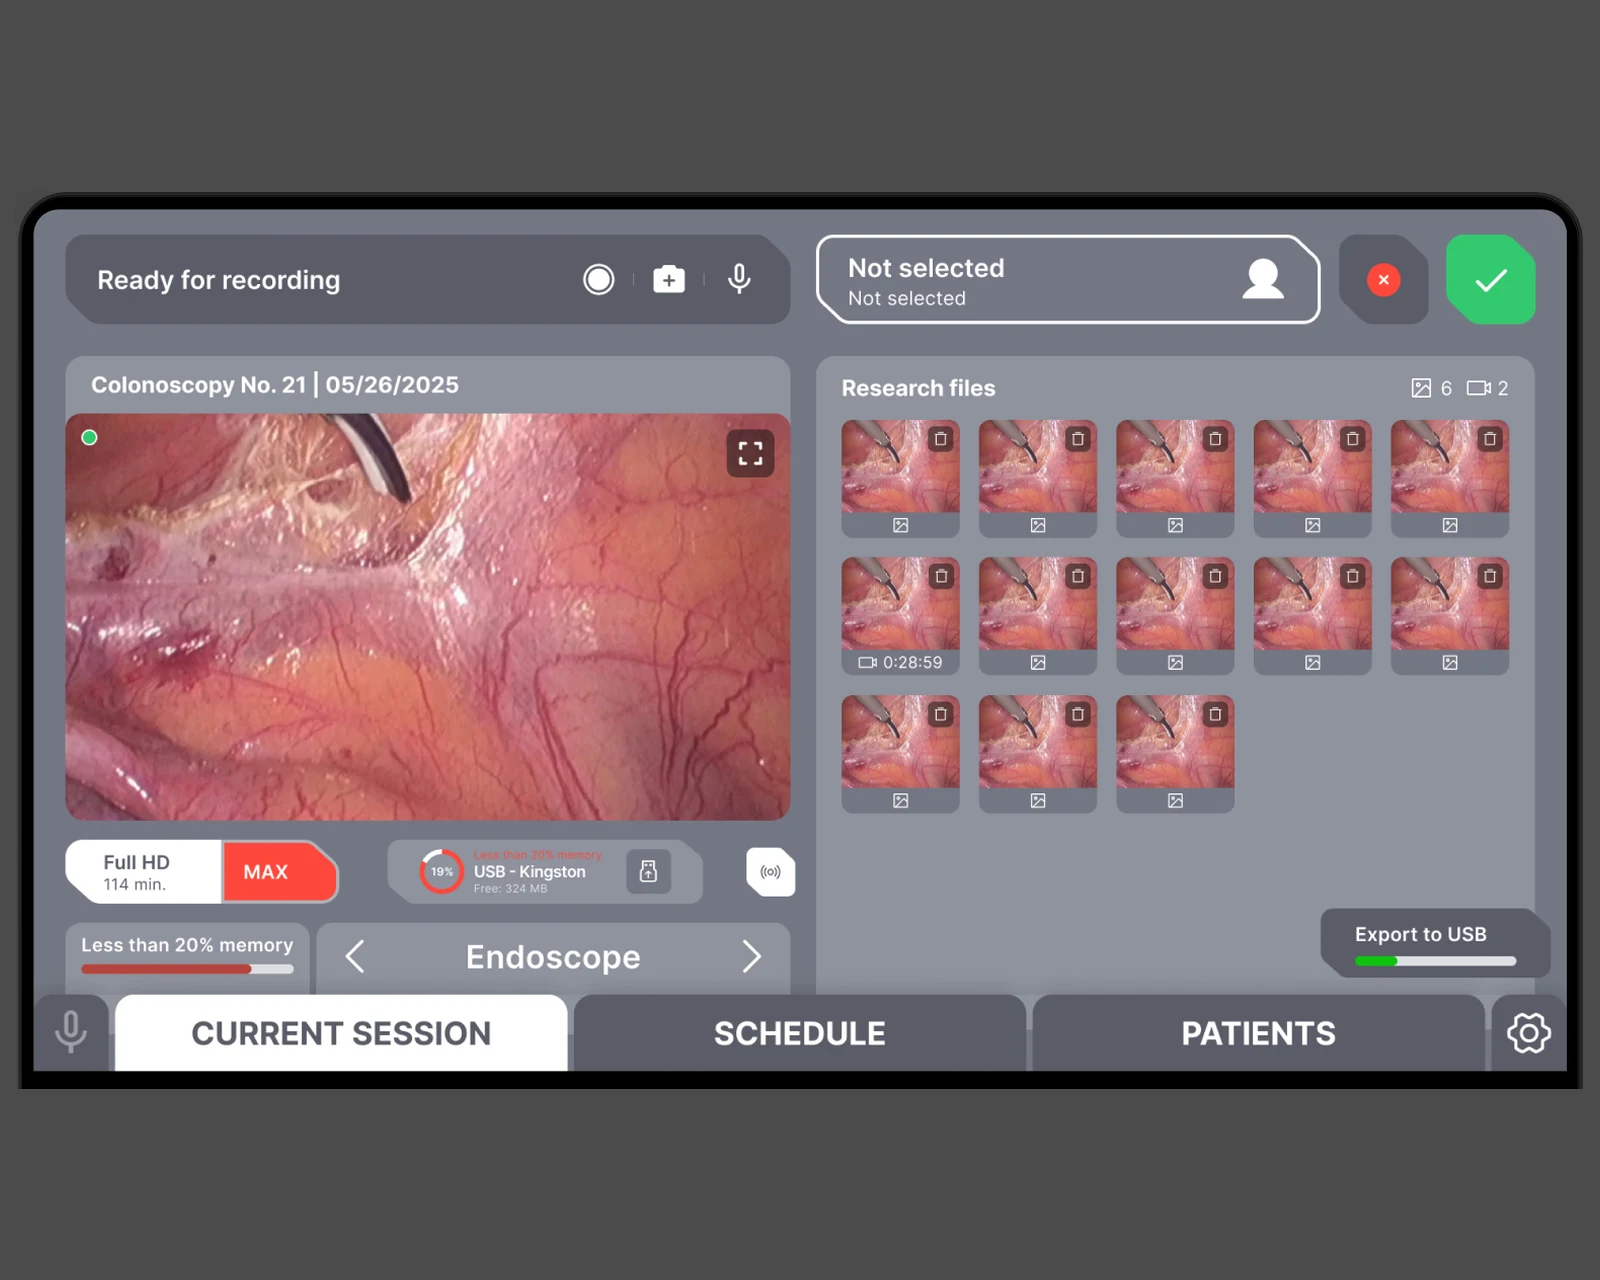
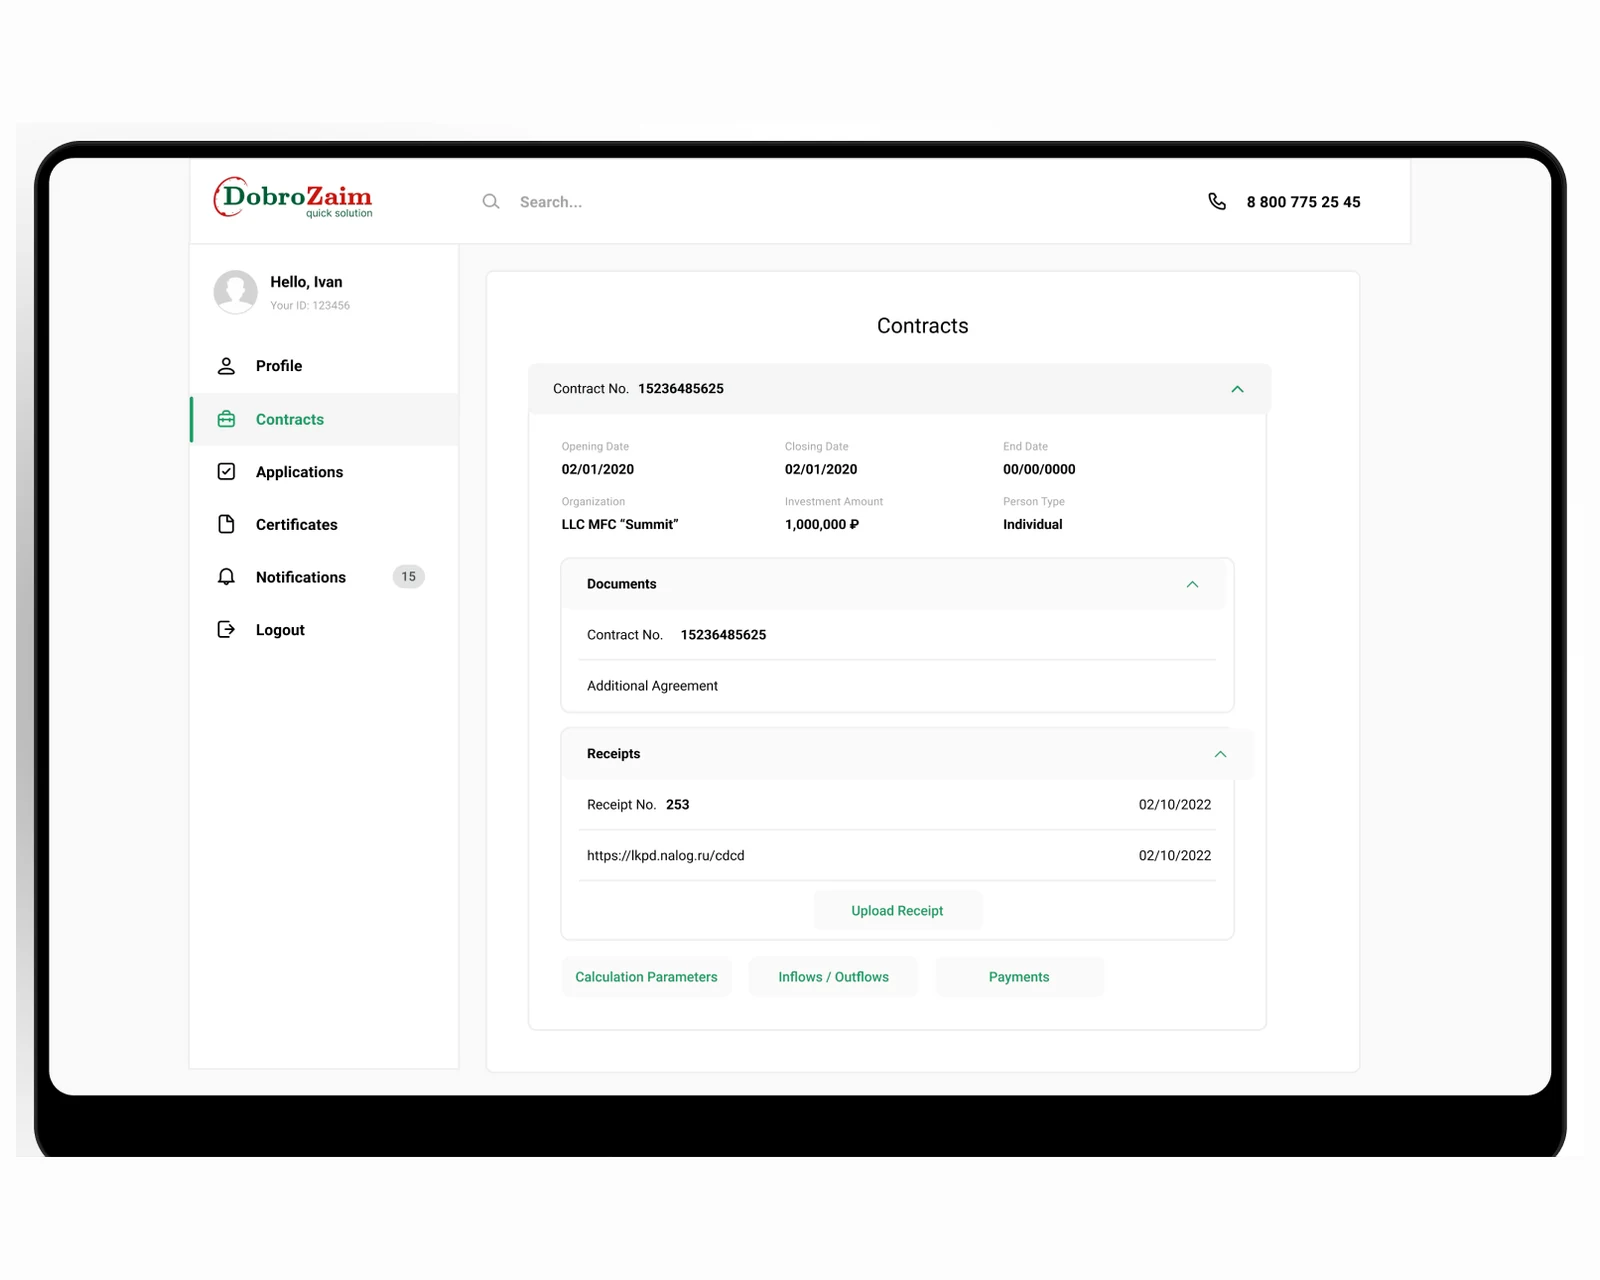
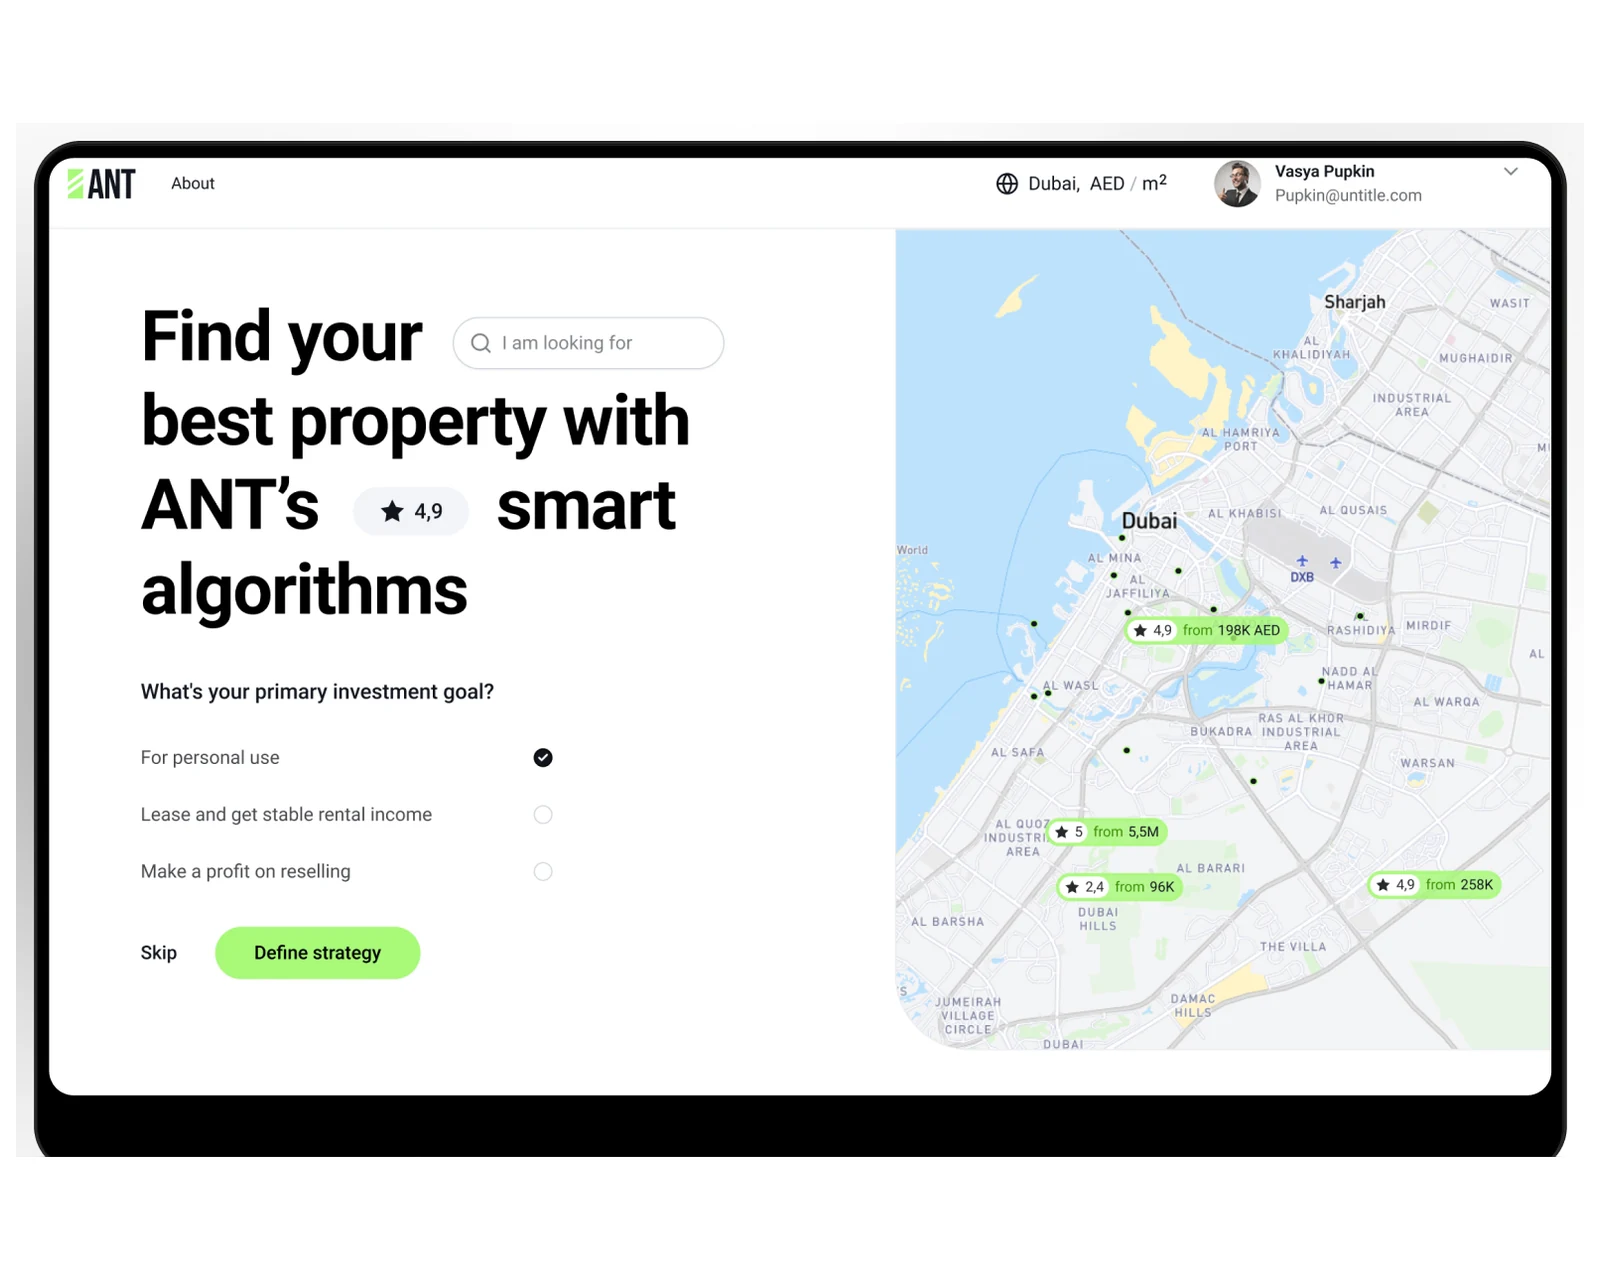
Cuarenta y dos de nuestros sistemas en producción funcionan sobre PostgreSQL: el motor de decisiones de crédito de Loan Conveyor, que procesa miles de decisiones al día; el marketplace PropTech de ANT, con búsqueda de texto completo y consultas geoespaciales; y la estación de trabajo clínica de ArgoView, con metadatos DICOM y embeddings de pgvector. Diseño de esquemas, ajuste de consultas, particionado, replicación lógica y alta disponibilidad: todo está en nuestro portafolio.

Pedir propuesta Ver casos

Base de datos relacional PostgreSQL para gestionar datos estructurados de aplicaciones

Ofrecemos ingeniería con PostgreSQL para plataformas SaaS que necesitan diseño de esquemas, optimización de consultas y configuración de alta disponibilidad desde el principio; para sistemas fintech y healthtech que requieren esquemas con pista de auditoría, seguridad a nivel de fila y borrado conforme con el RGPD; para equipos de IA que añaden pgvector para RAG y búsqueda semántica sin introducir infraestructura nueva; y para sectores regulados donde las copias de seguridad PITR, la residencia de datos y el cifrado en reposo son requisitos de entrega.

Retos

Retos del sector que resolvemos

Consultas lentas con más de 100 M de filas

Los recorridos completos de tablas grandes revientan los presupuestos de tiempo de las consultas. Ejecutamos EXPLAIN (ANALYZE, BUFFERS), añadimos índices parciales y de expresión específicos e implementamos particionado declarativo para reducir el alcance de los recorridos.
Retraso de autovacuum e hinchazón de tablas

Las cargas con muchas actualizaciones acumulan tuplas muertas más rápido de lo que autovacuum puede limpiarlas. Ajustamos los umbrales de autovacuum por tabla y programamos VACUUM ANALYZE explícitos en las tablas más activas en las ventanas de poco tráfico.

Fugas por mala configuración de RLS multi-tenant

Las políticas de RLS ausentes o mal configuradas filtran filas entre tenants en la capa de base de datos. Aplicamos RLS en todas las tablas, escribimos pruebas de aislamiento entre tenants y añadimos filas canario que lanzan una alerta si aparecen en la consulta de otro tenant.

Elección del índice de pgvector

Elegir entre HNSW e IVFFlat para pgvector depende de los requisitos de recall, de la frecuencia de actualización y del SLA de latencia de las consultas. Comparamos ambos con la forma de sus datos antes de comprometernos con un tipo de índice.

Retraso de la replicación lógica en primarios con mucha carga

Un gran volumen de escritura hace que los slots de replicación acumulen WAL y que el disco crezca hasta niveles peligrosos. Supervisamos el retraso de los slots, fijamos protecciones con wal_keep_size e implementamos failover de slots para un cutover sin pérdida de datos.

Adaptación al derecho de supresión del RGPD

Anonimizar datos personales (PII) en un esquema existente sin diseño de borrado lógico exige una planificación cuidadosa de la migración. Diseñamos el borrado en los esquemas nuevos y proporcionamos playbooks de migración para los existentes.

Soluciones

Soluciones que desarrollamos

Diseño de esquemas y modelado DDD

Diseño de esquemas orientado al dominio, con límites de agregado claros, tablas de auditoría, borrado lógico y políticas de RLS incorporados desde la primera migración.

Ajuste del rendimiento y auditorías con EXPLAIN

Análisis de planes de consulta, recomendación de índices, dimensionamiento del pool de conexiones y ajuste de autovacuum, entregados como un informe de corrección priorizado.

Particionado a gran escala

Particionado declarativo por rango, lista y hash con automatización mediante pg_partman para tablas de series temporales y multi-tenant.

Índices de pgvector para RAG

Configuración de índices HNSW e IVFFlat para la búsqueda semántica y la recuperación en RAG, comparados con su corpus antes del despliegue en producción.

Alta disponibilidad y PITR

Patroni o RDS Multi-AZ con pgBouncer, archivado continuo con WAL-G y procedimientos de recuperación a un punto en el tiempo probados.

Migraciones con replicación lógica

Actualizaciones de versión mayor y migraciones entre nubes sin tiempo de inactividad, mediante replicación lógica con ventanas de cutover de menos de 60 segundos.

Stack

Stack tecnológico

PostgreSQL 17, pgvector, pg_partman, pg_stat_statements, pgBouncer, Patroni, WAL-G, TimescaleDB, PostGIS, replicación lógica, RDS, Aurora, EXPLAIN (ANALYZE).

Cumplimiento

Cumplimiento y normativa

Alineado con el RGPD · apto para HIPAA · apto para SOC 2 · PCI DSS contemplado

UE

  • RGPD — residencia de datos, derecho de supresión y automatización de solicitudes de derechos (DSR) mediante RLS.
  • ISO 27001 — cifrado en reposo, control de acceso y registro de auditoría.
  • DORA — documentación de PITR y de recuperación ante desastres para sistemas TIC financieros.
  • eHDSI / RGPD — residencia y seudonimización de datos de salud.

EE. UU.

  • HIPAA — cifrado en reposo y en tránsito, registro de auditoría y cobertura de BA.
  • PCI DSS Req 3.4 — enmascaramiento del PAN, tokenización y cifrado de datos de tarjetas.
  • SOC 2 — evidencias de pruebas de copias de seguridad, revisión de accesos y control de cambios.
  • CCPA — implementación del derecho de eliminación y playbooks de anonimización.

Común: TLS en tránsito, pgcrypto para el cifrado de columnas, SBOM para las extensiones.

Por qué YuSMP

Por qué los equipos eligen YuSMP para PostgreSQL

42 sistemas en producción sobre Postgres

Más experiencia en producción con PostgreSQL que con cualquier otra base de datos de nuestro portafolio: motores de decisión fintech, sistemas clínicos healthtech y marketplaces de mucho tráfico.

pgvector para IA en su stack actual

Añadimos búsqueda semántica y recuperación RAG a su PostgreSQL sin introducir infraestructura nueva: índices HNSW, joins SQL y consistencia ACID.

Supresión según el RGPD y preparado para HIPAA

Derecho de supresión, playbooks de anonimización y pruebas de copias de seguridad PITR: se diseñan dentro del esquema y no se improvisan en el momento de la auditoría.

Preguntas frecuentes

Preguntas frecuentes sobre PostgreSQL

¿Cómo ajustan PostgreSQL para tablas grandes (más de 100 M de filas)?

Particionado declarativo (por rango o lista) para reducir el alcance de los recorridos, indexación específica con índices parciales y de expresión, ajuste de autovacuum para evitar la hinchazón de tablas y análisis de planes de consulta con EXPLAIN (ANALYZE, BUFFERS). También evaluamos pg_partman para la gestión automatizada de particiones y TimescaleDB para cargas de series temporales.

¿Cómo implementan la seguridad a nivel de fila multi-tenant?

Políticas de Row-Level Security de PostgreSQL con una variable de contexto current_setting('app.tenant_id'), aplicadas en la capa de base de datos y no solo en la de aplicación. Cada SELECT, INSERT, UPDATE y DELETE se filtra mediante RLS. Escribimos pruebas canario entre tenants para verificar el aislamiento.

¿pgvector o una base de datos vectorial dedicada?

pgvector sobre su PostgreSQL actual para los equipos que quieren consistencia transaccional entre la búsqueda vectorial y los datos relacionales: sin infraestructura nueva, con joins SQL y garantías ACID. Qdrant o Weaviate dedicados para cargas que requieren búsqueda vectorial filtrada a gran escala (más de 100 M de vectores) o indexación multimodal. Tenemos experiencia en producción con ambos.

¿Cómo configuran la alta disponibilidad de PostgreSQL?

Patroni on-premises o en VM en la nube para failover automático con quórum de etcd. RDS Multi-AZ o Aurora PostgreSQL en la nube gestionada. Añadimos pooling de conexiones con pgBouncer en modo transacción delante de cualquier configuración de alta disponibilidad y probamos el failover con tráfico real de la aplicación en staging.

¿Cómo gestionan las copias de seguridad y la recuperación a un punto en el tiempo de PostgreSQL?

WAL-G para el archivado continuo de WAL en S3 o GCS, que permite la recuperación a un punto en el tiempo en cualquier segundo dentro de la ventana de retención. pg_dump para copias de seguridad lógicas de bases de datos individuales. Probamos la recuperación en un entorno de staging cada semana y documentamos el RTO en su runbook de recuperación ante desastres.

¿Cómo implementan la replicación lógica de PostgreSQL para migraciones sin tiempo de inactividad?

Configuramos la replicación lógica del origen al destino, dejamos que la réplica se ponga al día, abrimos una breve ventana de solo lectura a nivel de aplicación para drenar las escrituras en curso, cambiamos la cadena de conexión y desmontamos la replicación. Ventana de cutover típica: menos de 60 segundos en la mayoría de los stacks de aplicación.

¿Cómo abordan el derecho de supresión del RGPD en PostgreSQL?

Implementamos borrado lógico con una marca de tiempo deleted_at y un trabajo de supresión del RGPD que sustituye las columnas con datos personales (PII) por un hash SHA-256 del identificador del interesado. Para la anonimización irreversible usamos UPDATE ... RETURNING de PostgreSQL y un registro de auditoría de borrados. El enfoque debe diseñarse dentro del esquema: adaptarlo a un esquema existente requiere una migración planificada.

Haga que PostgreSQL sea rápido, auditable y esté listo para la IA con ingenieros sénior

Respuesta en 1 día hábil. NDA a petición.

Pedir propuesta

Pedir propuesta

Cuéntenos algunos detalles y un consultor sénior le responderá en un día hábil.