Ir al contenido principal

Grafana Dashboards Observabilidad LGTM

Dashboards con Grafana para métricas, logs y trazas unificados

Los dashboards con Grafana reúnen métricas, logs y trazas distribuidas en un único panel, y evitan saltar entre Datadog, Splunk y CloudWatch durante un incidente. Diseñamos y desplegamos entornos Grafana de producción con el stack LGTM completo (Loki, Grafana, Tempo, Mimir), aprovisionamiento de dashboards como código, SSO y RBAC para equipos de ingeniería de EE. UU. y la UE que necesitan visibilidad operativa sin dependencia del proveedor (vendor lock-in).

Pedir propuesta Ver casos

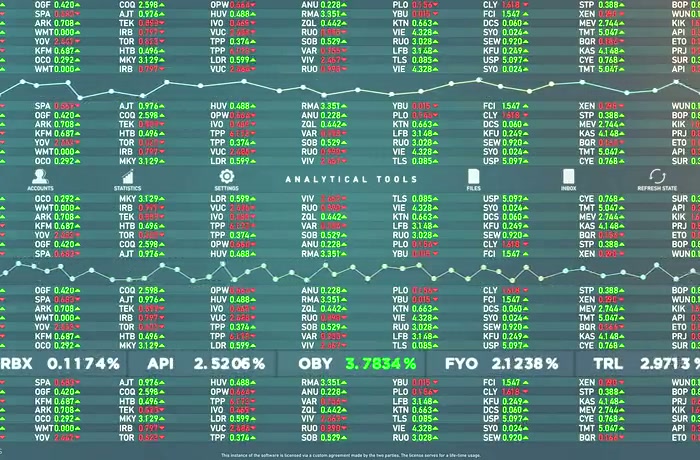
Panel de observabilidad de Grafana con métricas en tiempo real y paneles de monitorización

Los dashboards con Grafana reúnen métricas, logs y trazas distribuidas en un único panel, y evitan saltar entre Datadog, Splunk y CloudWatch durante un incidente. Diseñamos y desplegamos entornos Grafana de producción con el stack LGTM completo (Loki, Grafana, Tempo, Mimir), aprovisionamiento de dashboards como código, SSO y RBAC para equipos de ingeniería de EE. UU. y la UE que necesitan visibilidad operativa sin dependencia del proveedor (vendor lock-in).

Retos

Retos del sector que resolvemos

Proliferación y gobierno de dashboards

Las instancias de Grafana sin gestionar acumulan cientos de dashboards ad hoc con nombres incoherentes, paneles rotos y sin responsable. Encontrar la vista de referencia durante un incidente hace perder minutos críticos.

Seguridad de las fuentes de datos y RBAC

Los permisos amplios sobre las fuentes de datos exponen métricas sensibles de la infraestructura a los equipos equivocados. Sin RBAC a nivel de carpeta ni cuentas de servicio por fuente de datos, cualquier usuario de Grafana puede consultar las bases de datos de producción.

Coherencia de las alertas entre stacks

Los equipos que usan a la vez Grafana Alerting y Prometheus Alertmanager acaban con reglas de alerta duplicadas y contradictorias. La lógica de enrutamiento diverge, se pierden notificaciones y los ingenieros de guardia reciben avisos contradictorios.

Adopción de dashboards como código

Los dashboards creados a mano no se pueden versionar, revisar ni promover entre entornos. Las organizaciones que editan solo desde la interfaz no pueden reproducir su configuración de observabilidad tras una migración de clúster.

Logs, métricas y trazas unificados

Sin un stack LGTM correlacionado, los ingenieros saltan entre interfaces separadas de Prometheus, Loki y Jaeger durante un incidente y pierden tiempo repitiendo la consulta de la misma ventana temporal en herramientas desconectadas.

Integración de SSO y multi-tenancy

Conectar Grafana con los proveedores de identidad corporativos (Okta, Azure AD, Google Workspace) y aplicar el aislamiento de carpetas por equipo exige una configuración SAML/OIDC cuidadosa, en la que es fácil cometer errores sin que se note.

Soluciones

Soluciones que desarrollamos

Estandarización de dashboards como código

Todos los dashboards definidos en JSON/YAML versionado mediante el aprovisionamiento de Grafana: con plantillas, revisados por pares y promovidos de dev a staging y a producción sin un solo clic manual en la interfaz.

Despliegue completo del stack LGTM

Grafana + Loki + Tempo + Mimir desplegados como stack autoalojado o en Grafana Cloud: una única superficie de consulta para logs, trazas distribuidas y métricas de larga retención, sin límites de cardinalidad por métrica.

RBAC, SSO y aislamiento por carpetas

Integración SAML/OIDC con Okta, Azure AD o Google Workspace; RBAC a nivel de carpeta que asigna grupos del IdP a roles de Grafana; cuentas de servicio por fuente de datos con acceso de solo lectura y mínimo privilegio.

Observabilidad correlacionada (logs + métricas + trazas)

Los enlaces de Grafana Explore y las anotaciones de exemplars correlacionan un pico de logs de Loki con una anomalía de métricas de Mimir y con la traza correspondiente de Tempo: la causa raíz con un clic en lugar de tres cambios de herramienta.

Grafana Alerting y OnCall

Las reglas de alerta unificadas en Grafana Alerting sustituyen el doble enrutamiento de Alertmanager; Grafana OnCall gestiona los turnos de escalado, los silencios y las líneas de tiempo de los incidentes, con integraciones con Slack, PagerDuty y Mattermost.

Integración de múltiples fuentes de datos

Dashboards de panel único que combinan Prometheus, Elasticsearch, PostgreSQL, CloudWatch y fuentes de datos de API personalizadas: federación de consultas sin duplicar datos ni montar pipelines ETL.

Stack

Stack tecnológico

Grafana, Grafana Loki (logs), Grafana Tempo (trazas), Grafana Mimir (métricas), Grafana Alerting, Grafana OnCall, Prometheus, OpenTelemetry, Elasticsearch, PostgreSQL, CloudWatch, dashboards como código aprovisionados, SSO/SAML/OIDC, RBAC.

Cumplimiento

Cumplimiento y normativa

RBAC alineado con el RGPD · registro de auditoría para SOC 2 · visibilidad de incidentes para NIS2 · resiliencia operativa para DORA

UE

  • RGPD: el RBAC y los permisos de las fuentes de datos evitan que aparezcan datos personales (PII) en los dashboards; Grafana alojado en infraestructura de la UE; minimización de datos aplicada en la capa de consulta.
  • Reglamento de IA de la UE: los dashboards de observabilidad de modelos registran la latencia de inferencia, las métricas de deriva y las tasas de error para respaldar los requisitos de transparencia de los sistemas de IA.
  • NIS2: la monitorización unificada de servicios e infraestructura aporta la base de visibilidad centralizada de incidentes que exigen las obligaciones de continuidad operativa de NIS2.
  • DORA: los dashboards correlacionados y los turnos de guardia de Grafana OnCall respaldan la documentación de resiliencia operativa y de tiempos de recuperación que DORA exige a las entidades financieras.

EE. UU.

  • SOC 2: los registros de auditoría de Grafana recogen cada cambio de dashboard, cada acceso a fuentes de datos y cada inicio de sesión; la integración con SSO aplica las evidencias de control de acceso que esperan los auditores de SOC 2 Type II.
  • Respuesta a incidentes: Grafana Alerting y OnCall ofrecen los flujos de respuesta a incidentes, documentados y trazables, que exigen los controles de visibilidad operativa de SOC 2 y NIST CSF.
  • Fuentes de datos de mínimo privilegio: cada fuente de datos se aprovisiona con una cuenta de servicio de solo lectura limitada al conjunto de datos mínimo necesario, lo que satisface los requisitos de acceso de mínimo privilegio.
  • Traza de auditoría de los dashboards como código: todas las definiciones de dashboards viven en JSON/YAML versionado; cada cambio se revisa, se aprueba y es trazable, un artefacto limpio para las auditorías de cumplimiento.

Por qué YuSMP

Por qué los equipos de ingeniería eligen YuSMP para la observabilidad con Grafana

Sin dependencia del proveedor

El stack LGTM completo es de código abierto y se puede autoalojar. Diseñamos su plataforma de observabilidad para que los datos, los dashboards y la lógica de alertas sean suyos, y no dependan del modelo de precios de un proveedor SaaS.

Dashboards que sobreviven a la rotación del equipo

Los dashboards versionados y aprovisionados permiten que un ingeniero nuevo reconstruya todo su entorno de observabilidad desde un repositorio Git. No quedan personalizaciones sin documentar hechas solo desde la interfaz.

Resolución de incidentes más rápida

Logs, métricas y trazas correlacionados en una sola interfaz reducen el tiempo medio hasta la causa raíz. Diseñamos nuestras configuraciones de Grafana en torno a los flujos de trabajo que su equipo de guardia usa bajo presión, no en torno a estéticas de demo.

Preguntas frecuentes

Preguntas frecuentes sobre la observabilidad con Grafana

Grafana o Datadog: ¿cuál conviene elegir?

Datadog es un SaaS totalmente gestionado, con una amplia superficie de funciones y precios por uso que se disparan con una cardinalidad alta. Grafana (autoalojado o Grafana Cloud) le da control sobre la residencia de los datos, los precios y el stack LGTM completo. Recomendamos Grafana a los equipos con requisitos del RGPD o de soberanía de datos, con presupuestos de alta cardinalidad de métricas o que prefieren herramientas de código abierto, y Datadog cuando una plataforma gestionada y sin operación propia justifica el coste.

¿Qué es el stack LGTM?

LGTM son las siglas de Loki (agregación de logs), Grafana (visualización y alertas), Tempo (trazado distribuido) y Mimir (métricas escalables de larga retención, sustituto directo de Prometheus). Juntos forman una plataforma de observabilidad autoalojada que cubre los tres pilares de la telemetría (logs, métricas y trazas) bajo una única interfaz de Grafana, sin necesidad de herramientas especializadas independientes para cada tipo de señal.

¿Qué significa «dashboards como código» en Grafana?

El sistema de aprovisionamiento de Grafana lee el JSON de los dashboards y el YAML de las fuentes de datos desde archivos en disco (o desde un repositorio Git mediante herramientas como Grafonnet o Terraform). Así, cada dashboard está versionado, pasa por revisión de código y es reproducible entre entornos. Los cambios se despliegan mediante CI/CD en lugar de ediciones manuales en la interfaz, lo que le da una traza de auditoría completa y la posibilidad de revertir en segundos un cambio de dashboard erróneo.

¿Cómo funciona Grafana con Prometheus?

Prometheus recopila (scrape) las métricas de sus servicios y las almacena localmente; Grafana consulta Prometheus (o Mimir, un backend escalable compatible con Prometheus) mediante PromQL y muestra los resultados en paneles. Grafana no sustituye a Prometheus: es la capa de visualización y alertas que se apoya en él. En una configuración LGTM habitual, Mimir reemplaza el almacenamiento local de Prometheus para la larga retención y la escalabilidad horizontal, mientras que los agentes de Prometheus siguen recopilando métricas en el borde.

¿Cómo se configuran RBAC, SSO y multi-tenancy en Grafana?

Configuramos la integración SAML u OIDC de Grafana con su proveedor de identidad (Okta, Azure AD, Google Workspace). Los grupos del IdP se asignan a roles de organización de Grafana y a permisos de carpeta. Cada equipo ve solo los dashboards y las fuentes de datos asignados a su carpeta. En los despliegues multi-tenant, las organizaciones de Grafana o el RBAC de Grafana Enterprise establecen límites estrictos entre inquilinos, con credenciales de fuente de datos independientes para cada uno.

Loki o Elasticsearch para la agregación de logs: ¿cuál es mejor?

Loki indexa solo etiquetas (no el texto completo), lo que lo hace mucho más barato de operar a escala: almacena fragmentos de logs comprimidos en almacenamiento de objetos (S3, GCS). Elasticsearch indexa todos los campos, lo que permite una potente búsqueda de texto completo, pero con un coste de almacenamiento y de cómputo bastante mayor. Elija Loki cuando controle la estructura de sus logs y consulte sobre todo por etiquetas (servicio, entorno, nivel); elija Elasticsearch cuando necesite búsqueda de texto completo arbitraria sobre logs heredados no estructurados o requiera el ecosistema de Kibana.

¿Conviene autoalojar Grafana o usar Grafana Cloud?

Grafana autoalojado (OSS o Enterprise) le da control total sobre la residencia de los datos, la retención, el coste y la configuración: la opción adecuada cuando hay requisitos estrictos del RGPD o de soberanía de datos, o métricas de gran volumen para las que el precio de Grafana Cloud pasa a ser significativo. Grafana Cloud elimina la carga operativa y ofrece de serie alertas gestionadas, monitorización sintética y observabilidad del frontend. Ayudamos a los equipos a evaluar las concesiones entre desarrollar o comprar, y podemos configurar o migrar cualquiera de las dos opciones.

Despliegue una observabilidad con Grafana de nivel de producción con ingenieros sénior de plataforma

Respuesta en 1 día hábil. NDA a petición.

Pedir propuesta

Pedir propuesta

Cuéntenos algunos detalles y un consultor sénior le responderá en un día hábil.