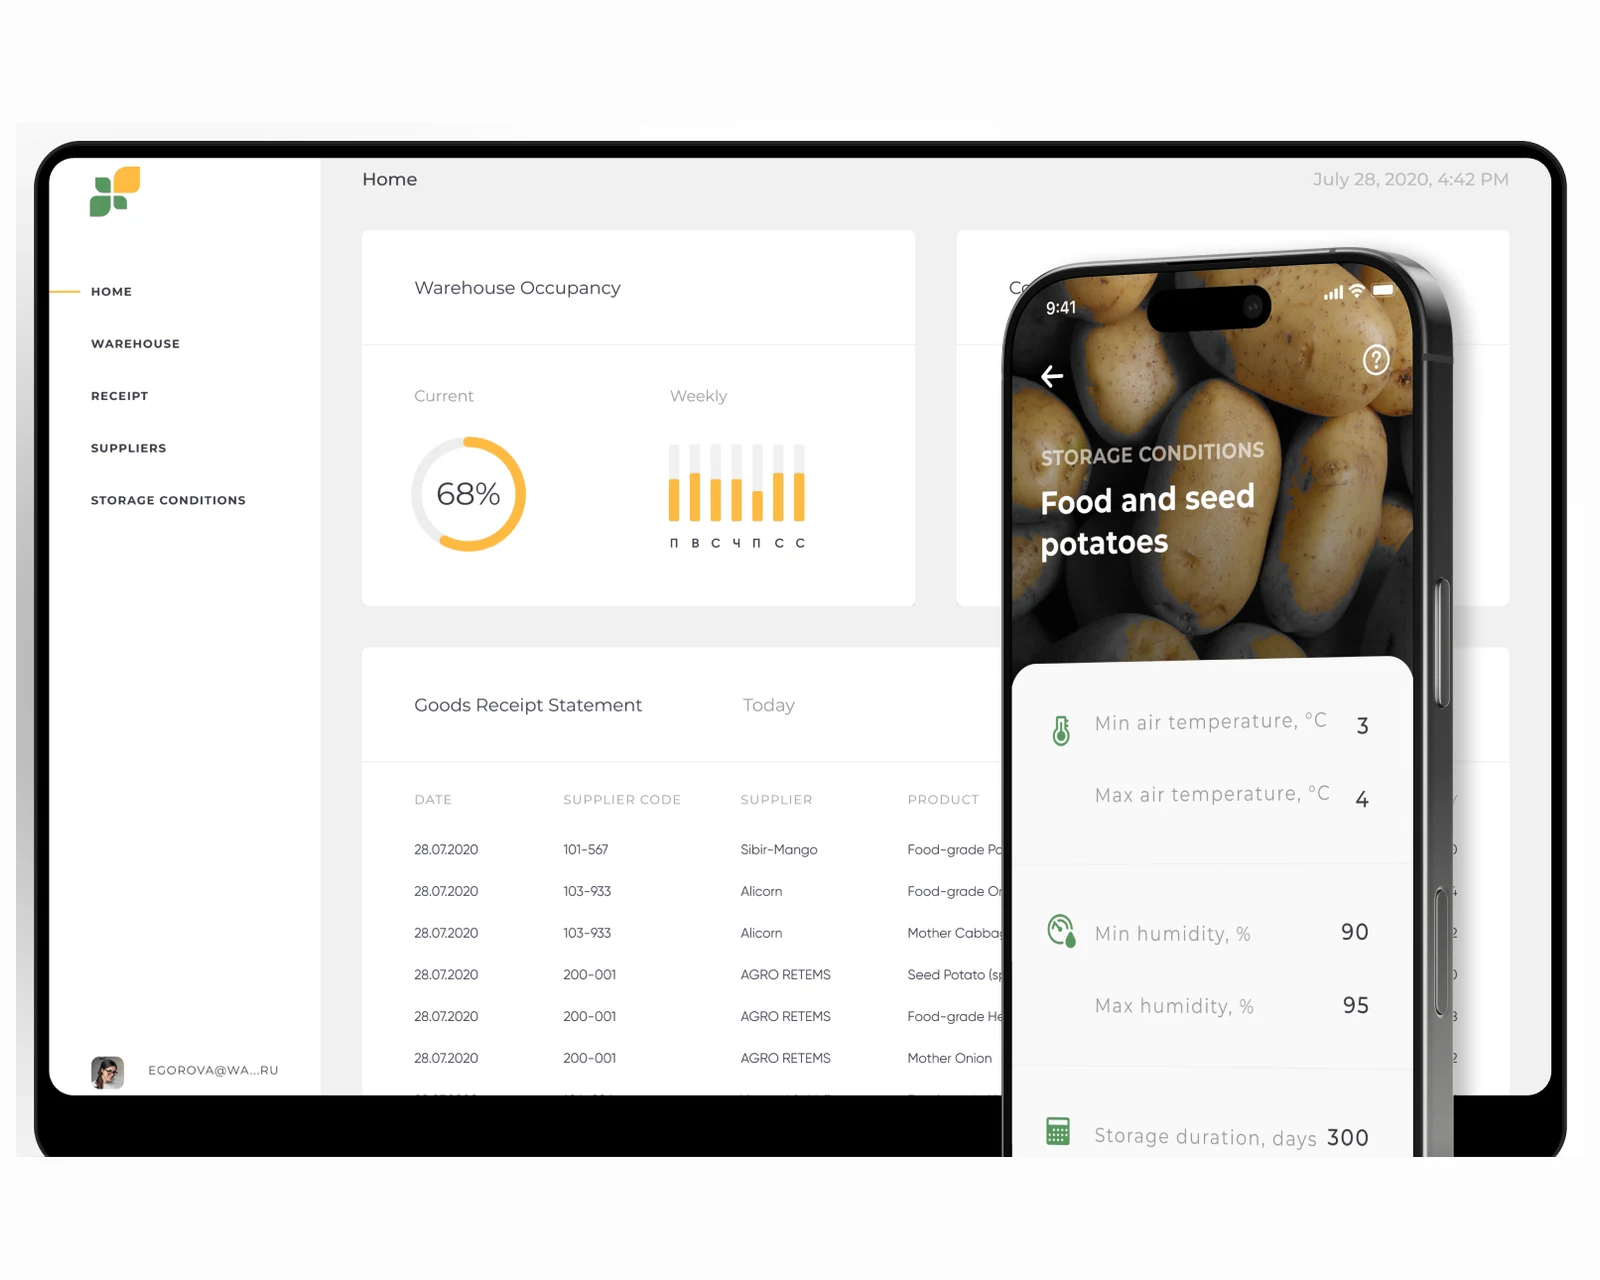
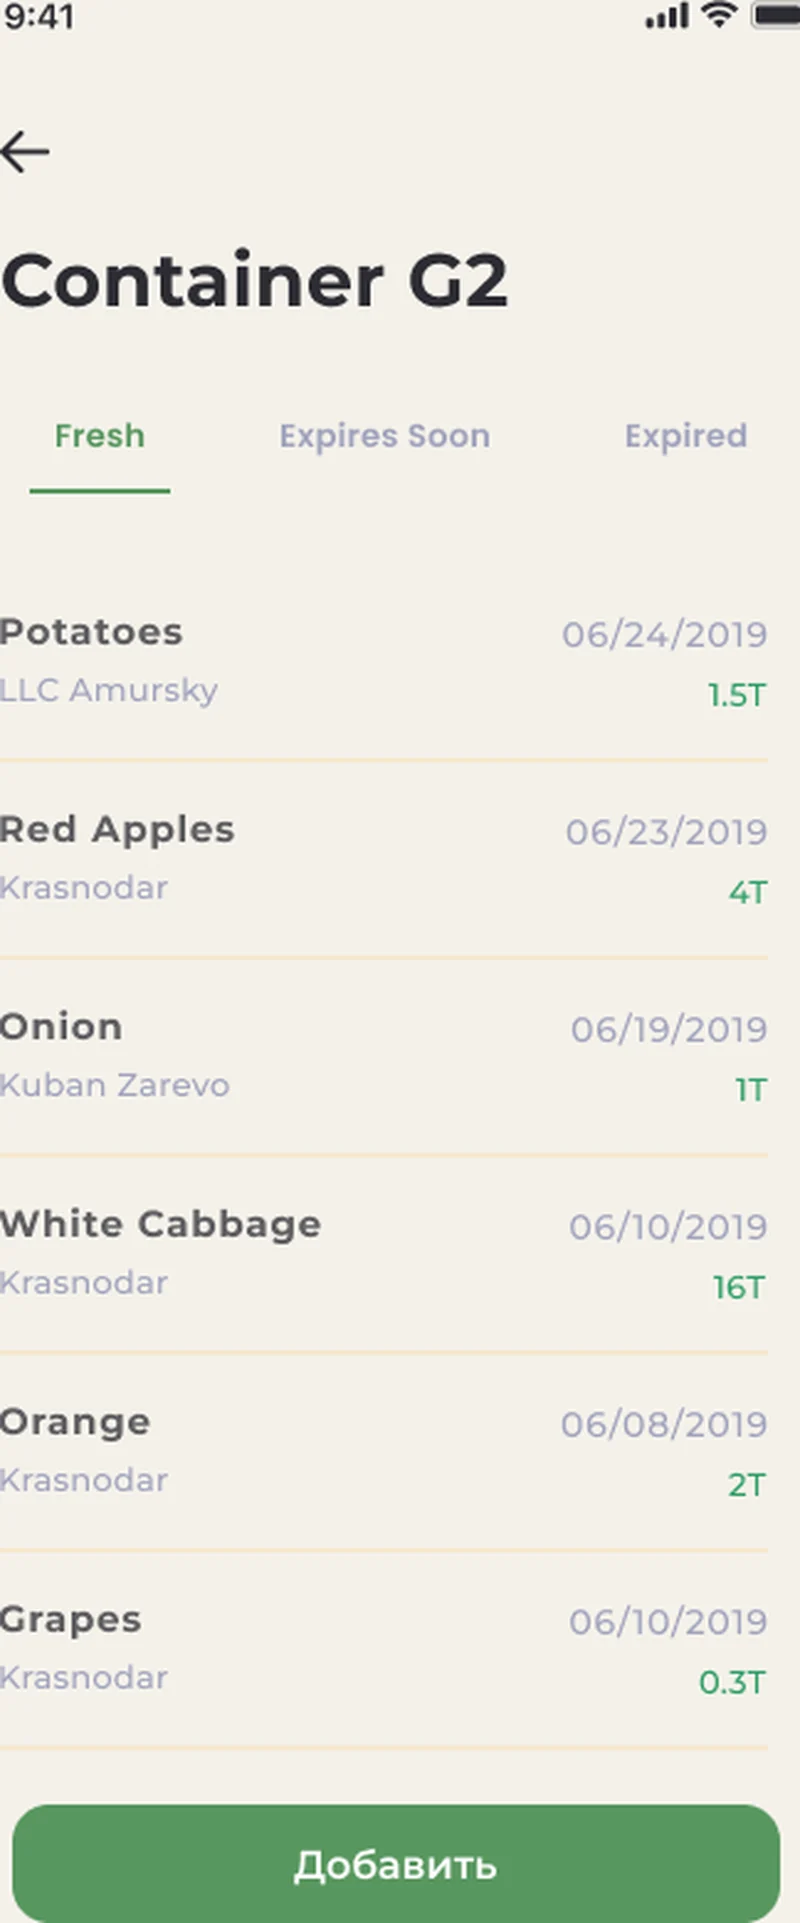
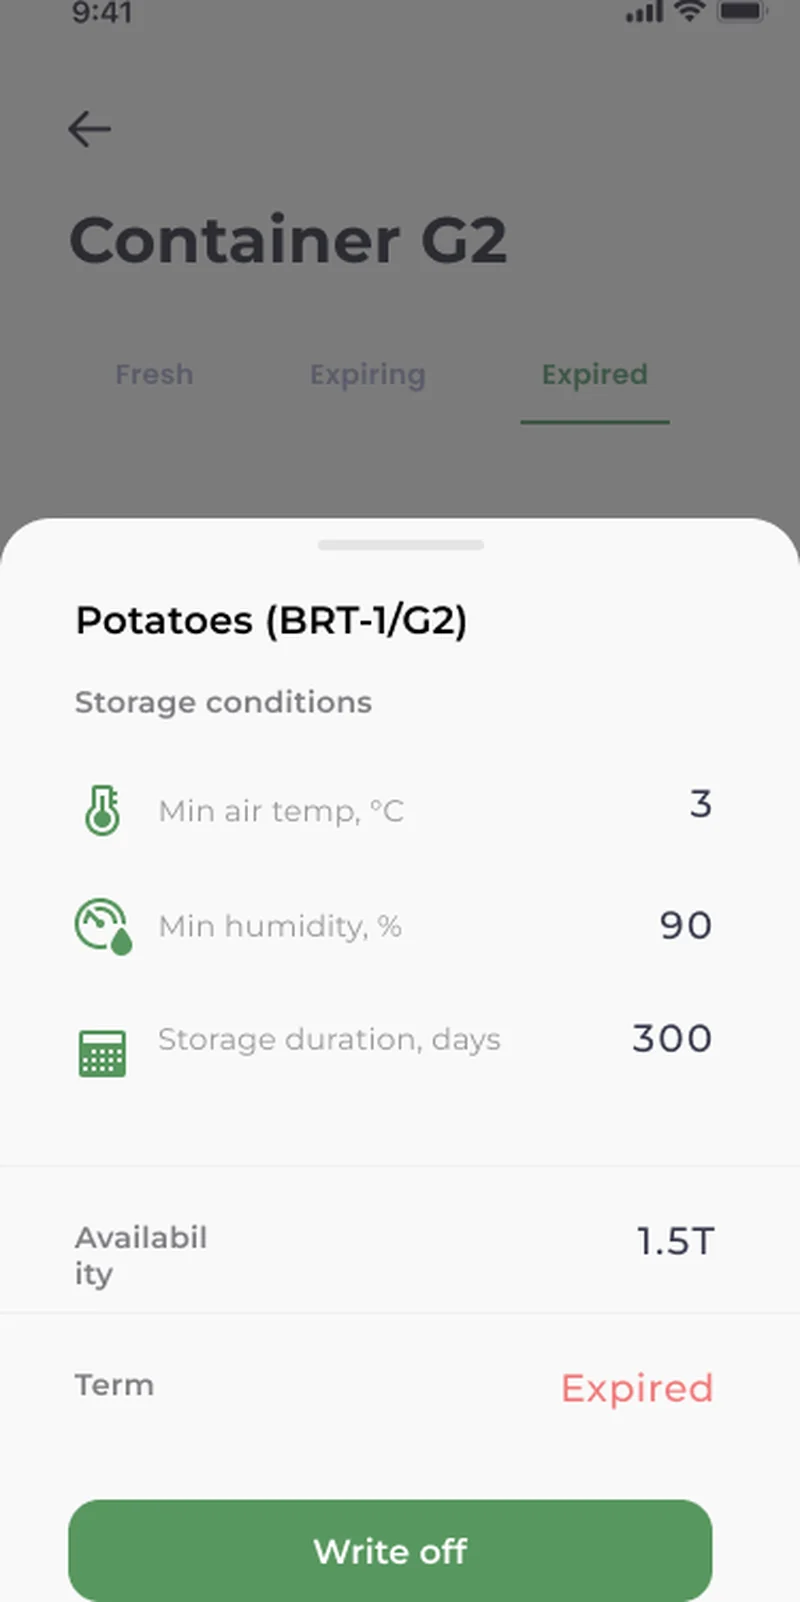
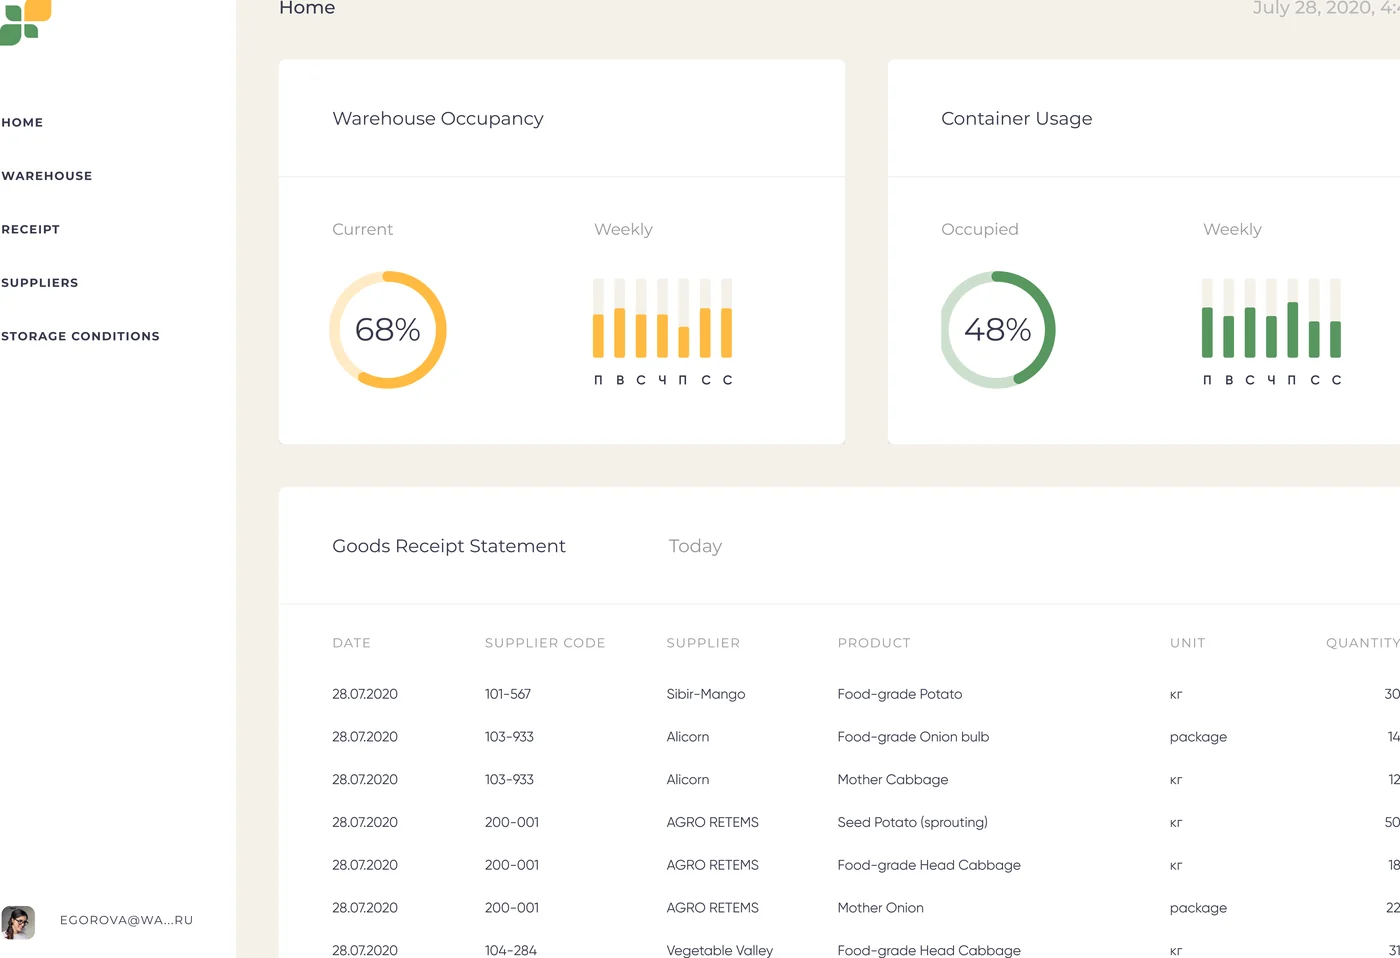
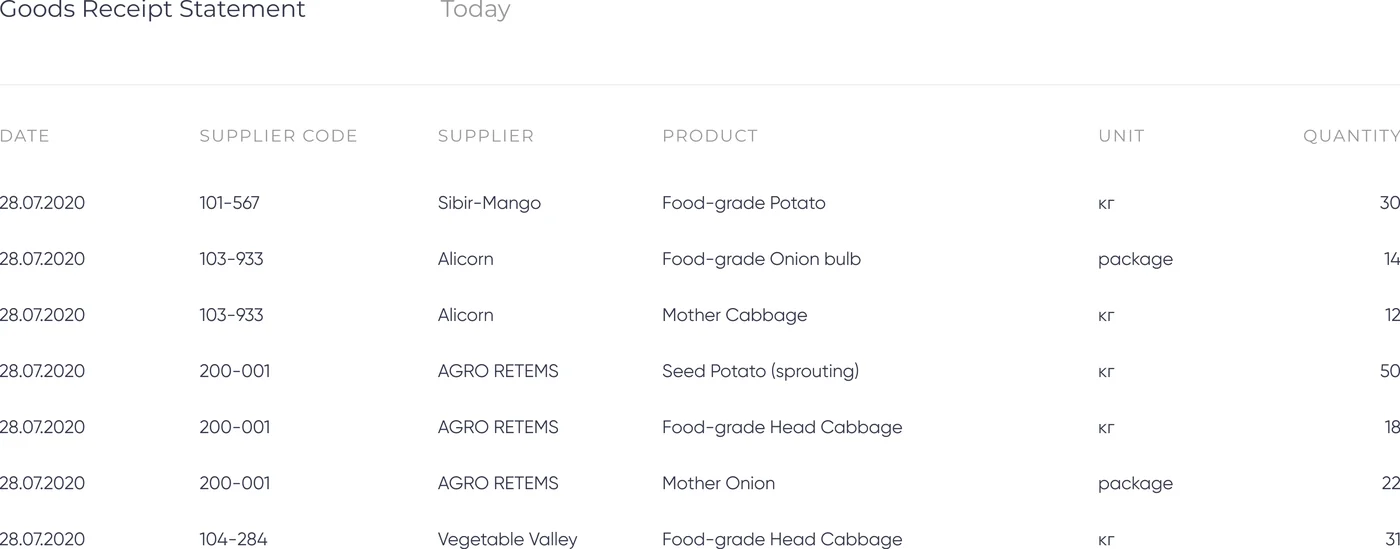
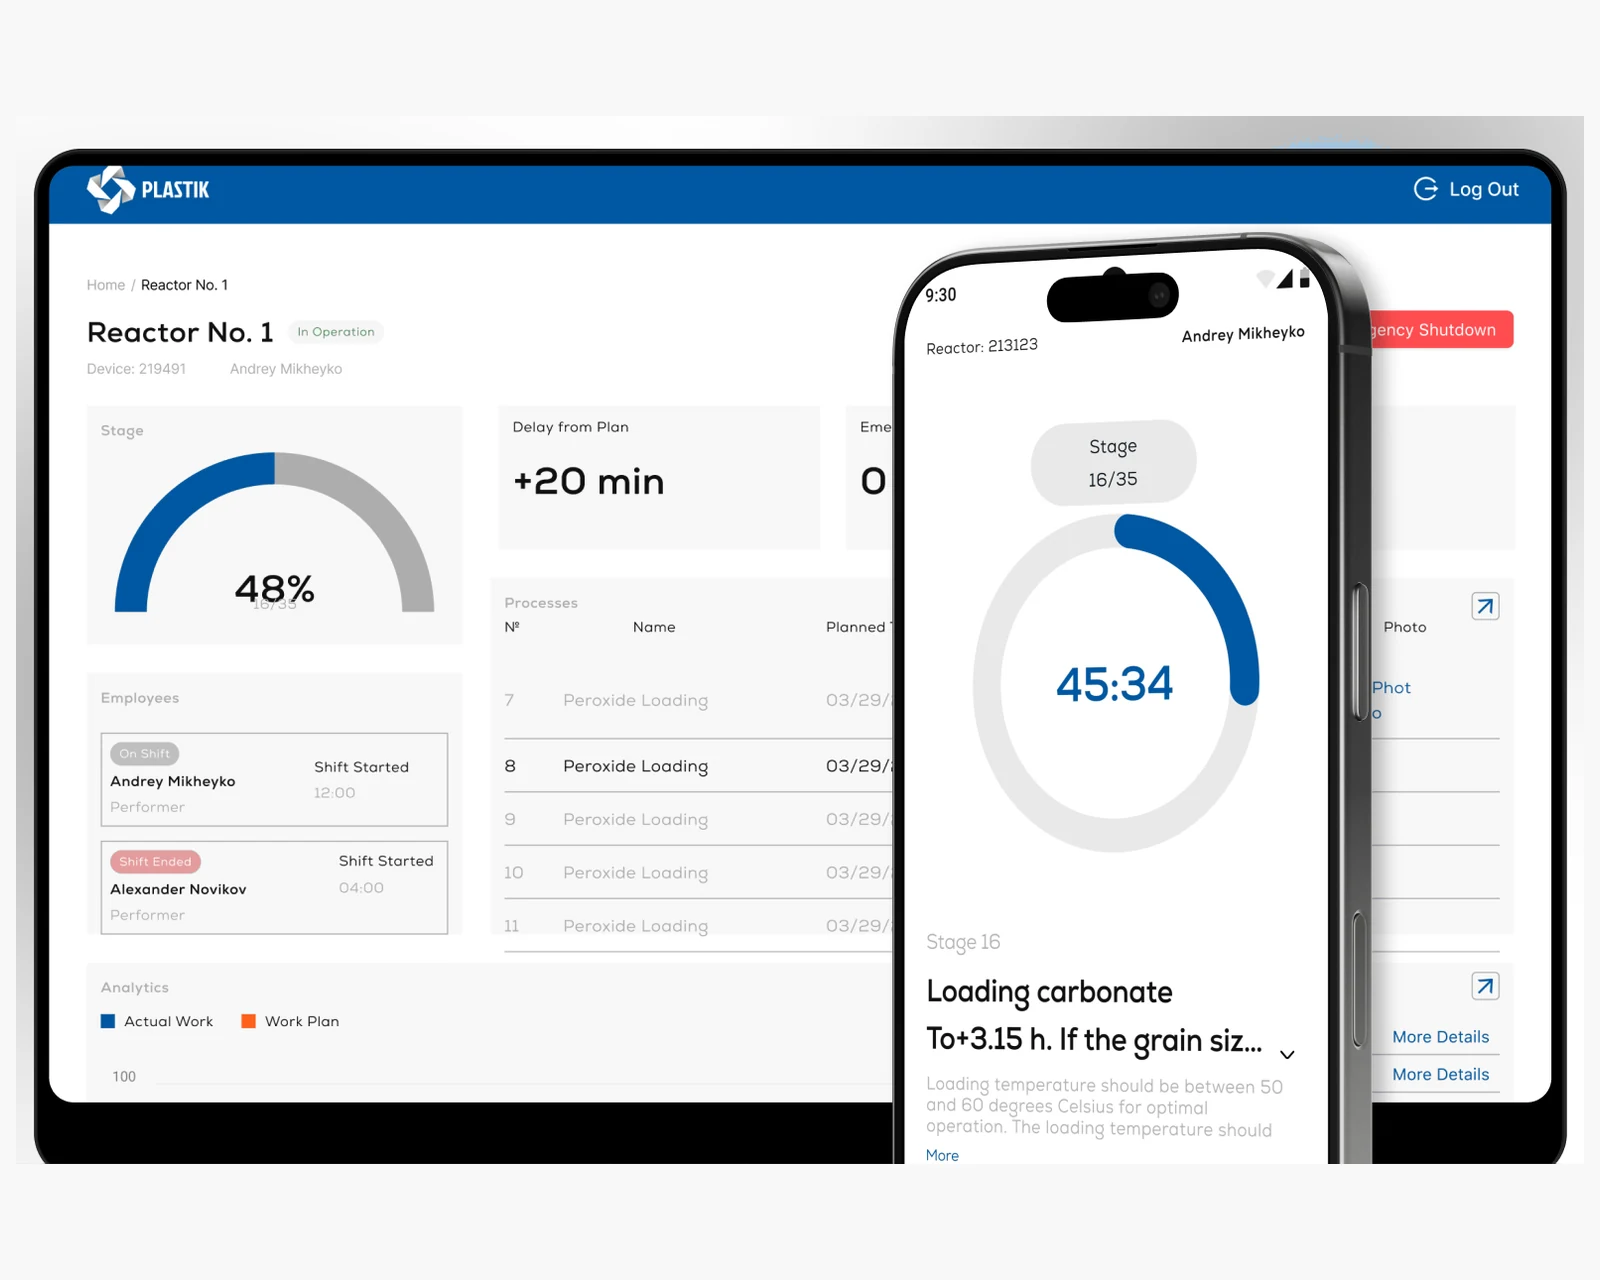
La capa de sincronización offline-first es la columna vertebral que hace fiables los datos de campo. Cada escaneo, lectura de peso y baja se escribe primero en un almacén local y se pone en cola para sincronizar; cuando vuelve la red, la cola se reproduce contra la API de Laravel con ID de operación idempotentes, de modo que un doble envío nunca cuente dos veces las existencias. Los conflictos se resuelven con «gana la última escritura» en los campos independientes y con avisos explícitos al operario en las colisiones reales, manteniendo coherente a la larga el libro mayor del dispositivo y el del servidor. Los registros de condiciones de almacenamiento —temperatura mínima y máxima del aire, humedad y duración del almacenamiento por contenedor— viajan por el mismo flujo, de modo que un responsable que supervisa en remoto ve las mismas cifras que el operario en la planta.
Como el cliente es dueño de su propio despliegue, la propiedad y la residencia de los datos son decisiones de diseño y no valores por defecto del proveedor. Los datos operativos pueden fijarse a infraestructura de EE. UU. o de la UE para futuros compromisos de residencia de datos, el acceso basado en roles mantiene separadas las vistas de operario, responsable y administrador, y el sistema se alinea con las obligaciones del RGPD para usuarios de la Unión Europea y las de la CCPA / CPRA para usuarios de California y del resto de Estados Unidos, de modo que una futura revisión de preparación sea un ejercicio documental y no una reforma de arquitectura.
Enfoque de cumplimiento: alineado con el RGPD · preparado para ISO 27001 · SOC 2 Type II en curso · apto para HIPAA · CCPA contemplada.