Acumulación de lag en los consumidores
Los consumidores lentos acumulan un lag sin límite y sin avisar. Integramos el lag exporter de Prometheus, configuramos alertas de lag e implementamos el autoescalado de consumidores con KEDA.

KRaft Schema Registry MSK Preparado para SOC 2
Kafka sustenta nuestros pipelines de eventos de mayor rendimiento: el procesamiento de la telemetría de viajes de Patinetes compartidos, con miles de eventos IoT por segundo; el bus de eventos logísticos de xRouten; el event sourcing de auditoría de Loan Conveyor. MSK en AWS, Confluent Cloud y clústeres KRaft autoalojados: todos en producción con nosotros.
Entregamos ingeniería con Kafka para el event sourcing en fintech, la ingesta de IoT y telemática, los buses de eventos de microservicios y los pipelines de change data capture que conectan bases de datos con consumidores posteriores. Schema Registry protege los contratos entre productores y consumidores en cada despliegue. Kafka Connect y Debezium mueven datos entre Kafka y las bases de datos sin pipelines a medida. KRaft elimina ZooKeeper en los clústeres nuevos.
Retos
Los consumidores lentos acumulan un lag sin límite y sin avisar. Integramos el lag exporter de Prometheus, configuramos alertas de lag e implementamos el autoescalado de consumidores con KEDA.
Los cambios de esquema en el productor rompen a los consumidores en versiones antiguas. Aplicamos en el CI las comprobaciones de compatibilidad BACKWARD de Schema Registry.
Con muy pocas particiones se limita el paralelismo de los consumidores y se crean puntos calientes. Dimensionamos las particiones según la concurrencia máxima deseada de consumidores ya en la fase de diseño.
Los reinicios frecuentes de consumidores desencadenan rebalanceos que paralizan el procesamiento durante segundos. Ajustamos session.timeout.ms, usamos el rebalanceo cooperativo sticky y minimizamos los reinicios innecesarios de consumidores.
At-least-once con gestión de duplicados suele ser más seguro que el exactly-once transaccional. Diseñamos consumidores idempotentes con tablas de deduplicación antes de recurrir a las transacciones de Kafka.
La dependencia de ZooKeeper añade un quórum aparte que operar. Migramos al modo KRaft en los clústeres nuevos y planificamos la retirada de ZooKeeper en los existentes.
Soluciones
Eventos de dominio publicados por los productores y consumidos por varios servicios posteriores, con DLQ, reintentos y contratos de esquema de eventos.
Debezium Kafka Connect captura los eventos del WAL de PostgreSQL o MySQL como topics de Kafka, para la invalidación de cachés, la sincronización de índices de búsqueda y la auditoría.
Flujos de sensores de alta frecuencia particionados por ID de dispositivo, consumidos por procesadores de streams y volcados en bases de datos de series temporales.
Logs de eventos inmutables para las transacciones financieras: topics compactados, productores exactly-once y grupos de consumidores de auditoría.
Pipelines de Kafka → S3/BigQuery/Snowflake mediante Kafka Connect S3 Sink o jobs de Flink a medida para analítica en tiempo real.
Kafka gestionado con Schema Registry, monitorización, alertas y autenticación IAM/SASL integrados desde el primer día.
Stack
Apache Kafka 3.8, KRaft, Schema Registry, Kafka Connect, Debezium, ksqlDB, AWS MSK, Confluent Cloud, kafka-go, node-kafka (kafkajs), KEDA, exporter de Kafka para Prometheus.
Cumplimiento
Alineado con el RGPD · apto para SOC 2 · apto para HIPAA · PCI DSS contemplado
Comunes: TLS + SASL/SCRAM, aplicación de la compatibilidad BACKWARD de Schema Registry, SBOM para las bibliotecas cliente.
Casos
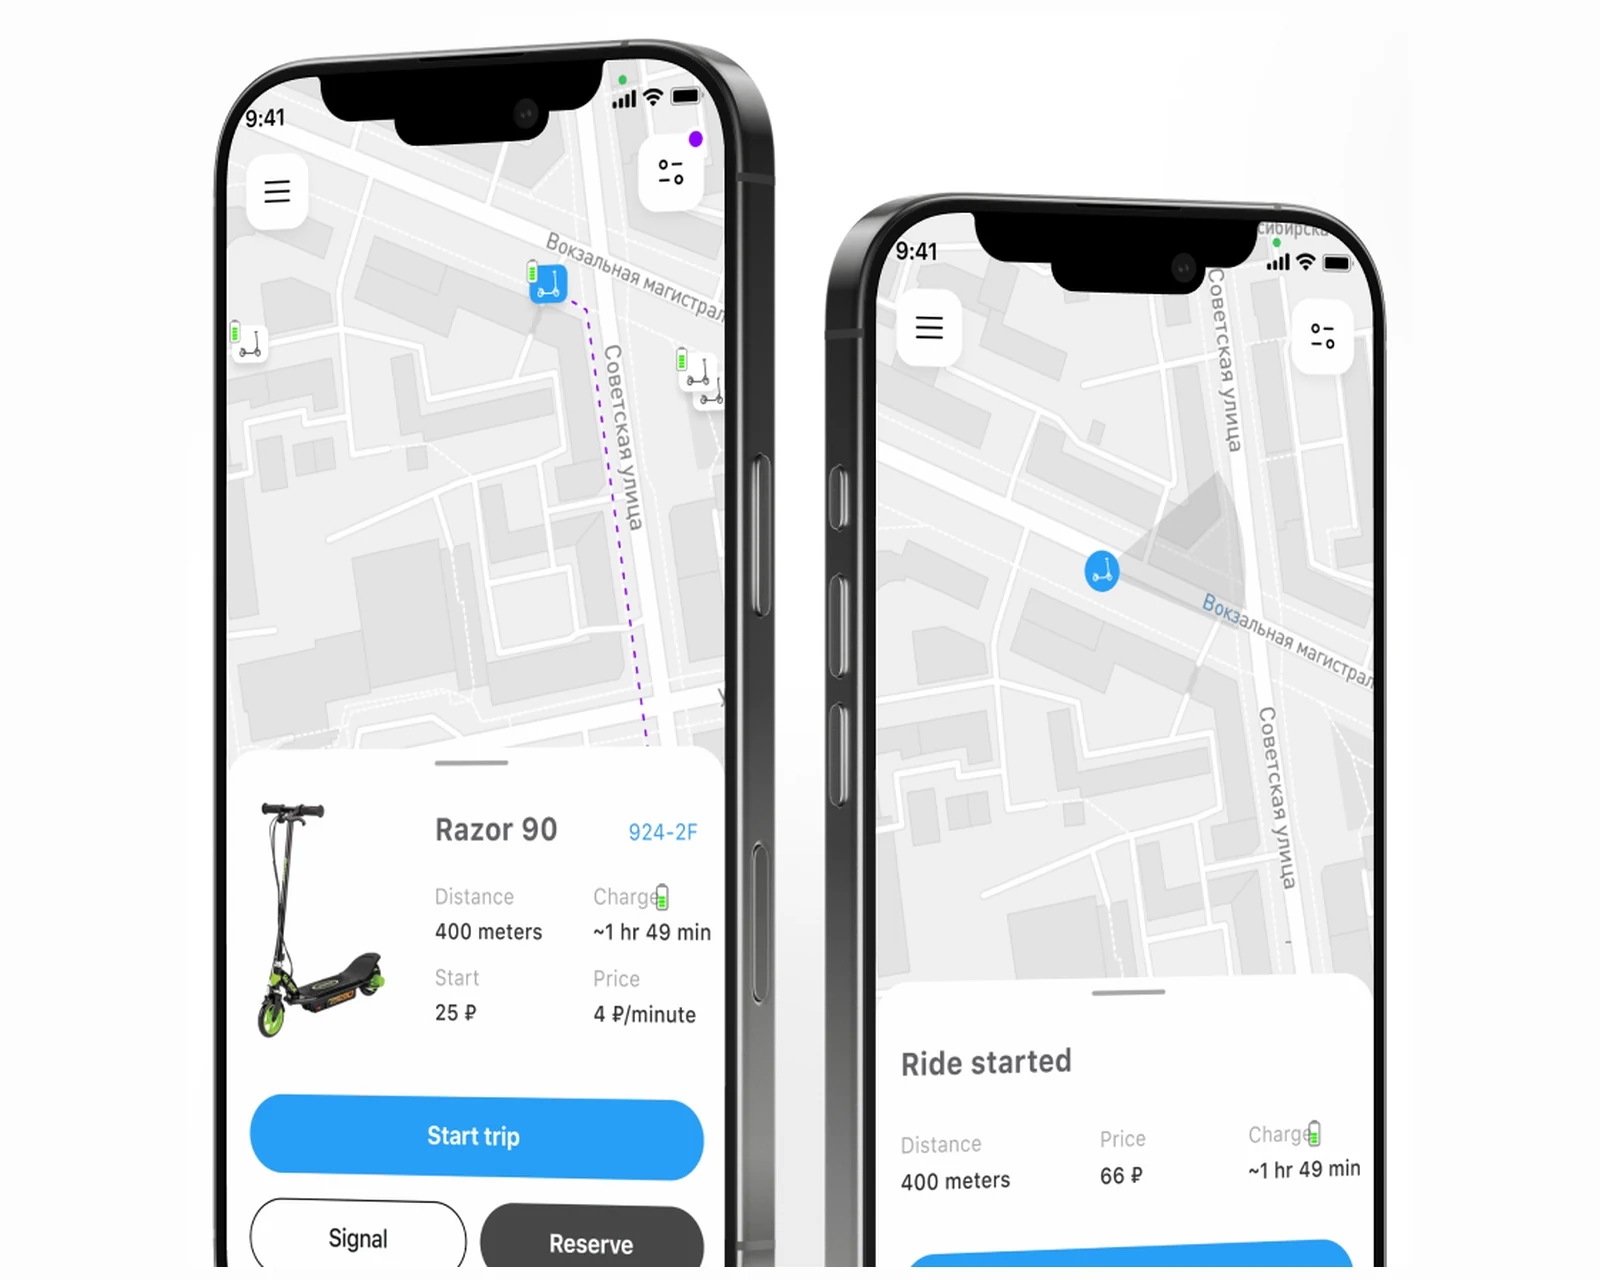
App de patinetes eléctricos compartidos con mapa en directo, desbloqueo por QR y monedero de viajes para iOS y Android: más de 5,000 usuarios, pensada para despliegues en EE. UU. y la UE.
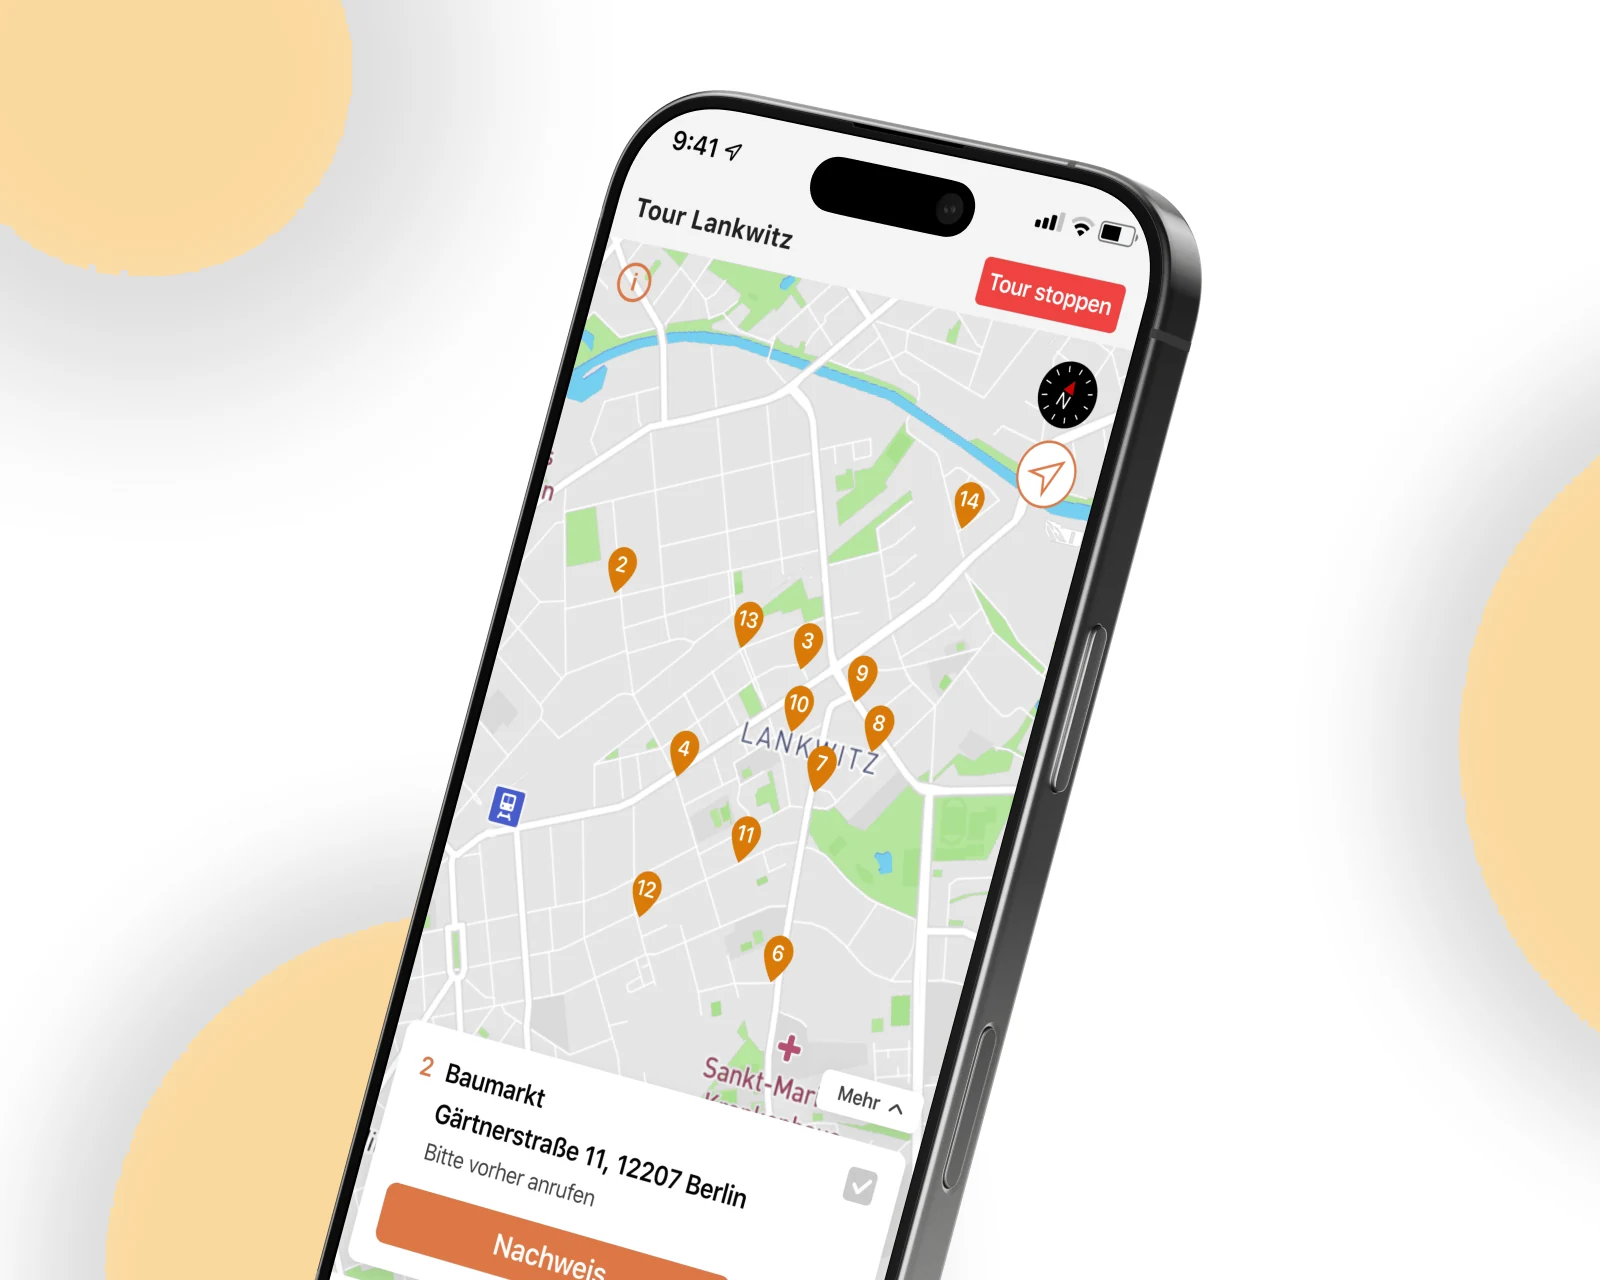
Refactorización y reconstrucción en Android e iOS para un operador alemán de logística de última milla: planificación de rutas multipunto, seguimiento de conductores en tiempo real y facturación en la app, en producción en la UE.
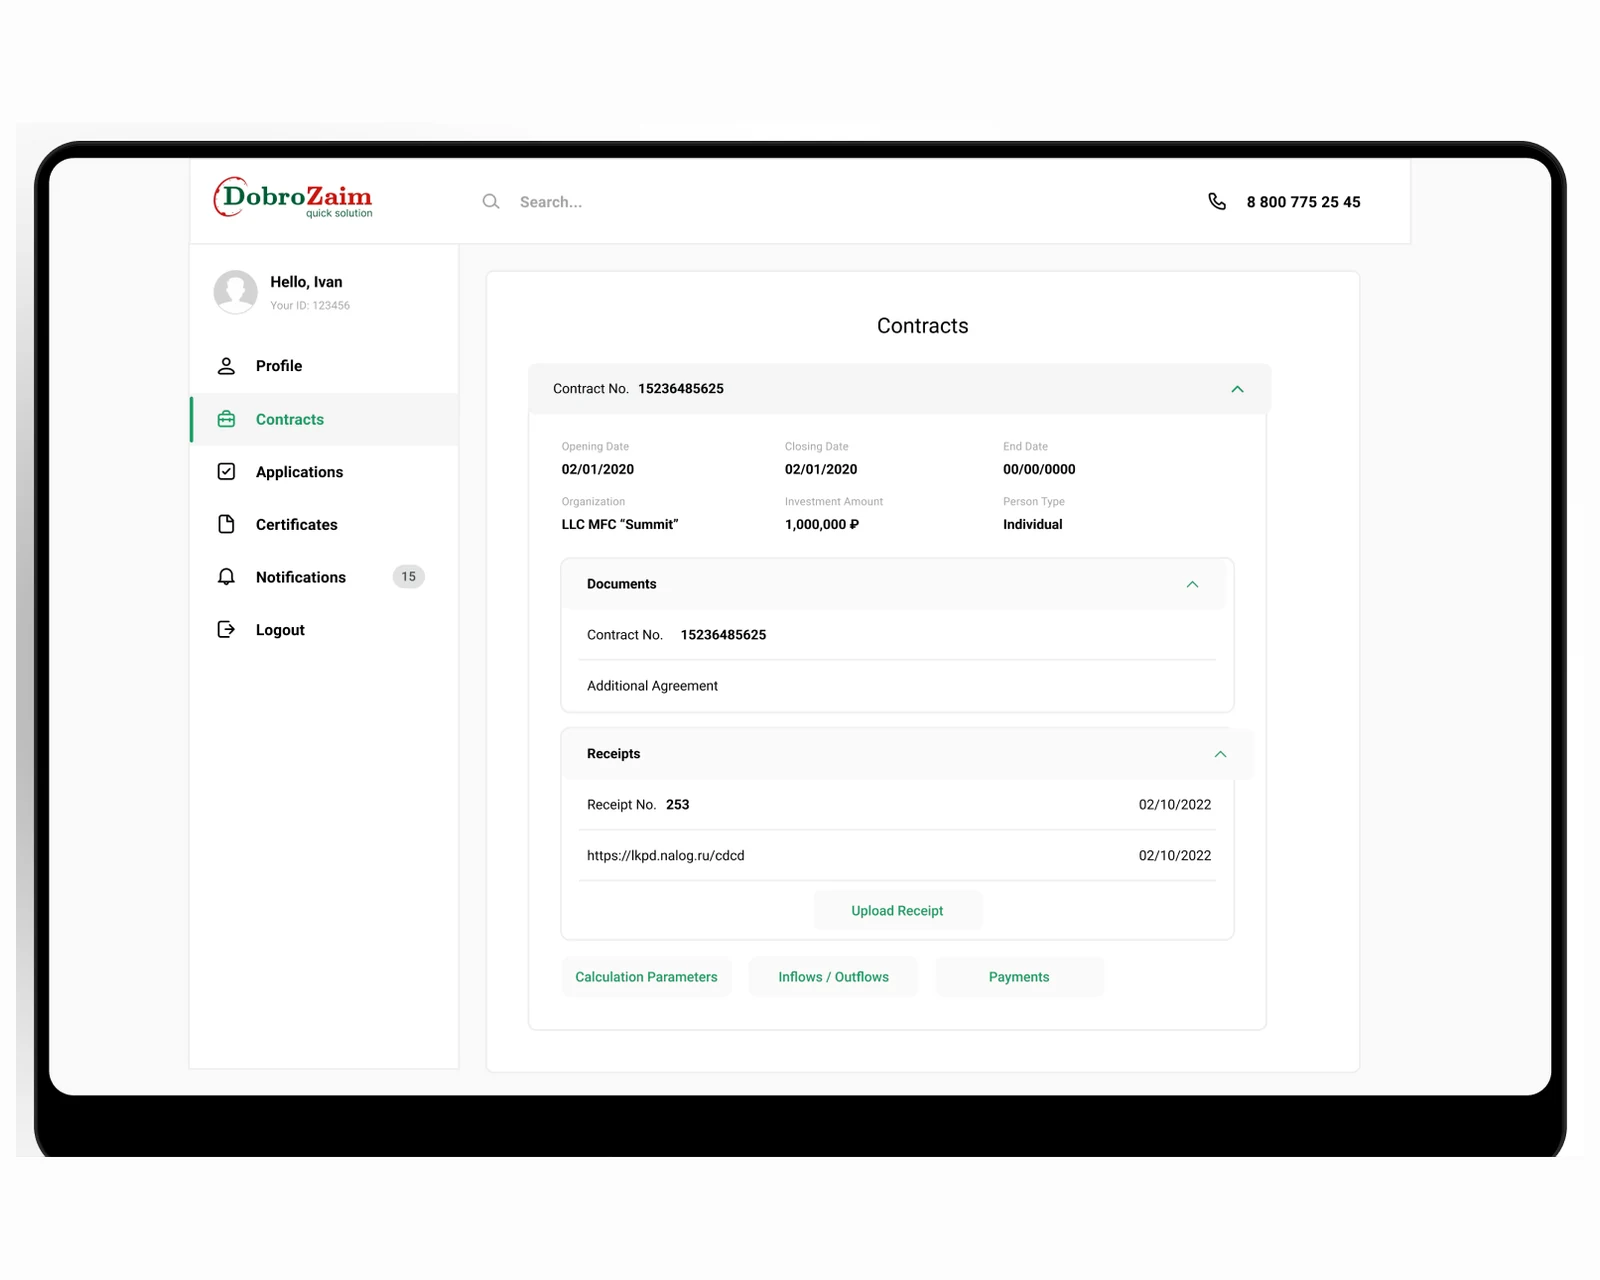
Motor de decisión de préstamos de alto rendimiento en Laravel: scoring automatizado, integración con burós de crédito y decisiones 10 veces más rápidas para prestamistas de EE. UU. y la UE.
Por qué YuSMP
Operamos clústeres de Kafka con KRaft, sin ZooKeeper: el nuevo estándar para los despliegues nuevos.
Cada cambio de esquema del productor pasa una comprobación de compatibilidad de Schema Registry en el CI antes del despliegue: los consumidores nunca se llevan una sorpresa.
Los pods consumidores escalan a cero entre ráfagas y vuelven al máximo en cuestión de segundos cuando crece la profundidad de la cola: escaladores KEDA nativos de Kafka integrados en nuestra configuración estándar de EKS.
Preguntas frecuentes
Kafka para pipelines multiconsumidor de alto rendimiento, replicación entre regiones, retención de mensajes a largo plazo y orden estricto dentro de las particiones. Redis Streams para un event sourcing ligero dentro de un único centro de datos, donde la carga operativa de Kafka no se justifica. Los topics compactados y el schema registry de Kafka lo convierten en la opción adecuada cuando los consumidores posteriores necesitan garantías de evolución de esquemas.
MSK (Amazon Managed Streaming for Kafka) para los equipos que ya están en AWS y quieren evitar la carga operativa de Kafka; en las versiones recientes KRaft sustituye a ZooKeeper. Confluent Cloud para los equipos que quieren schema registry, ksqlDB y monitorización sin gestionar ninguna infraestructura de Kafka. Autoalojado para entornos aislados (air-gapped) u on-premise. Operamos las tres opciones.
La monitorización del lag con Kafka Consumer Lag Exporter en Prometheus no es negociable. Configuramos alertas con un lag de 10k mensajes en los topics críticos, implementamos consumidores con autoescalado mediante KEDA en Kubernetes y diseñamos el número de particiones para que coincida con el paralelismo máximo de los consumidores.
Confluent Schema Registry con la compatibilidad BACKWARD como política por defecto: las nuevas versiones de esquema deben poder leerlas los consumidores de la versión anterior. Aplicamos las comprobaciones de compatibilidad de esquemas en el CI antes de desplegar los productores. Compatibilidad FORWARD para los casos en que los consumidores se actualizan primero.
Transacciones de Kafka (productor idempotente + consumidor transaccional) para el exactly-once dentro de Kafka. Para el exactly-once entre sistemas (Kafka → base de datos) usamos el patrón outbox: se escribe en una tabla outbox de la base de datos dentro de la misma transacción que la operación de negocio, y un conector Kafka Connect Debezium lee los eventos CDC de esa tabla.
TLS en todas las conexiones con los brokers, SASL/SCRAM o mTLS para la autenticación, ACL para el acceso a los topics por grupo de consumidores y autenticación IAM de MSK en los despliegues gestionados por AWS. Acceso a schema registry controlado por subject de esquema. Auditamos las ACL de Kafka cada trimestre.
Respuesta en 1 día hábil. NDA a petición.
Cuéntenos algunos detalles y un consultor sénior le responderá en un día hábil.