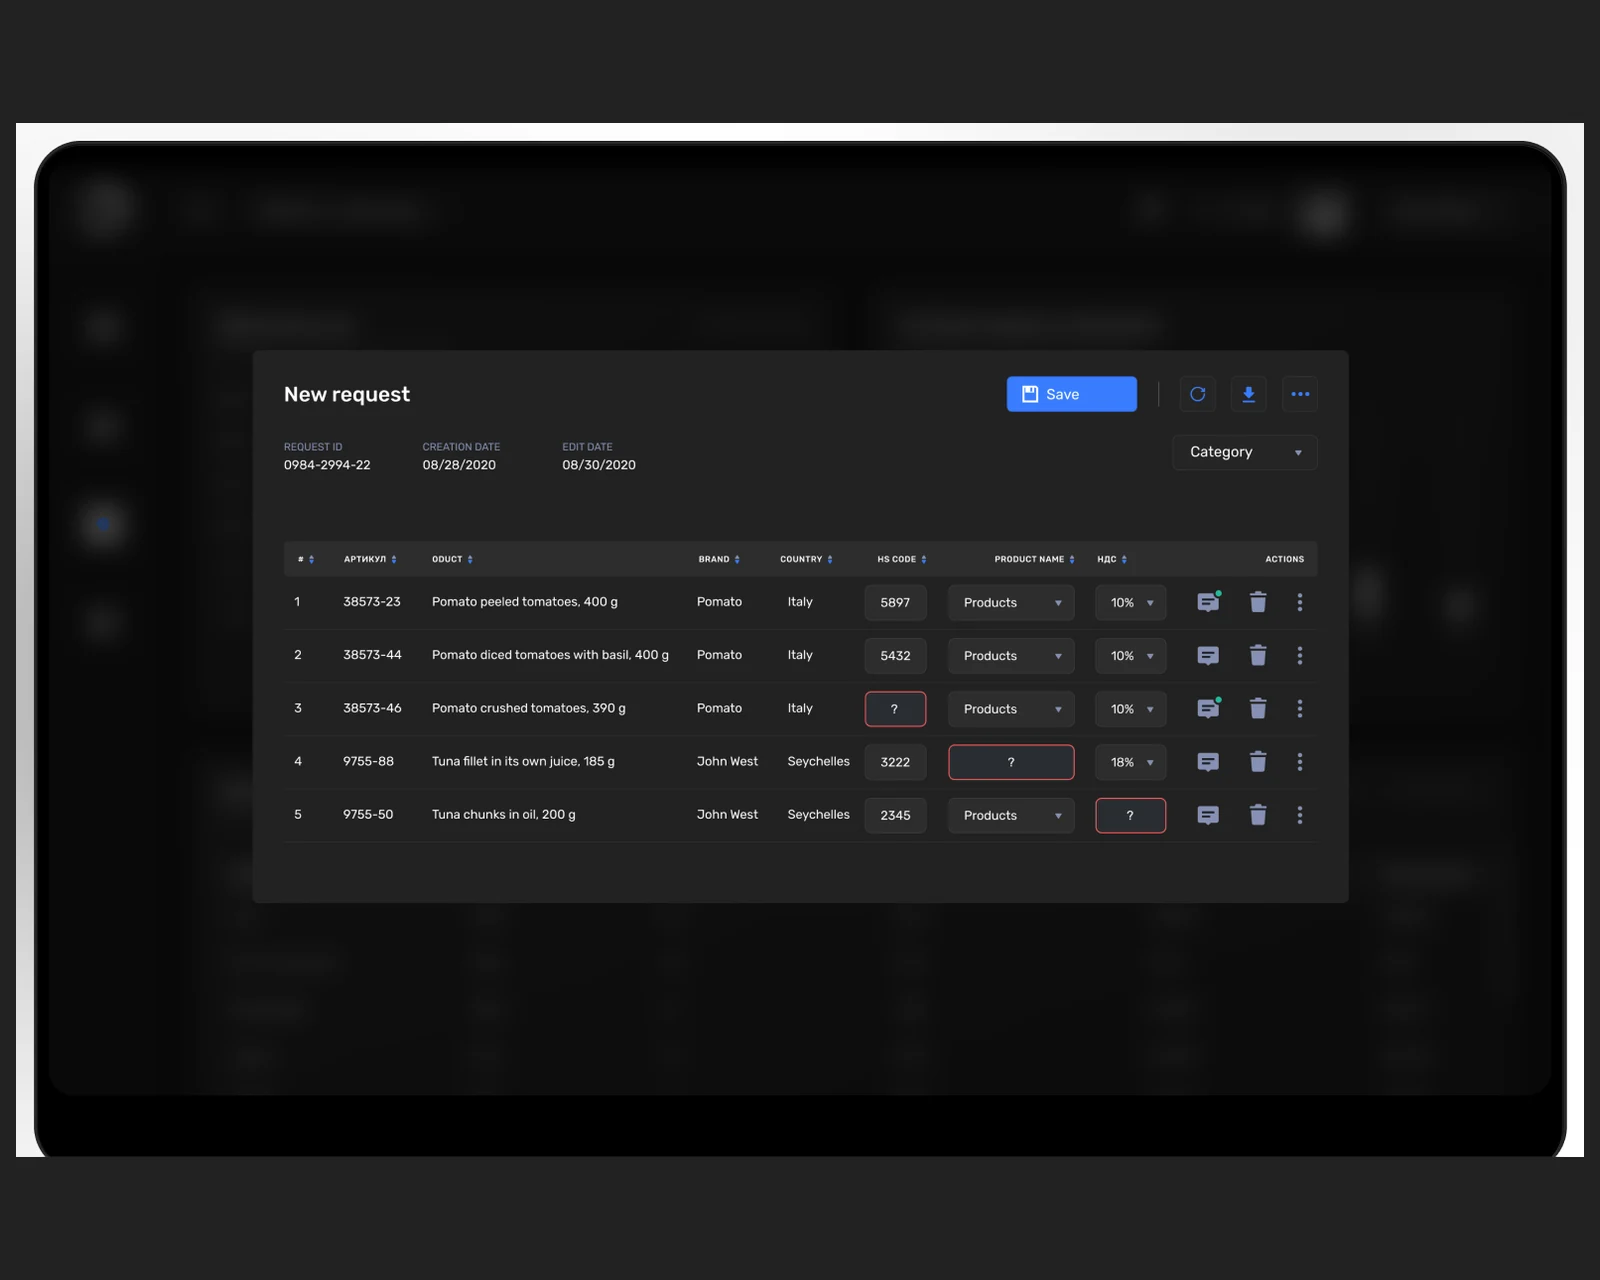
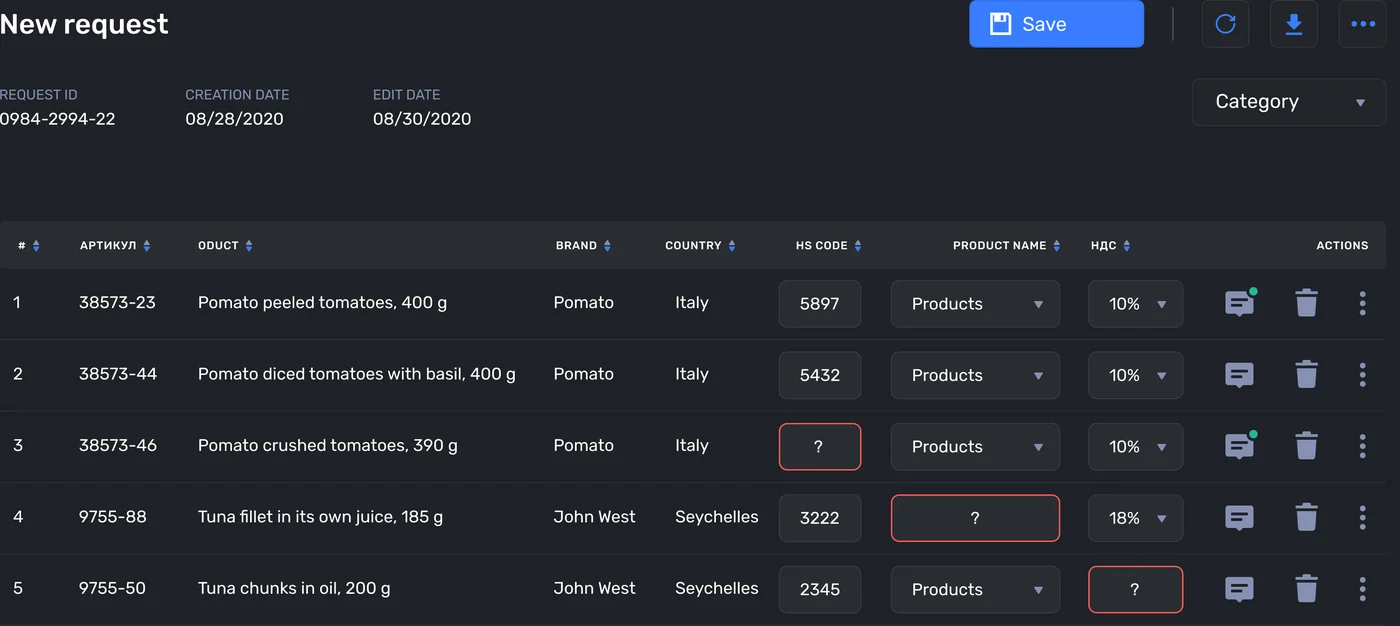
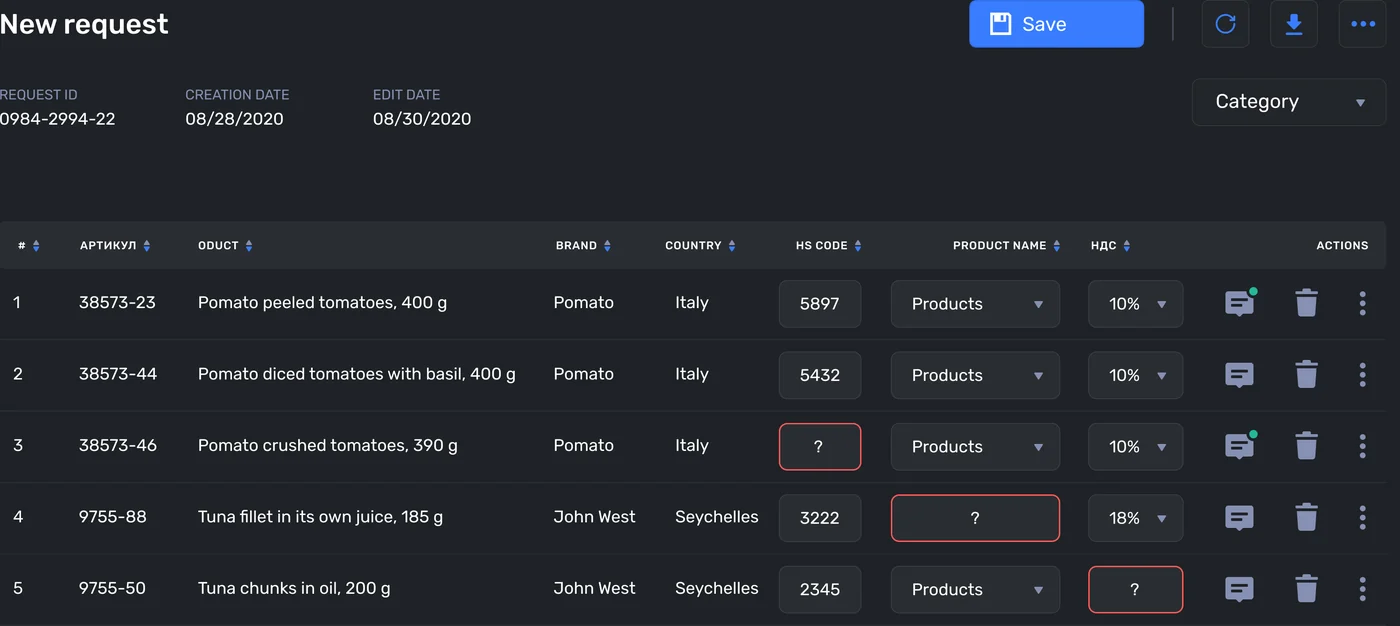
El enfoque de autoaprendizaje de EasyTrain fue una decisión de arquitectura antes de ser un reclamo de marketing. La base de conocimiento es un almacén estructurado de tuplas históricas de especificación — código HS, marca, país de origen, nombre del producto, clase de IVA, categoría resuelta — indexadas por la solicitud que introdujo cada tupla. Cada solicitud cerrada añade nuevas tuplas al almacén, y cada nueva solicitud entrante se ejecuta contra el almacén mediante una búsqueda determinista que el equipo de operadores puede razonar, auditar y modificar. No hay una caja negra opaca de ML ni riesgo de deriva del modelo: el sistema es, con honestidad, un índice predictivo determinista sobre el trabajo histórico de la propia empresa.
La identidad del operador está separada deliberadamente de la base de conocimiento. El modelo de permisos de administración de cuatro roles mantiene el derecho a modificar tuplas históricas aislado en el rol de administrador, y las políticas de infraestructura como código hacen cumplir los invariantes de auditoría: cualquier pull request que introduzca una elusión de la comprobación de rol, una escritura de tupla sin registrar o un identificador de larga duración en el plano de predicción falla en CI. El enfoque está pensado para alinearse con las obligaciones del RGPD para los usuarios de la Unión Europea y con las obligaciones de la CCPA / CPRA para los usuarios de California y del resto de Estados Unidos, y para que una futura revisión independiente de preparación sea un ejercicio de documentación y no una reforma de la arquitectura.
Enfoque de cumplimiento: alineado con el RGPD · preparado para ISO 27001 · SOC 2 Type II en curso · apto para HIPAA · CCPA contemplada.