
Una empresa de desarrollo de software biotecnológico diseña, construye y mantiene el software con el que trabajan las empresas biotecnológicas orientadas a la investigación: sistemas que rastrean muestras, registran experimentos, procesan datos de secuenciación, controlan robots de laboratorio y convierten terabytes de datos biológicos en decisiones. En 2026 este trabajo se sitúa en la intersección de tres disciplinas — ingeniería de software, ingeniería de datos y ciencia de laboratorio —, y los mejores socios dominan las tres.
Los equipos biotecnológicos suelen buscar un desarrollador externo cuando las plataformas estándar dejan de adaptarse a su ciencia: un nuevo ensayo que el LIMS no puede modelar, un pipeline de secuenciación que ya no escala o un modelo de IA que necesita datos de entrenamiento limpios y conectados. Como el software biotecnológico suele tratar muestras de pacientes, fabricación regulada o afirmaciones diagnósticas, también debe alcanzar el mismo nivel de integridad de datos que los sistemas clínicos. Por eso lo tratamos como parte de nuestros servicios de desarrollo de software para HealthTech y ciencias de la vida y no como un desarrollo web genérico.
Esta guía explica qué abarca el desarrollo de software biotecnológico, en qué se diferencia del software farmacéutico, los principales tipos de software biotecnológico que se desarrollan hoy, las funcionalidades y normas de cumplimiento que importan, el stack tecnológico, un proceso de desarrollo paso a paso, costes realistas en 2026 y cómo elegir una empresa de desarrollo de software biotecnológico. Si su trabajo está más cerca de la fabricación de medicamentos y los ensayos clínicos, empiece por nuestra guía de desarrollo de software farmacéutico.
¿Qué hace una empresa de desarrollo de software biotecnológico?
Una empresa de desarrollo de software biotecnológico crea software a medida que da soporte a la investigación, el desarrollo y la producción biológicos: captura de datos de laboratorio, gestión de muestras e inventario, procesamiento de datos científicos, integración de instrumentos, analítica e IA. A diferencia de un proveedor de producto que vende una única plataforma, diseña sistemas en torno a la ciencia, los datos y los flujos de trabajo de una organización concreta.
En la práctica, los «servicios de desarrollo de software biotecnológico» abarcan encargos muy distintos, desde la reconstrucción de un pipeline de bioinformática en tres meses hasta una plataforma de datos de investigación de varios años. Quien busca una empresa de desarrollo de software para biotecnología suele encontrarse con cuatro tipos de proveedor:
| Tipo de proveedor | Qué entrega | Ideal para | Limitación |
|---|---|---|---|
| Proveedores de plataformas (productos LIMS/ELN) | Software con licencia configurado para su laboratorio | Flujos estándar, arranque rápido, soporte del proveedor | Modelos de datos rígidos, coste por usuario, hoja de ruta que usted no controla |
| Empresas de desarrollo de software biotecnológico a medida | Aplicaciones, integraciones y plataformas de datos a medida | Ciencia única, flujos propios, entornos con muchas integraciones | Requiere una responsabilidad de producto clara por su parte |
| Consultoras de bioinformática | Pipelines de análisis, estadística, interpretación científica | Análisis puntuales, desarrollo de métodos | A menudo más débiles en ingeniería de producción y soporte a largo plazo |
| Integradores de sistemas y empresas de validación | Despliegue de plataformas, validación CSV/CSA, operaciones de TI | Implantaciones reguladas (GxP) de productos existentes | Poco desarrollo de producto a medida |
La mayoría de las organizaciones biotecnológicas maduras los combinan: un ELN o LIMS comercial para el trabajo estándar, un socio de desarrollo a medida para la plataforma de datos y las integraciones que la rodean, y especialistas en validación para las partes reguladas.
¿En qué se diferencia el software biotecnológico del software farmacéutico?
El software biotecnológico se crea sobre todo para el descubrimiento y la investigación — experimentos, datos biológicos y métodos que cambian rápido —, mientras que el software farmacéutico se crea sobre todo para las etapas reguladas posteriores del ciclo de vida del medicamento: ensayos clínicos, fabricación GMP, calidad y farmacovigilancia. Ambos se solapan, pero sus prioridades son distintas.
| Criterio | Biotecnológico (orientado a la investigación) | Farmacéutico (orientado al ciclo de vida) |
|---|---|---|
| Usuarios principales | Científicos de laboratorio, bioinformáticos, científicos de datos, ingenieros de automatización | Operaciones clínicas, QA/QC, fabricación, asuntos regulatorios |
| Sistemas típicos | ELN, LIMS de investigación, pipelines NGS, plataformas multiómicas, modelos de IA | EDC, CTMS, QMS, MES, farmacovigilancia |
| Datos | Muy voluminosos y heterogéneos: secuencias, imágenes, lecturas de placas, espectros | Registros clínicos, de lote y de calidad estructurados |
| Ritmo de cambio | Alto — los ensayos y métodos cambian cada mes | Bajo — los cambios pasan por un control formal de cambios |
| Regulación | Integridad de datos y principios FAIR; GLP/GMP en cuanto el trabajo entra en estudios regulados o en producción | GxP, 21 CFR Part 11 y validación de sistemas informatizados desde el primer día |
| Principal reto de ingeniería | Escalar la capacidad de cómputo y modelar una ciencia en evolución | Validación, registros de auditoría y versiones controladas |
La consecuencia práctica: una empresa de desarrollo de software biotecnológico debe sentirse cómoda entregando rápido en investigación sin perder un camino limpio hacia la validación, porque una herramienta de descubrimiento puede convertirse en un sistema regulado en el momento en que sus datos respaldan una solicitud IND, una afirmación diagnóstica o la liberación de un lote.
¿Qué organizaciones necesitan software biotecnológico a medida?
El software biotecnológico a medida compensa a las organizaciones cuya ciencia, volumen de datos o alianzas superan las herramientas estándar: startups biotecnológicas financiadas con capital riesgo, biotecnológicas de plataforma, CRO y CDMO, servicios centrales académicos, laboratorios de diagnóstico y empresas de biotecnología industrial o agrícola. Cada grupo necesita un primer sistema distinto.
- Startups biotecnológicas en fase inicial. Suelen empezar con un ELN comercial y añadir un registro ligero, un data lake y uno o dos pipelines automatizados en cuanto crecen los volúmenes de secuenciación o de cribado.
- Biotecnológicas de plataforma. Las empresas cuya plataforma es el producto — descubrimiento de anticuerpos, terapia celular, biología sintética — invierten pronto en una plataforma de datos a medida, porque su modelo de datos es su ventaja competitiva.
- CRO y CDMO. Necesitan separar los datos de cada cliente, portales para promotores, seguimiento de estudios y sistemas validados que superen las auditorías de cada cliente.
- Servicios centrales académicos e institucionales. Necesitan recepción de muestras, facturación, reserva de instrumentos y entrega de resultados para cientos de usuarios internos.
- Laboratorios de diagnóstico y de genómica clínica. Necesitan petición de pruebas, registro de muestras, flujos de interpretación e integración con la historia clínica electrónica conforme a CLIA o al IVDR.
- Biotecnología industrial, alimentaria y agrícola. Necesita bibliotecas de cepas, datos de fermentación y de bioprocesos y analítica de escalado más que funciones clínicas.
¿Qué tipos de software biotecnológico se desarrollan en 2026?
Los tipos más comunes de software biotecnológico a medida en 2026 son los sistemas de gestión de información de laboratorio, los cuadernos de laboratorio electrónicos, los pipelines de bioinformática y secuenciación, las plataformas de datos multiómicos, la automatización de laboratorio y la integración de instrumentos, las herramientas de IA para el descubrimiento, el software de bioprocesos y biofabricación y las aplicaciones de diagnóstico.
| Tipo de software | Qué hace | Integraciones típicas |
|---|---|---|
| LIMS | Registro de muestras, cadena de custodia, pruebas, resultados, inventario | Instrumentos, ELN, ERP, congeladores y sistemas de códigos de barras |
| Cuaderno de laboratorio electrónico (ELN) | Protocolos, observaciones, cálculos, contexto experimental | LIMS, registros, almacenes de archivos, herramientas de análisis |
| Pipelines de bioinformática y NGS | Alineamiento, llamada de variantes, análisis de expresión, control de calidad | Secuenciadores, cómputo HPC o en la nube, bases de datos de referencia |
| Plataforma de datos multiómicos | Almacenamiento unificado, metadatos, búsqueda y analítica de todos los tipos de datos | Pipelines, ELN/LIMS, notebooks, herramientas de BI y ML |
| Automatización y planificación de laboratorio | Orquestación de robots, mapas de placas, planificación de ejecuciones, control de dispositivos | Manipuladores de líquidos, lectores e incubadoras mediante SiLA 2 o API de los fabricantes |
| Herramientas de IA para el descubrimiento | Identificación de dianas, diseño de proteínas y anticuerpos, triaje de hits | Datos de ensayos, bases de datos de estructuras, cómputo en GPU |
| Bioprocesos y biofabricación | Registros de lote, analítica de procesos, datos de escalado, enlaces con el MES | Biorreactores, historiadores de datos, QMS, ERP |
| Diagnóstico y genómica clínica | Petición de pruebas, emisión de resultados, portales para pacientes | Historia clínica electrónica vía HL7/FHIR, aseguradoras, instrumentos de laboratorio |
LIMS y cuadernos de laboratorio electrónicos
El LIMS y el ELN son el sistema de referencia de la mayoría de los laboratorios biotecnológicos: el LIMS gestiona operaciones estructuradas como muestras, pruebas e inventario, mientras que el ELN recoge el contexto científico — protocolos, observaciones y razonamientos. El desarrollo a medida suele justificarse cuando las entidades de un laboratorio (constructos, líneas celulares, anticuerpos, cepas) o sus flujos no encajan en un modelo de datos comercial, o cuando ambos sistemas deben compartir un único registro en lugar de volver a teclear los datos a mano.
Pipelines de bioinformática y secuenciación
El desarrollo de software de bioinformática convierte la salida bruta de los instrumentos en resultados analizables: demultiplexado, alineamiento, llamada de variantes, análisis de célula única y espaciales, y control de calidad. El trabajo de ingeniería trata de reproducibilidad y escala — flujos versionados, herramientas en contenedores, reejecuciones automáticas y ejecución en la nube o en HPC con costes controlados — más que de escribir algoritmos nuevos.
Plataformas multiómicas y de datos de investigación
Una plataforma de datos de investigación conecta los datos de genómica, proteómica, imagen y ensayos con los metadatos de muestras y experimentos que les dan sentido. Es la base de cualquier ambición en IA: los modelos entrenados con datos desconectados y mal anotados no generalizan. Las buenas plataformas siguen los principios FAIR — datos localizables, accesibles, interoperables y reutilizables.
Automatización de laboratorio e integración de instrumentos
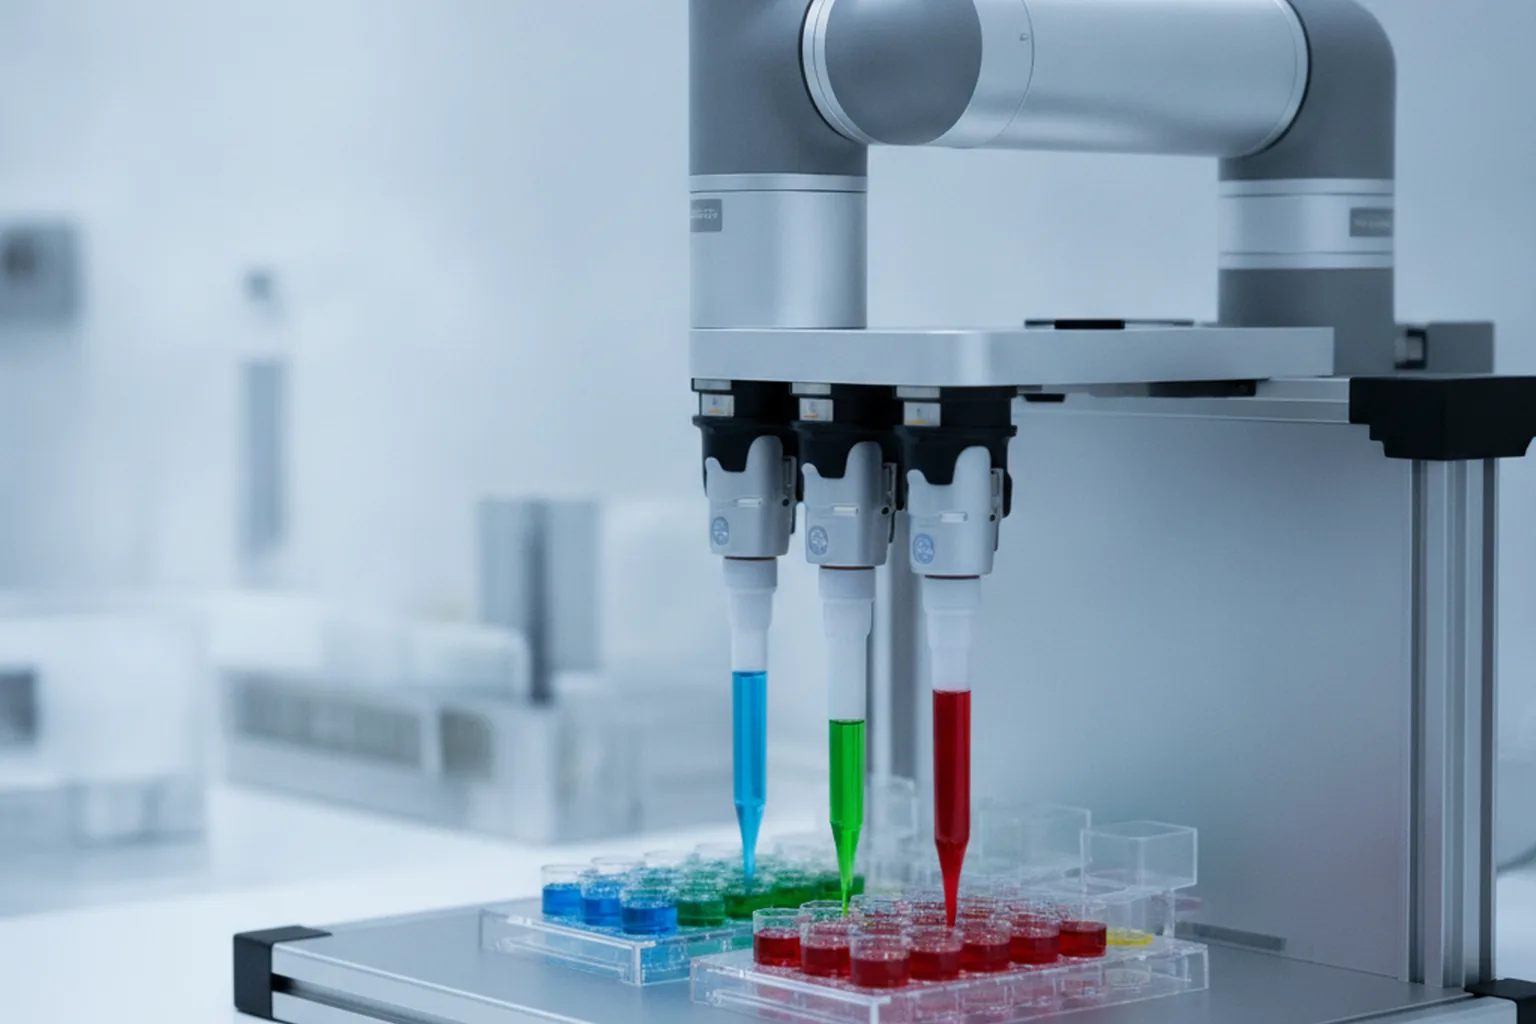
El software de automatización de laboratorio planifica y controla manipuladores de líquidos, lectores de placas, incubadoras y brazos robóticos, y lleva sus datos al LIMS o a la plataforma de datos sin exportaciones manuales. Estándares como SiLA 2 para la comunicación con dispositivos y el Allotrope Simple Model para los datos analíticos reducen el trabajo de controladores a medida, pero la mayoría de los laboratorios sigue usando una mezcla de instrumentos que necesita conectores propios.
Herramientas de IA para el descubrimiento
Las herramientas de IA para el descubrimiento aplican el aprendizaje automático a la identificación de dianas, el diseño de proteínas y anticuerpos, la predicción de propiedades moleculares y el triaje de hits. El reto de software está menos en el modelo y más en el ciclo que lo rodea: datos de entrenamiento depurados, seguimiento de experimentos, versionado de modelos y un camino rápido desde la predicción hasta el siguiente experimento de laboratorio — el patrón «lab-in-the-loop». Nuestra guía de desarrollo de software de machine learning trata con más detalle la parte de MLOps.
Bioprocesos, biofabricación y diagnóstico
A medida que los programas avanzan hacia la producción y los pacientes, el software pasa de herramientas de investigación a sistemas regulados: analítica de bioprocesos, registros de lote electrónicos, gestión de la calidad y emisión de resultados diagnósticos. Estos sistemas necesitan validación, registros de auditoría y versiones controladas desde el principio, y los productos de diagnóstico pueden estar regulados como productos sanitarios — consulte nuestra guía de desarrollo de software para productos sanitarios.
¿Qué funcionalidades necesita el software biotecnológico?
Toda aplicación biotecnológica seria necesita un modelo de datos científico compartido, trazabilidad completa, conexión con los instrumentos, cómputo escalable, control de acceso granular y registros preparados para auditoría. Estas funcionalidades deciden si el sistema puede crecer con la ciencia o tendrá que sustituirse en dos años.
- Un registro de entidades flexible. Muestras, constructos, líneas celulares, reactivos y lotes modelados como entidades vinculadas con su linaje, de modo que cualquier resultado pueda rastrearse hasta su origen biológico.
- Flujos de trabajo configurables. Ensayos y protocolos definidos como configuración y no como código, para que los científicos puedan añadir un método nuevo sin un ciclo de publicación.
- Ingesta de instrumentos y archivos. Captura automática de la salida de los instrumentos, conversión en datos estructurados y almacenamiento de los archivos brutos con sumas de verificación.
- Pipelines reproducibles. Flujos versionados, herramientas en contenedores y parámetros registrados, para que un análisis pueda repetirse años después con el mismo resultado.
- Registros de auditoría y firmas electrónicas. Registros con marca de tiempo y atribuibles de quién cambió qué y por qué, con firmas electrónicas cuando se aplica 21 CFR Part 11.
- Acceso por roles y segregación de datos. Permisos granulares para equipos internos, socios y CRO, además de desidentificación de los datos procedentes de pacientes.
- API y acceso analítico. API documentadas y acceso directo desde notebooks o BI, para que los científicos de datos trabajen con datos gobernados en lugar de con copias privadas.
¿Comprar una plataforma o contratar una empresa de desarrollo de software biotecnológico?
Compre una plataforma comercial cuando sus flujos sean estándar y la velocidad sea lo más importante; contrate una empresa de desarrollo de software biotecnológico cuando su ciencia, su modelo de datos o sus integraciones sean una ventaja competitiva que un producto configurable no puede expresar. Muchas organizaciones hacen ambas cosas: compran el núcleo y desarrollan a su alrededor la capa diferenciadora.
| Factor | Comprar (LIMS/ELN comercial o plataforma de I+D) | Desarrollar (a medida) |
|---|---|---|
| Tiempo hasta el primer valor | De semanas a unos pocos meses | De tres a nueve meses para una primera versión |
| Ajuste a su ciencia | Limitado por el modelo de datos del proveedor | Diseñado en torno a sus entidades y flujos |
| Perfil de costes | Licencias recurrentes que crecen con los usuarios y los datos | Mayor inversión inicial, menor coste marginal |
| Profundidad de integración | Depende de las API del proveedor | Control total de las integraciones y los flujos de datos |
| Validación | La documentación del proveedor ayuda | El paquete de validación es suyo |
| Propiedad de la PI y de los datos | Datos en el sistema y el formato del proveedor | El código, el modelo de datos y los datos son suyos |
Una regla práctica útil: si más de un tercio de los requisitos necesitan soluciones provisionales o personalización del proveedor, una arquitectura híbrida — núcleo comercial más plataforma de datos e integraciones a medida — suele salir más barata a cinco años. Nuestro artículo sobre software a medida frente a software estándar recorre el cálculo completo.
¿Qué normas de cumplimiento se aplican al software biotecnológico en 2026?
El software biotecnológico debe cumplir desde el principio las expectativas de integridad de datos y, en cuanto sus datos respaldan decisiones reguladas, los requisitos regulatorios formales: 21 CFR Part 11 para registros y firmas electrónicas, GLP y GMP para estudios no clínicos y fabricación, HIPAA y RGPD para los datos procedentes de pacientes, y las normas de productos sanitarios o de diagnóstico cuando el software hace afirmaciones clínicas.
- 21 CFR Part 11 y Anexo 11 de las GMP de la UE. La Part 11 en sí no cambió en 2026, pero sí su entorno. Los registros de auditoría, el control de acceso, las firmas electrónicas y la conservación de registros siguen siendo el núcleo.
- Computer Software Assurance (CSA). La Quality Management System Regulation modificada de la FDA entró en vigor el 2 de febrero de 2026 e incorpora la ISO 13485:2016 por referencia, y el 3 de febrero de 2026 le siguió una guía final actualizada de CSA. Cubre de forma explícita los servicios en la nube y las herramientas de IA/ML usadas con fines de producción o de calidad, y prefiere las pruebas basadas en el riesgo a una validación exhaustiva con guiones.
- Integridad de datos (ALCOA+). Los registros deben ser atribuibles, legibles, contemporáneos, originales y exactos, además de completos, coherentes, duraderos y disponibles — un requisito de diseño, no un ejercicio de documentación.
- HIPAA, RGPD y privacidad genética. Los datos genómicos de pacientes o donantes son datos de salud. Cuente con desidentificación, gestión del consentimiento, acuerdos de tratamiento de datos y, para los datos de la UE, las normas del RGPD sobre categorías especiales de datos.
- IA en el desarrollo de medicamentos. El borrador de guía de la FDA de enero de 2025 propone un marco de credibilidad de siete pasos basado en el riesgo para los modelos de IA usados en decisiones regulatorias, y en otoño de 2026 seguía siendo un borrador. El 14 de enero de 2026 la FDA y la EMA publicaron diez principios rectores conjuntos de buenas prácticas de IA en el desarrollo de medicamentos.
- Diagnóstico. El software que produce resultados diagnósticos puede quedar sujeto a CLIA en EE. UU., al IVDR de la UE o a las normas de software de productos sanitarios como IEC 62304.
Para una lista de comprobación más completa sobre datos de pacientes, consulte nuestra lista de comprobación HIPAA para el desarrollo de software.
¿Qué stack tecnológico se usa en el software biotecnológico?
Un stack moderno de software biotecnológico combina una capa de aplicación web para los científicos, un motor de flujos para los pipelines, cómputo elástico en la nube o en HPC, una capa de datos gobernada para grandes archivos científicos e interfaces estándar con instrumentos y sistemas clínicos. La tabla muestra las elecciones típicas de 2026.
| Capa | Tecnologías habituales |
|---|---|
| Aplicación e interfaz | Front-ends en React o Angular; back-ends en Python (Django, FastAPI), Java o .NET |
| Motores de flujos de trabajo | Nextflow, Snakemake, WDL con Cromwell, Airflow o Prefect para los trabajos de datos |
| Computación científica | Python (NumPy, pandas, scikit-learn), R y Bioconductor, herramientas en contenedores con Docker |
| Cómputo | Servicios batch y de genómica de AWS, Google Cloud o Azure, Kubernetes, HPC gestionado con Slurm, GPU para la IA |
| Almacenamiento de datos | PostgreSQL para los metadatos; almacenamiento de objetos con tablas Parquet o Delta para grandes conjuntos de datos; formatos especializados como BAM, CRAM y Zarr |
| Estándares de instrumentos y de datos | SiLA 2, Allotrope Simple Model, SDK de los fabricantes |
| Interoperabilidad clínica | HL7 v2 y FHIR para el diagnóstico y los sistemas orientados al paciente |
| IA y MLOps | PyTorch, registros de modelos, seguimiento de experimentos, búsqueda vectorial en la literatura y en los datos de ensayos |
El stack importa menos que las decisiones de arquitectura que lo sostienen: separar los metadatos de los archivos voluminosos, mantener los pipelines declarativos y versionados y hacer que cada conjunto de datos sea direccionable por un ID. Los equipos que trasladan grandes cargas a la nube también deberían leer nuestra guía de desarrollo de software en la nube.
¿Cómo se desarrolla el software biotecnológico, paso a paso?
El software biotecnológico se construye mejor en iteraciones cortas guiadas por la ciencia: empezar con un descubrimiento dentro del laboratorio, modelar los datos antes que las pantallas, entregar pronto una primera porción funcional y añadir la validación a medida que el sistema se acerca a un uso regulado. Un proceso típico tiene siete pasos.
- Descubrimiento en el laboratorio. Acompañar a los científicos en la mesa de trabajo, mapear muestras, instrumentos, archivos y traspasos, e identificar dónde se vuelven a teclear o se pierden los datos.
- Modelo de datos y arquitectura. Definir entidades, linaje y estándares de metadatos; decidir qué comprar, qué desarrollar y dónde residen los datos.
- Alcance regulatorio. Clasificar cada componente por riesgo: solo investigación, relevante para GxP o diagnóstico. Esto decide el esfuerzo de validación.
- Porción vertical fina. Entregar un flujo de principio a fin — por ejemplo, de la recepción de muestras a los resultados de secuenciación — en un plazo de ocho a doce semanas.
- Integración y automatización. Conectar instrumentos, pipelines, ELN/LIMS y analítica; eliminar las exportaciones manuales.
- Verificación y validación. Pruebas automatizadas para todos los componentes, más documentación CSA o CSV basada en el riesgo para los regulados.
- Despliegue, formación y soporte. Migrar los datos históricos, formar a los científicos, supervisar el uso y mantener un backlog que dirija el laboratorio, no el proveedor.
La misma lógica sustenta nuestra guía de desarrollo de software sanitario a medida, adaptada aquí a los laboratorios de investigación.
¿Cuánto cuesta el desarrollo de software biotecnológico en 2026?
En 2026, el desarrollo de software biotecnológico a medida suele costar $40,000–$120,000 para un pipeline o una herramienta de datos acotada, $80,000–$200,000 para un módulo LIMS o ELN a medida, $200,000–$600,000 para una plataforma de datos de investigación multiómicos y de $300,000 a más de $1 millón para un sistema empresarial validado. El alcance, las integraciones y la validación determinan el rango.
| Tipo de proyecto | Coste típico (2026) | Plazo típico |
|---|---|---|
| Reconstrucción de un pipeline de bioinformática o herramienta de datos | $40,000–$120,000 | 2–4 meses |
| Módulo LIMS o ELN a medida, o capa de integración | $80,000–$200,000 | 4–7 meses |
| Orquestación de la automatización de laboratorio | $100,000–$300,000 | 4–9 meses |
| Plataforma de datos de investigación multiómicos | $200,000–$600,000 | 6–12 meses |
| Sistema empresarial validado para GxP | $300,000–$1,000,000+ | 9–18 meses |
Estos rangos reflejan nuestra experiencia de entrega y coinciden con las guías de proveedores publicadas en 2026, que citan unos $50,000 para herramientas de datos acotadas y hasta $500,000+ para plataformas empresariales. No incluyen licencias comerciales ni el cómputo y el almacenamiento en la nube, que en organizaciones con mucha secuenciación pueden igualar el coste de desarrollo.
Qué hace subir o bajar el coste
- Número de instrumentos y sistemas que integrar. Cada instrumento no estándar o sistema heredado añade trabajo de conector, pruebas y mantenimiento.
- Alcance de la validación. Los componentes relevantes para GxP añaden un 20–40% por documentación, pruebas y control de cambios.
- Volumen de datos y cómputo. El almacenamiento a escala de petabytes y las cargas en GPU exigen más trabajo de arquitectura y de optimización de costes.
- Migración de datos. Trasladar años de hojas de cálculo y datos de un LIMS heredado suele subestimarse.
- Modelo de equipo y ubicación. Los equipos nearshore mixtos cuestan menos que los equipos solo de EE. UU. con la misma experiencia; consulte el coste del desarrollo de software sanitario para ver referencias de tarifas.
¿Qué modelo de colaboración funciona mejor para el desarrollo de software biotecnológico?
Un equipo dedicado suele ser el mejor modelo de colaboración para el software biotecnológico, porque los requisitos de investigación cambian constantemente; los proyectos de precio cerrado solo funcionan para piezas bien definidas, como la migración de un único pipeline o un conector de instrumento. La ampliación de equipos (staff augmentation) encaja en organizaciones que ya tienen un liderazgo técnico interno sólido.
| Modelo | Cómo funciona | Ideal para |
|---|---|---|
| Equipo dedicado | Un equipo multidisciplinar estable (tech lead, ingenieros, ingeniero de datos, QA) trabaja en su backlog a largo plazo | Plataformas de datos de investigación, LIMS/ELN en evolución, herramientas de IA |
| Proyecto de precio cerrado | Alcance, plazo y precio acordados | Migraciones de pipelines, conectores, módulos validados con requisitos estables |
| Ampliación de equipos (staff augmentation) | Ingenieros individuales se incorporan a su equipo interno | Organizaciones con un responsable interno de ingeniería o de bioinformática |
| Sprint de descubrimiento | De dos a seis semanas de mapeo de flujos, arquitectura y estimación | Cualquier proyecto antes de comprometer un presupuesto grande |
Sea cual sea el modelo, exija por su parte un product owner cercano a los científicos y un backlog compartido que el laboratorio pueda ver. Nuestra comparativa de tiempo y materiales frente a precio cerrado frente a equipo dedicado explica las ventajas e inconvenientes en detalle.
¿Cómo elegir una empresa de desarrollo de software biotecnológico?
Elija una empresa de desarrollo de software biotecnológico que ya haya entregado sistemas de datos científicos, sepa hablar con sus científicos en su propio lenguaje, diseñe desde el primer día para la validación y los datos FAIR, y le entregue en plena propiedad el código, el modelo de datos y la documentación.
- Dominio del ámbito científico. Pida ejemplos de secuenciación, ensayos, registros o automatización de laboratorio, e incluya a un científico en la entrevista.
- Profundidad en ingeniería de datos. Busque experiencia con motores de flujos, archivos grandes, modelos de metadatos y control de costes en la nube, no solo con aplicaciones web.
- Entrega en entornos regulados. Pruebas de trabajo con 21 CFR Part 11, CSA/CSV, ISO 13485 o HIPAA, con ejemplos de documentos de validación.
- Historial de integraciones. Instrumentos, plataformas LIMS/ELN comerciales y sistemas clínicos que ya haya conectado.
- Nivel de seguridad. Prácticas ISO 27001 o SOC 2, SDLC seguro y un tratamiento claro de los datos procedentes de pacientes.
- Propiedad y salida. Cesión contractual de la PI, arquitectura documentada y ninguna dependencia propietaria.
- Modelo de entrega. Un equipo estable con tech lead, apoyo al product owner y solapamiento horario con sus científicos.
Nuestro marco general para elegir una empresa de desarrollo de software también se aplica; los puntos anteriores son la capa específica de biotecnología que se suma a él.
¿Cuáles son las tendencias del software biotecnológico en 2026?
Las tendencias que definen el software biotecnológico en 2026 son la IA que pasa de los pilotos al ciclo de descubrimiento, el rápido crecimiento del gasto en bioinformática y LIMS, la infraestructura ómica nativa de la nube, los datos FAIR como requisito previo de la IA y unas expectativas regulatorias más estrictas sobre las herramientas de IA y de nube.
- Crecimiento del mercado. MarketsandMarkets estima el mercado de la bioinformática en $18.63 mil millones en 2026, con un crecimiento hasta $34.41 mil millones en 2031 a una TCAC del 13.1%, y el mercado de LIMS en $3.26 mil millones en 2026, hasta alcanzar $5.84 mil millones en 2031 a una TCAC del 12.4%.
- IA «lab-in-the-loop». Los modelos de diseño de proteínas y de predicción de propiedades se conectan cada vez más directamente a experimentos automatizados, de modo que el software debe cerrar el ciclo entre predicción, experimento y reentrenamiento.
- Ómica nativa de la nube. Los servicios gestionados de genómica y los formatos de almacenamiento de objetos sustituyen a los servidores de archivos locales para los datos de secuenciación.
- Datos FAIR y ontologías. Las organizaciones invierten en estándares de metadatos y vocabularios controlados, porque los modelos de IA fallan con datos incoherentes.
- Atención regulatoria a la IA y la nube. La guía de CSA menciona ya de forma explícita las herramientas de nube y de IA/ML, y los principios de la FDA y la EMA fijan expectativas sobre la gobernanza de los modelos.
- IA generativa para científicos. Los asistentes que buscan en la literatura, los protocolos y los datos internos están llegando a los ELN; nuestra guía de desarrollo de software de IA generativa explica cómo construirlos de forma segura.
Preguntas frecuentes
¿Qué hace una empresa de desarrollo de software biotecnológico?
Una empresa de desarrollo de software biotecnológico diseña y construye software a medida para empresas biotecnológicas y laboratorios de investigación, como LIMS, cuadernos de laboratorio electrónicos, pipelines de bioinformática y secuenciación, plataformas de datos multiómicos, software de automatización de laboratorio y herramientas de IA para el descubrimiento. También integra instrumentos y plataformas existentes, apoya la validación para el uso regulado y mantiene los sistemas tras el lanzamiento.
¿Cuánto cuesta el desarrollo de software biotecnológico?
En 2026, un pipeline de bioinformática o una herramienta de datos acotada suele costar de $40,000 a $120,000, un módulo LIMS o ELN a medida de $80,000 a $200,000, una plataforma de datos de investigación multiómicos de $200,000 a $600,000 y un sistema empresarial validado para GxP de $300,000 a más de $1 millón. Las integraciones, el alcance de la validación y el volumen de datos determinan la cifra final.
¿Cuál es la diferencia entre el software biotecnológico y el software farmacéutico?
El software biotecnológico se centra en el descubrimiento y la investigación: experimentos, datos biológicos, pipelines y métodos que cambian rápido. El software farmacéutico se centra en el ciclo de vida regulado del medicamento: ensayos clínicos, fabricación GMP, calidad y farmacovigilancia. Los sistemas biotecnológicos priorizan la flexibilidad y la escala de los datos; los farmacéuticos, la validación y el control de cambios; y ambos convergen cuando los datos de investigación respaldan decisiones regulatorias.
¿Debe una empresa biotecnológica desarrollar o comprar un LIMS?
Compre un LIMS comercial cuando sus flujos sean estándar y necesite empezar rápido. Desarróllelo, o construya alrededor de un núcleo comercial, cuando sus entidades, ensayos o integraciones sean únicos y exigirían una personalización intensa. Si más de aproximadamente un tercio de los requisitos necesitan soluciones provisionales, un modelo híbrido de núcleo comercial más plataforma de datos a medida suele salir más barato a cinco años.
¿Necesita el software biotecnológico cumplir 21 CFR Part 11?
Solo cuando sus registros electrónicos respaldan actividades reguladas por la FDA, como estudios GLP, fabricación GMP, trabajo clínico o presentaciones regulatorias. Las herramientas de investigación pura no necesitan una validación formal de Part 11, pero conviene construirlas igualmente con registros de auditoría, control de acceso y prácticas de integridad de datos para poder validarlas más adelante sin reescribirlas.
¿Cuánto se tarda en desarrollar software biotecnológico?
Un pipeline o una herramienta de datos acotada suele tardar de dos a cuatro meses, un módulo LIMS o ELN a medida de cuatro a siete meses, una plataforma de datos de investigación de seis a doce meses y un sistema empresarial validado de nueve a dieciocho meses. Una primera porción funcional de un flujo suele poder entregarse en un plazo de ocho a doce semanas.
¿Qué lenguajes de programación se usan en el desarrollo de software de bioinformática?
Python y R dominan el análisis y la computación científica, con Bioconductor para la estadística genómica. Los pipelines se escriben en lenguajes de flujos como Nextflow, Snakemake o WDL, las herramientas críticas para el rendimiento suelen usar C++, Rust o Java, y las aplicaciones web para científicos suelen usar TypeScript con React o Angular sobre back-ends en Python, Java o .NET.
Publicado el 26 de octubre de 2026. Fuentes: MarketsandMarkets, Bioinformatics Market 2026–2031 (en inglés); MarketsandMarkets, LIMS Market 2026–2031 (en inglés); eCFR, 21 CFR Part 11 (en inglés); FDA, Computer Software Assurance for Production and Quality Management System Software (febrero de 2026); FDA, borrador de guía sobre el uso de IA para respaldar decisiones regulatorias sobre medicamentos y productos biológicos (enero de 2025); FDA–EMA, Guiding Principles of Good AI Practice in Drug Development (enero de 2026); guías de costes de proveedores publicadas en 2026. Los costes son rangos de mercado, no presupuestos. Este artículo es información general, no asesoramiento regulatorio.